Spring Boot Micrometer und Prometheus: Actuator-Metriken in der Produktion
Integration von Spring Boot Micrometer und Prometheus unter Spring Boot 4: Actuator-Zugriffsmodell, Scrape-Konfiguration, HTTP-Metriken, Health-Probes und Alert-Regeln.
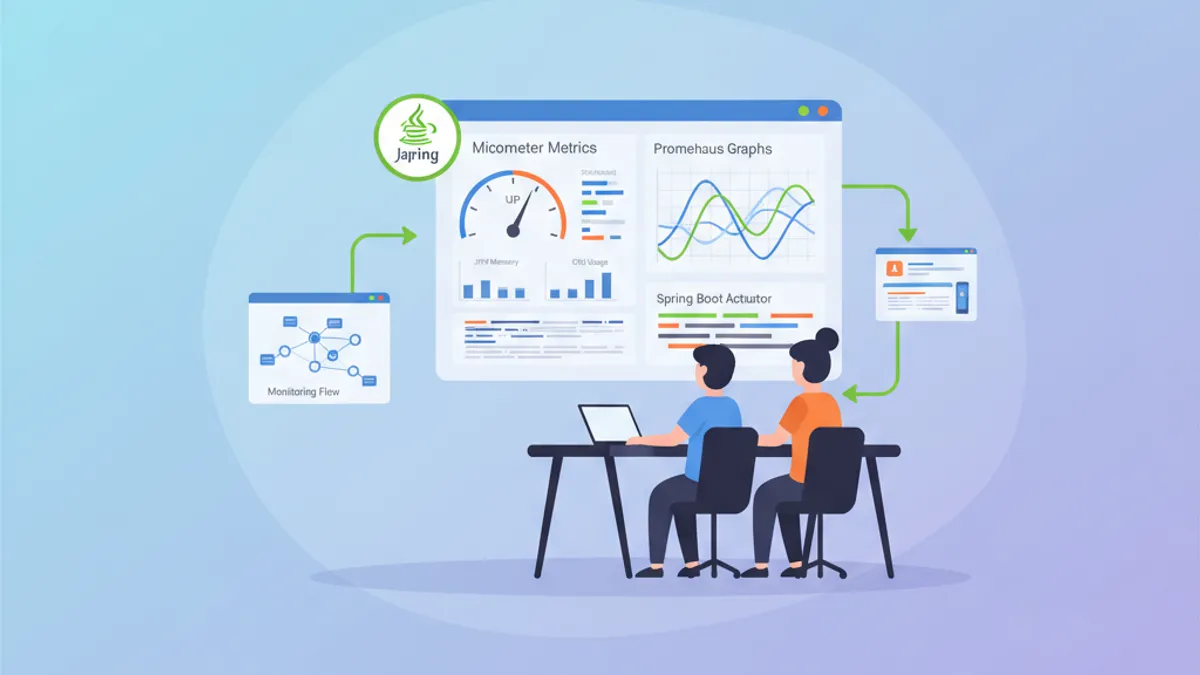
Spring Boot Actuator stellt Endpoints für Health Checks, Metriken und Diagnose bereit, und Micrometer ist die Metrik-Fassade dahinter. Mit der Abhängigkeit micrometer-registry-prometheus entsteht ein Endpoint /actuator/prometheus, den Prometheus in festen Intervallen abfragt. Die folgenden Beispiele zielen auf Spring Boot 4.1 (aktuelles GA-Release, 4.2 als Release Candidate), Micrometer 1.16 und den Prometheus Java Client 1.x.
Die Integration von Spring Boot Micrometer mit Prometheus erfolgt in drei Schritten: spring-boot-starter-actuator und micrometer-registry-prometheus hinzufügen, prometheus in management.endpoints.web.exposure.include aufnehmen und anschließend eine Prometheus-scrape_config auf /actuator/prometheus richten. JVM-, HTTP-, HikariCP- und Systemmetriken werden ohne zusätzlichen Code veröffentlicht.
Spring Boot Micrometer einrichten: Actuator und die Prometheus-Registry
Erforderliche Maven-Abhängigkeiten
Der Actuator-Starter aktiviert die Endpoints und bringt Micrometer mit. Die Prometheus-Registry formatiert jeden Meter im Prometheus-Expositionsformat. Der AspectJ-Starter wird nur für die Annotationen @Timed und @Counted benötigt.
<!-- pom.xml -->
<!-- Actuator + Micrometer + Prometheus (Spring Boot 4.x) -->
<dependencies>
    <!-- Spring Boot Actuator: monitoring endpoints, includes Micrometer -->
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-actuator</artifactId>
    </dependency>

    <!-- Micrometer Registry Prometheus (Prometheus Java client 1.x) -->
    <!-- Exposes metrics in Prometheus format at /actuator/prometheus -->
    <dependency>
        <groupId>io.micrometer</groupId>
        <artifactId>micrometer-registry-prometheus</artifactId>
    </dependency>

    <!-- AspectJ for @Timed and @Counted -->
    <!-- Spring Boot 4 renamed spring-boot-starter-aop to spring-boot-starter-aspectj -->
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-aspectj</artifactId>
    </dependency>
</dependencies>
In älteren Tutorials lauern zwei Versionsfallen. Seit Micrometer 1.13 (Spring Boot 3.3) basiert micrometer-registry-prometheus auf dem Prometheus Java Client 1.x; der alte 0.x-Code liegt im veralteten Modul micrometer-registry-prometheus-simpleclient, das die Micrometer-Dokumentation zu Prometheus nur als Übergangslösung führt. Und unter Spring Boot 4 lässt sich eine pom.xml, die noch spring-boot-starter-aop deklariert, nicht mehr auflösen: Der Migrationsleitfaden zu Spring Boot 4.0 benennt ihn in spring-boot-starter-aspectj um.
Konfiguration der Actuator-Endpoints
Standardmäßig ist über HTTP nur der Endpoint health erreichbar. Der Endpoint /actuator/prometheus existiert, sobald die Registry im Classpath liegt, liefert aber 404, bis er in die Exposure-Liste aufgenommen wird.
Spring Boot 3.4 hat die Ein/Aus-Schalter (management.endpoints.enabled-by-default, management.endpoint.<id>.enabled) durch ein Zugriffsmodell ersetzt, die alten Properties sind deprecated. Das Opt-in-Muster setzt den Standardzugriff auf none und vergibt read-only pro Endpoint:
# application.yml
# Actuator configuration for production (Spring Boot 3.4+ access model)
management:
  endpoints:
    # Every endpoint is inaccessible unless granted below
    access:
      default: none
    web:
      exposure:
        # Endpoints exposed over HTTP
        # health, info, prometheus are the minimum for monitoring
        include: health,info,prometheus,metrics,env,loggers
      base-path: /actuator
  endpoint:
    health:
      access: read-only
      show-details: when-authorized
      show-components: when-authorized
    info:
      access: read-only
    prometheus:
      access: read-only
    metrics:
      access: read-only
    env:
      access: read-only
      # Mask sensitive values for anonymous callers
      show-values: when-authorized
    loggers:
      # unrestricted allows POST to change a log level at runtime
      access: unrestricted
Exposure und Zugriff sind zwei getrennte Steuerungen. exposure.include entscheidet, ob ein Endpoint über HTTP gemappt wird; access entscheidet, was der Endpoint nach dem Mapping erlaubt. Eine Property-Datei, die noch enabled: true verwendet, funktioniert weiterhin mit einer Deprecation-Warnung, und genau das ist der Zeitpunkt für die Migration.
Die Option show-details: when-authorized zeigt Health-Details ausschließlich authentifizierten Benutzern mit der entsprechenden Rolle. Die Endpoints selbst werden über eine eigene SecurityFilterChain abgesichert:
// Securing Actuator endpoints (Spring Boot 4, Spring Security 7)
package com.example.monitoring.config;

import static org.springframework.security.web.access.IpAddressAuthorizationManager.hasIpAddress;

import org.springframework.boot.security.autoconfigure.actuate.web.servlet.EndpointRequest;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.security.config.annotation.web.builders.HttpSecurity;
import org.springframework.security.web.SecurityFilterChain;

@Configuration(proxyBeanMethods = false)
public class ActuatorSecurityConfig {

    @Bean
    SecurityFilterChain actuatorSecurityFilterChain(HttpSecurity http) throws Exception {
        return http
            .securityMatcher(EndpointRequest.toAnyEndpoint())
            .authorizeHttpRequests(auth -> auth
                // Health and info public for load balancers
                .requestMatchers(EndpointRequest.to("health", "info")).permitAll()
                // Prometheus accessible from the internal network only
                .requestMatchers(EndpointRequest.to("prometheus")).access(hasIpAddress("10.0.0.0/8"))
                // Other endpoints restricted to admins
                .anyRequest().hasRole("ACTUATOR_ADMIN")
            )
            .httpBasic(basic -> {})
            .build();
    }
}
EndpointRequest liegt seit Spring Boot 4 im Paket org.springframework.boot.security.autoconfigure.actuate.web.servlet, wie die Referenz der Actuator-Endpoints zeigt. Die Java-DSL AuthorizedUrl von authorizeHttpRequests kennt keine Methode hasIpAddress: Die IP-Regel läuft über IpAddressAuthorizationManager.hasIpAddress, verfügbar seit Spring Security 6.3.
Eigene Metriken mit Micrometer
Anwendungs-Counter, -Gauges und -Timer
Micrometer bietet verschiedene Metriktypen für unterschiedliche Anwendungsfälle. Counter messen kumulative Ereignisse, Gauges Momentanwerte und Timer die Dauer von Operationen.
// Custom business metrics service
package com.example.monitoring.metrics;

import io.micrometer.core.instrument.Counter;
import io.micrometer.core.instrument.Gauge;
import io.micrometer.core.instrument.MeterRegistry;
import io.micrometer.core.instrument.Timer;
import org.springframework.stereotype.Service;

import java.util.concurrent.atomic.AtomicInteger;
import java.util.function.Supplier;

@Service
public class OrderMetricsService {

    // Counter for orders created
    private final Counter ordersCreatedCounter;
    // Timer to measure processing duration
    private final Timer orderProcessingTimer;
    // Atomic value for pending orders gauge
    private final AtomicInteger pendingOrdersCount = new AtomicInteger(0);

    public OrderMetricsService(MeterRegistry registry) {
        // Exported as orders_created_total: the _total suffix is added by the registry
        this.ordersCreatedCounter = Counter.builder("orders.created")
            .description("Total number of orders created")
            .tag("channel", "web")
            .register(registry);

        // Timer with histogram buckets: percentiles computed server-side in PromQL
        this.orderProcessingTimer = Timer.builder("orders.processing.duration")
            .description("Order processing duration")
            .publishPercentileHistogram()
            .register(registry);

        // Gauge linked to atomic value
        // Read on each scrape
        Gauge.builder("orders.pending.count", pendingOrdersCount, AtomicInteger::get)
            .description("Number of orders pending processing")
            .register(registry);
    }

    public void recordOrderCreated() {
        ordersCreatedCounter.increment();
        pendingOrdersCount.incrementAndGet();
    }

    public void recordOrderProcessed(Runnable processingLogic) {
        // Measures execution duration
        orderProcessingTimer.record(processingLogic);
        pendingOrdersCount.decrementAndGet();
    }

    public <T> T recordOrderProcessedWithResult(Supplier<T> processingLogic) {
        return orderProcessingTimer.record(processingLogic);
    }
}
Mit der Prometheus-Registry zählen zwei Details bei der Benennung. Micrometer-Meternamen verwenden Punkte und werden in Snake Case umgewandelt (orders.processing.duration wird zu orders_processing_duration_seconds). Counter erhalten das Suffix _total automatisch, ein Counter namens orders.created.total erzeugt also nur Rauschen.
publishPercentiles(0.5, 0.95, 0.99) berechnet Perzentile innerhalb jeder JVM, und diese Werte lassen sich nicht über Instanzen hinweg aggregieren. publishPercentileHistogram() veröffentlicht Buckets, die histogram_quantile() über die gesamte Flotte aggregiert. Hinter Prometheus ist das die richtige Wahl.
Annotationen @Timed und @Counted
Um Boilerplate-Code zu vermeiden, stellt Micrometer Annotationen bereit, die Methoden über AspectJ instrumentieren.
// Automatic instrumentation with annotations
package com.example.monitoring.service;

import io.micrometer.core.annotation.Counted;
import io.micrometer.core.annotation.Timed;
import org.springframework.stereotype.Service;

@Service
public class PaymentService {

    private final PaymentValidator paymentValidator;

    public PaymentService(PaymentValidator paymentValidator) {
        this.paymentValidator = paymentValidator;
    }

    // @Timed creates a Timer
    // Measures each call and publishes count, sum, max and histogram buckets
    @Timed(
        value = "payment.process.duration",
        description = "Payment processing duration",
        histogram = true
    )
    public PaymentResult processPayment(PaymentRequest request) {
        // Call through another bean: the proxy intercepts it
        paymentValidator.validate(request);
        return executePayment(request);
    }

    // @Counted increments a counter on each call
    // Useful for discrete events
    @Counted(
        value = "payment.refunds",
        description = "Total number of refunds"
    )
    public void refundPayment(String transactionId) {
        // Refund logic
    }
}# application.yml
# Enables TimedAspect, CountedAspect and the other Micrometer annotation aspects
management:
observations:
annotations:
enabled: trueSeit Spring Boot 3.2 müssen die Beans TimedAspect und CountedAspect nicht mehr von Hand deklariert werden: management.observations.annotations.enabled=true zusammen mit spring-boot-starter-aspectj im Classpath konfiguriert sie automatisch. Die Property steht standardmäßig auf false, was die meisten Meldungen der Art "mein @Timed tut nichts" erklärt.
Die Annotationen @Timed und @Counted funktionieren nur auf public-Methoden von Spring-Beans, die über den Proxy aufgerufen werden. Ein Aufruf von einer Methode zur anderen in derselben Klasse umgeht den Proxy und wird nicht instrumentiert, und eine Annotation auf einer private-Methode wird ignoriert. Wer einen bereits instrumentierten Spring-MVC-Controller annotiert, erzeugt doppelte Observations.
Bereit für deine Spring Boot-Interviews?
Übe mit unseren interaktiven Simulatoren, Flashcards und technischen Tests.
Eigene Health-Endpoints
Geschäfts-Health-Indicators
Health Indicators prüfen den Zustand externer Abhängigkeiten und kritischer Geschäftskomponenten. Spring Boot liefert Standard-Indicators für Datenbanken, Redis und weitere gängige Dienste. In Spring Boot 4 liegt die Health-API in einem eigenen Modul spring-boot-health, und Health sowie HealthIndicator sind von org.springframework.boot.actuate.health nach org.springframework.boot.health.contributor umgezogen.
// Health indicator for payment gateway (Spring Boot 4 packages)
package com.example.monitoring.health;

import org.springframework.boot.health.contributor.Health;
import org.springframework.boot.health.contributor.HealthIndicator;
import org.springframework.stereotype.Component;
import org.springframework.web.client.RestClient;

import java.time.Duration;
import java.time.Instant;

@Component
public class PaymentGatewayHealthIndicator implements HealthIndicator {

    private final RestClient restClient;
    private final String gatewayHealthUrl;

    public PaymentGatewayHealthIndicator(RestClient.Builder restClientBuilder) {
        this.restClient = restClientBuilder.build();
        this.gatewayHealthUrl = "https://api.payment-gateway.com/health";
    }

    @Override
    public Health health() {
        Instant start = Instant.now();

        try {
            // Call gateway health endpoint
            var response = restClient.get()
                .uri(gatewayHealthUrl)
                .retrieve()
                .toBodilessEntity();

            Duration responseTime = Duration.between(start, Instant.now());

            if (response.getStatusCode().is2xxSuccessful()) {
                return Health.up()
                    .withDetail("responseTime", responseTime.toMillis() + "ms")
                    .withDetail("statusCode", response.getStatusCode().value())
                    .build();
            } else {
                return Health.down()
                    .withDetail("statusCode", response.getStatusCode().value())
                    .withDetail("reason", "Unexpected status code")
                    .build();
            }
        } catch (Exception e) {
            Duration responseTime = Duration.between(start, Instant.now());

            return Health.down()
                .withDetail("error", e.getClass().getSimpleName())
                .withDetail("message", e.getMessage())
                .withDetail("responseTime", responseTime.toMillis() + "ms")
                .build();
        }
    }
}
Dieser Indicator erscheint unter /actuator/health mit dem Namen paymentGateway: dem Bean-Namen ohne das Suffix HealthIndicator.
Health-Gruppen für Kubernetes
Spring Boot 4 aktiviert die Liveness- und Readiness-Probes standardmäßig, auf jeder Plattform und nicht nur dann, wenn Kubernetes erkannt wird. Die Gruppen /actuator/health/liveness und /actuator/health/readiness existieren ohne jede Konfiguration, und Beans für LivenessStateHealthIndicator oder ReadinessStateHealthIndicator von Hand zu deklarieren ist überflüssig. Konfiguration ist nur nötig, um einer Gruppe Komponenten hinzuzufügen oder eigene Gruppen zu definieren:
# application.yml
# Health groups configuration for Kubernetes
management:
  endpoint:
    health:
      probes:
        # true by default in Spring Boot 4
        enabled: true
        # Also serve the groups at /livez and /readyz on the main server port
        add-additional-paths: true
      group:
        # Readiness: can the application receive traffic?
        readiness:
          include: readinessState,db
        # Custom group for critical dependencies
        critical:
          include: db,paymentGateway
          show-details: when-authorized
Die Liveness-Gruppe sollte auf livenessState beschränkt bleiben. Wer eine Datenbank oder ein externes Gateway in Liveness aufnimmt, bringt Kubernetes dazu, bei einem Ausfall dieser Abhängigkeit jeden Pod neu zu starten, und macht aus einem Teilausfall einen Totalausfall. Externe Abhängigkeiten gehören in Readiness, und auch dort nur, wenn die Anwendung ohne sie keine einzige Anfrage bedienen kann.
Die Kubernetes-Probes verweisen anschließend auf dedizierte Endpoints:
# kubernetes-deployment.yml
# Kubernetes probes configuration
spec:
  containers:
    - name: order-service
      livenessProbe:
        httpGet:
          path: /livez
          port: 8080
        initialDelaySeconds: 30
        periodSeconds: 10
        failureThreshold: 3
      readinessProbe:
        httpGet:
          path: /readyz
          port: 8080
        initialDelaySeconds: 10
        periodSeconds: 5
        failureThreshold: 3
Mit add-additional-paths: true bleiben die Probes auf dem Anwendungsport, auch wenn Actuator auf einem separaten Management-Port läuft. Ein defekter Hauptserver wird so von der Probe erkannt.
Spring Boot Prometheus-Integration und Grafana
Prometheus-Scraping-Konfiguration
Prometheus sammelt Metriken durch periodische Abfrage des /actuator/prometheus-Endpoints. Die Scrape-Konfiguration definiert die Targets und den Metrikpfad, da Prometheus standardmäßig /metrics abfragt.
# prometheus.yml
# Prometheus configuration for Spring Boot
global:
  scrape_interval: 15s
  evaluation_interval: 15s

scrape_configs:
  - job_name: 'spring-boot-apps'
    metrics_path: '/actuator/prometheus'
    scrape_interval: 10s
    static_configs:
      - targets:
          - 'order-service:9090'
          - 'payment-service:9090'
          - 'inventory-service:9090'
    # Relabeling to strip the port from the instance label
    relabel_configs:
      - source_labels: [__address__]
        target_label: instance
        regex: '([^:]+):\d+'
        replacement: '${1}'

  # Kubernetes service discovery
  - job_name: 'kubernetes-pods'
    kubernetes_sd_configs:
      - role: pod
    relabel_configs:
      # Only scrape pods with annotation
      - source_labels: [__meta_kubernetes_pod_annotation_prometheus_io_scrape]
        action: keep
        regex: true
      - source_labels: [__meta_kubernetes_pod_annotation_prometheus_io_path]
        action: replace
        target_label: __metrics_path__
        regex: (.+)
Die Targets verwenden Port 9090, weil die Produktionskonfiguration weiter unten Actuator auf einen separaten Management-Port verlegt. Ohne management.server.port ist das Scrape-Target der Anwendungsport.
Standardmäßig veröffentlichte Spring Boot Actuator-Metriken
Actuator mit Micrometer stellt JVM-, Prozess-, HikariCP- und HTTP-Metriken ohne Code bereit. Diese PromQL-Abfragen decken die Metriken ab, die in der Produktion zuerst beobachtet werden:
# PromQL queries for JVM monitoring

# Heap memory usage, summed across heap pools
sum by (instance) (jvm_memory_used_bytes{area="heap"})

# Heap usage percentage
sum by (instance) (jvm_memory_used_bytes{area="heap"})
  / sum by (instance) (jvm_memory_max_bytes{area="heap"}) * 100

# Live threads
jvm_threads_live_threads

# Garbage collection: seconds spent paused per second
rate(jvm_gc_pause_seconds_sum[5m])

# GC pauses per minute
rate(jvm_gc_pause_seconds_count[1m]) * 60

# CPU used by the JVM process
process_cpu_usage

# Active database connections
hikaricp_connections_active

# Connection pool utilization
hikaricp_connections_active / hikaricp_connections_max * 100
jvm_memory_used_bytes{area="heap"} liefert eine Zeitreihe pro Speicherpool (Eden, Survivor, Old Gen bei G1). Wer ohne sum by (instance) durch das Maximum teilt, erhält Verhältnisse pro Pool, die in einem Dashboard falsch aussehen.
Ein MeterBinder-Bean ergänzt Gauges auf Anwendungsebene, die von den Standards nicht abgedeckt werden:
// Additional JVM metrics
package com.example.monitoring.metrics;

import io.micrometer.core.instrument.Gauge;
import io.micrometer.core.instrument.MeterRegistry;
import io.micrometer.core.instrument.binder.MeterBinder;
import org.springframework.stereotype.Component;

import java.lang.management.ManagementFactory;
import java.lang.management.OperatingSystemMXBean;

@Component
public class CustomJvmMetrics implements MeterBinder {

    @Override
    public void bindTo(MeterRegistry registry) {
        OperatingSystemMXBean osBean = ManagementFactory.getOperatingSystemMXBean();

        // System load average
        Gauge.builder("system.load.average", osBean, OperatingSystemMXBean::getSystemLoadAverage)
            .description("System load average over 1 minute")
            .register(registry);

        // Available processors count
        Gauge.builder("system.cpu.count", osBean, OperatingSystemMXBean::getAvailableProcessors)
            .description("Number of available processors")
            .register(registry);

        // Application uptime
        Gauge.builder("application.uptime.seconds",
                ManagementFactory.getRuntimeMXBean(),
                bean -> bean.getUptime() / 1000.0)
            .description("Application uptime in seconds")
            .register(registry);
    }
}
system.cpu.count und process.uptime werden bereits von den eingebauten Bindern von Micrometer veröffentlicht. Das Beispiel zeigt das Muster, ein echter Binder sollte nur registrieren, was den Standards fehlt.
Sofort einsetzbare Grafana-Dashboards
Grafana bietet Community-Dashboards für Spring Boot, die mit den Standard-Actuator-Metriken arbeiten. Ein selbst geschriebenes Dashboard verwendet die Panel-Typen timeseries und stat:
{
  "annotations": {
    "list": []
  },
  "panels": [
    {
      "title": "Request Rate",
      "type": "timeseries",
      "targets": [
        {
          "expr": "sum by (method, uri, status) (rate(http_server_requests_seconds_count{application=\"$application\"}[5m]))",
          "legendFormat": "{{method}} {{uri}} - {{status}}"
        }
      ]
    },
    {
      "title": "Response Time P99",
      "type": "timeseries",
      "targets": [
        {
          "expr": "histogram_quantile(0.99, sum by (le, method, uri) (rate(http_server_requests_seconds_bucket{application=\"$application\"}[5m])))",
          "legendFormat": "{{method}} {{uri}}"
        }
      ]
    },
    {
      "title": "Error Rate",
      "type": "stat",
      "targets": [
        {
          "expr": "sum(rate(http_server_requests_seconds_count{application=\"$application\",status=~\"5..\"}[5m])) / sum(rate(http_server_requests_seconds_count{application=\"$application\"}[5m])) * 100"
        }
      ]
    }
  ]
}
Viele aus älteren Tutorials kopierte Dashboards nutzen noch die Panel-Typen graph und singlestat. Singlestat wurde in Grafana 8 entfernt, und Grafana 12 hat die AngularJS-Unterstützung vollständig gestrichen. Diese Panels werden daher erst nach der Migration zu timeseries und stat dargestellt.
Community-Dashboard importieren: Grafana > Dashboards > New > Import, dann ID 4701 (JVM Micrometer) oder 12900 (SpringBoot APM) eingeben. Nach dem Import die Panel-Typen prüfen: Ältere Revisionen von Community-Dashboards können noch Angular-Panels enthalten, die Grafana 12 migrieren muss.
Alerting mit Prometheus
Wesentliche Alert-Regeln
Prometheus-Alert-Regeln lösen Benachrichtigungen aus, sobald Metriken kritische Schwellenwerte überschreiten.
# alerting-rules.yml
# Alert rules for Spring Boot applications
groups:
  - name: spring-boot-alerts
    rules:
      # Alert if application is down
      - alert: ApplicationDown
        expr: up{job="spring-boot-apps"} == 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "Application {{ $labels.instance }} is down"
          description: "{{ $labels.instance }} has been down for more than 1 minute"

      # Alert on HTTP error rate
      - alert: HighErrorRate
        expr: |
          sum(rate(http_server_requests_seconds_count{status=~"5.."}[5m])) by (application)
          /
          sum(rate(http_server_requests_seconds_count[5m])) by (application)
          > 0.05
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "High error rate on {{ $labels.application }}"
          description: "Error rate is {{ $value | humanizePercentage }}"

      # Alert on P99 latency, aggregated per application
      - alert: HighLatency
        expr: |
          histogram_quantile(0.99,
            sum by (le, application) (rate(http_server_requests_seconds_bucket[5m]))
          ) > 2
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "High latency on {{ $labels.application }}"
          description: "P99 latency is {{ $value | humanizeDuration }}"

      # Heap memory alert
      - alert: HighHeapUsage
        expr: |
          sum by (instance) (jvm_memory_used_bytes{area="heap"})
          / sum by (instance) (jvm_memory_max_bytes{area="heap"})
          > 0.85
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "High heap memory usage on {{ $labels.instance }}"
          description: "Heap usage is at {{ $value | humanizePercentage }}"

      # Database connection pool exhausted alert
      - alert: DatabaseConnectionPoolExhausted
        expr: |
          hikaricp_connections_active
          / hikaricp_connections_max
          > 0.9
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "Database connection pool nearly exhausted"
          description: "{{ $value | humanizePercentage }} of connections in use"

      # Excessive GC alert
      - alert: HighGCPause
        expr: |
          rate(jvm_gc_pause_seconds_sum[5m])
          / rate(jvm_gc_pause_seconds_count[5m])
          > 0.5
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "High GC pause time"
          description: "Average GC pause is {{ $value | humanizeDuration }}"
Diese Alerts decken die häufigsten Produktionsprobleme ab: Verfügbarkeit, Performance und Ressourcen. Die Regel HighLatency braucht sum by (le, ...): Ohne diese Aggregation berechnet histogram_quantile ein P99 pro Zeitreihe (pro URI, Methode und Status), und ein einziger langsamer Endpoint mit drei Aufrufen löst den Alert aus.
HTTP-Metriken und Datenbank-Metriken in Spring Boot
Automatische Instrumentierung von HTTP-Anfragen
Spring Boot instrumentiert jede eingehende Spring-MVC- und WebFlux-Anfrage über die Observation API und veröffentlicht den Timer http.server.requests mit den Tags method, uri, status, outcome und exception.
# application.yml
# HTTP metrics configuration
management:
  metrics:
    distribution:
      # Histogram buckets for server-side percentiles
      percentiles-histogram:
        http.server.requests: true
      # SLO buckets: count requests faster than each boundary
      slo:
        http.server.requests: 100ms, 500ms, 1s, 2s
    tags:
      # Common tags added to every meter
      application: ${spring.application.name}
      environment: ${spring.profiles.active:default}
Die Interfaces WebMvcTagsContributor und WebMvcTagsProvider, die in vielen Beispielen auftauchen, wurden in Spring Boot 3.0 entfernt. Eigene Tags werden heute durch Erweitern von DefaultServerRequestObservationConvention hinzugefügt, wie die Referenz der Spring Boot-Metriken dokumentiert:
// Adds custom tags to http.server.requests (Spring Boot 3.0+)
package com.example.monitoring.config;

import io.micrometer.common.KeyValue;
import io.micrometer.common.KeyValues;
import org.springframework.http.server.observation.DefaultServerRequestObservationConvention;
import org.springframework.http.server.observation.ServerRequestObservationContext;
import org.springframework.stereotype.Component;

import jakarta.servlet.http.HttpServletRequest;

@Component
public class TenantObservationConvention extends DefaultServerRequestObservationConvention {

    @Override
    public KeyValues getLowCardinalityKeyValues(ServerRequestObservationContext context) {
        HttpServletRequest request = context.getCarrier();
        String userId = request.getHeader("X-User-Id");
        String tenantId = request.getHeader("X-Tenant-Id");

        // Keep the default tags and add two bounded ones
        return super.getLowCardinalityKeyValues(context).and(
            KeyValue.of("user.type", userId != null ? "authenticated" : "anonymous"),
            KeyValue.of("tenant", tenantId != null ? tenantId : "default")
        );
    }
}
Nur Key-Values mit niedriger Kardinalität werden zu Prometheus-Labels. Ein Tag tenant ist bei einigen Dutzend Mandanten akzeptabel und wird bei Tausenden zum Kardinalitätsproblem. Werte mit hoher Kardinalität (Benutzer-ID, Bestell-ID) gehören in getHighCardinalityKeyValues, das nur Traces speist. Die Tracing-Seite der Observation API wird in Spring Boot Observability mit OpenTelemetry ausführlich behandelt.
HikariCP- und SQL-Query-Metriken
Die Pool-Metriken von HikariCP werden automatisch mit dem Präfix hikaricp und dem Pool-Namen als Tag bereitgestellt, zusätzlich zu den generischen Gauges jdbc.connections. Ein gesetzter Pool-Name macht den Tag lesbar:
# application.yml
# HikariCP pool configuration
spring:
  datasource:
    hikari:
      # Becomes the "pool" tag on hikaricp_* metrics
      pool-name: OrderServicePool
      maximum-pool-size: 20
      minimum-idle: 5
      connection-timeout: 30000
      idle-timeout: 600000
      max-lifetime: 1800000
Die Zeitmessung einzelner Queries deckt Spring Boot nicht ab. Das Projekt datasource-micrometer umhüllt die DataSource und erzeugt eine Observation pro Verbindung, Query und Result Set, was sowohl Metriken als auch Trace-Spans liefert. Die Linie 2.x zielt auf Spring Boot 4, die Linie 1.x auf Spring Boot 3:
<!-- pom.xml -->
<!-- JDBC observations: 2.x for Spring Boot 4, 1.x for Spring Boot 3 -->
<dependency>
    <groupId>net.ttddyy.observation</groupId>
    <artifactId>datasource-micrometer-spring-boot</artifactId>
    <version>2.0.1</version>
</dependency>
Das ersetzt den manuellen Ansatz, die DataSource mit einem ProxyDataSourceBuilder und einem selbst geschriebenen Listener zu umhüllen. Dieser Ansatz umging die DataSource-Autokonfiguration von Spring Boot und musste bei jedem Boot-Upgrade nachgezogen werden. Langsame Queries deuten meist auf ein N+1-Muster hin, das in Lösungen für das N+1-Problem in Spring Data JPA behandelt wird.
Best Practices für die Produktion
Kardinalität von Metriken
Übermäßige Kardinalität verschlechtert die Performance von Prometheus. Jede einzigartige Tag-Kombination erzeugt eine eigene Zeitreihe.
// AVOID: unbounded cardinality
package com.example.monitoring.antipattern;

@Service
public class AntiPatternHighCardinality {

    private final MeterRegistry registry;

    // BAD: userId creates one series per user
    public void trackUserAction(String userId, String action) {
        Counter.builder("user.actions")
            .tag("userId", userId)  // Millions of possible values
            .tag("action", action)
            .register(registry)
            .increment();
    }
}// Controlled cardinality
package com.example.monitoring.bestpractice;
@Service
public class GoodPracticeCardinality {
private final MeterRegistry registry;
// GOOD: user category instead of ID
public void trackUserAction(User user, String action) {
Counter.builder("user.actions")
.tag("userType", user.getSubscriptionType()) // FREE, PREMIUM, ENTERPRISE
.tag("action", action)
.register(registry)
.increment();
}
// GOOD: let a timer histogram bucket durations
public void trackResponseTime(long responseTimeMs) {
Timer.builder("response.time")
.publishPercentileHistogram()
.register(registry)
.record(Duration.ofMillis(responseTimeMs));
}
}Ein Timer mit Histogramm-Buckets beantwortet Latenzfragen besser als ein Counter mit einem selbst gebauten bucket-Tag: PromQL kann aus den Buckets jedes beliebige Perzentil berechnen, und die Bucket-Grenzen bleiben über alle Services hinweg einheitlich.
Produktionsreife Konfiguration
# application-production.yml
# Production configuration (Spring Boot 4)
management:
  server:
    # Separate port for management endpoints, not exposed publicly
    port: 9090
  endpoints:
    access:
      default: none
    web:
      exposure:
        include: health,info,prometheus
  endpoint:
    health:
      access: read-only
      show-details: when-authorized
      probes:
        add-additional-paths: true
    info:
      access: read-only
    prometheus:
      access: read-only
  observations:
    annotations:
      enabled: true
  metrics:
    distribution:
      percentiles-histogram:
        http.server.requests: true
      minimum-expected-value:
        http.server.requests: 1ms
      maximum-expected-value:
        http.server.requests: 30s
    tags:
      application: ${spring.application.name}
      environment: production
      version: ${app.version:unknown}
Mit access.default: none sind Endpoints wie env, beans, configprops und mappings unzugänglich, ohne sie einzeln aufzulisten. management.prometheus.metrics.export.enabled steht standardmäßig auf true, und eine step-Einstellung hat bei Prometheus keine Wirkung: Es ist eine Pull-basierte Registry, das Scrape-Intervall wird in prometheus.yml festgelegt.
Häufige Fehler mit Actuator und Prometheus
| Symptom | Ursache | Lösung |
|---|---|---|
/actuator/prometheus liefert 404 | Endpoint nicht in der Exposure-Liste oder Registry fehlt | prometheus zu management.endpoints.web.exposure.include hinzufügen und prüfen, ob micrometer-registry-prometheus im Classpath liegt |
| Prometheus-Target meldet "server returned HTTP status 401" | Spring Security schützt alle Endpoints außer health | prometheus für das Netz des Scrapers öffnen oder Basic Auth in der Scrape-Konfiguration hinterlegen |
@Timed erzeugt keine Metrik | management.observations.annotations.enabled steht standardmäßig auf false, oder AspectJ fehlt | Property auf true setzen und spring-boot-starter-aspectj hinzufügen |
spring-boot-starter-aop nach dem Upgrade nicht gefunden | In Spring Boot 4 umbenannt | spring-boot-starter-aspectj verwenden |
Import von Health oder HealthIndicator schlägt unter Boot 4 fehl | Paket nach org.springframework.boot.health.contributor verschoben | Imports anpassen |
Deprecation-Warnungen zu management.endpoint.*.enabled | Ein/Aus-Modell in Spring Boot 3.4 ersetzt | management.endpoints.access.default und management.endpoint.<id>.access verwenden |
| Perzentile im Dashboard weichen stark von der Realität ab | Werte von publishPercentiles über Pods gemittelt | publishPercentileHistogram() und histogram_quantile() verwenden |
Interviewfragen zu Spring Boot Micrometer
Actuator kommt in den meisten Spring Boot-Interviews für Mid-Level- und Senior-Positionen zur Sprache. Die Antworten, die ein erfahrenes Profil von einem Junior unterscheiden:
- Unterschied zwischen Liveness und Readiness: Liveness sagt Kubernetes, den Pod neu zu starten, Readiness sagt ihm, keinen Traffic mehr dorthin zu leiten. Wer die Datenbank in die Liveness-Gruppe aufnimmt, hat damit noch keinen Ausfall erlebt.
- Warum Micrometer und nicht direkt der Prometheus-Client: Micrometer ist eine Fassade. Derselbe Code mit
CounterundTimerexportiert nach Prometheus, Datadog oder OTLP, indem nur eine Abhängigkeit getauscht wird, und die Instrumentierung von Spring selbst (HTTP, JDBC-Pool, Caches) ist gegen Micrometer geschrieben. - Clientseitige Perzentile oder Histogramme: Clientseitige Perzentile lassen sich nicht über Instanzen aggregieren, Histogramme schon. Das ist die häufigste Fangfrage zum Thema.
- Was Kardinalität bedeutet und wie sie Prometheus lahmlegt: eine Zeitreihe pro eindeutiger Label-Kombination; ein Tag mit der Benutzer-ID multipliziert den Speicherverbrauch mit der Anzahl der Benutzer.
- Wie Actuator abgesichert wird: Exposure begrenzen, Zugriffsstufen setzen, Management auf einem separaten Port betreiben und mit einer eigenen
SecurityFilterChainschützen.
Weitere Fragen dieser Art sind im Modul Spring Boot Actuator Interviewfragen gesammelt.
Quellen
- Spring Boot 4.0 Migration Guide:
spring-boot-starter-aopinspring-boot-starter-aspectjumbenannt, Probes standardmäßig aktiv, neues Modulspring-boot-health - Spring Boot 3.4 Release Notes:
enabled-by-defaultundendpoint.<id>.enabledzugunsten des Zugriffsmodells deprecated - Referenz der Spring Boot Actuator-Endpoints: Access-Properties, Paket von
EndpointRequest, Health Indicators inorg.springframework.boot.health.contributor, Probe-Gruppen und zusätzliche Pfade - Referenz der Spring Boot-Metriken:
DefaultServerRequestObservationConvention, HikariCP- undjdbc.connections-Metriken, Deprecation von simpleclient - Referenz zu Spring Boot Observability:
management.observations.annotations.enabledund die AspectJ-Voraussetzung - Micrometer-Dokumentation zu Prometheus: Registry auf Basis des Prometheus Java Client 1.x und das Legacy-Modul simpleclient
- datasource-micrometer auf GitHub: 2.x für Spring Boot 4, 1.x für Spring Boot 3
- Grafana: Entfernung von AngularJS in Grafana 12: Panels Graph und Singlestat durch Time series und Stat ersetzt
- Spring Boot Releases: 4.1.2 als aktuelles GA-Release, 4.2.0-RC1 als Pre-Release
Was von Spring Boot Micrometer und Prometheus bleibt
- Drei Schritte zu einem funktionierenden Scrape: Actuator-Starter,
micrometer-registry-prometheus,prometheusin der Exposure-Liste - Zugriffsmodell seit 3.4:
management.endpoints.access.default: noneplusread-onlypro Endpoint ersetzt die veraltetenenabled-Flags - Änderungen in Spring Boot 4:
spring-boot-starter-aspectj, Health-API inorg.springframework.boot.health.contributor,EndpointRequestinorg.springframework.boot.security.autoconfigure.actuate.web.servlet, Probes standardmäßig aktiv - Annotationen brauchen einen Schalter:
management.observations.annotations.enabled=true, kein manuellesTimedAspect-Bean - HTTP-Tags über die Observation API:
DefaultServerRequestObservationConventionerweitern, Labels mit niedriger Kardinalität halten - Histogramme statt Client-Perzentilen:
publishPercentileHistogram()undsum by (le)in jedemhistogram_quantile - Liveness bleibt lokal: Externe Abhängigkeiten gehören in Readiness oder eine eigene Gruppe, nie in Liveness
Mit diesen Standards liefert ein Spring Boot 4-Service Metriken, die sich korrekt über Pods aggregieren lassen, Endpoints, die nichts ins öffentliche Netz preisgeben, und Alerts, die bei echten Vorfällen auslösen statt bei einer einzelnen langsamen URI.
Fang an zu üben!
Teste dein Wissen mit unseren Interview-Simulatoren und technischen Tests.
Findest du den Bug in Spring Boot?
Ein echter Codeausschnitt, ein versteckter Bug, ein Versuch pro Tag. Zum Ausprobieren ohne Konto.

Geschrieben von
Anthony Fillion-MailletGründer von SharpSkill
Seit über 10 Jahren Fullstack-Entwickler. Er leitet SharpSkill und verantwortet alles, was hier erscheint.
Aktualisiert am 26. Oktober 2026
Tags
Teilen
Verwandte Artikel
Strukturiertes Logging in Spring Boot 2026: JSON-Logs für Produktion mit Logback und OpenTelemetry
Vollständiger Leitfaden zu Spring Boot 4.x strukturiertem Logging. Native JSON-Unterstützung, OpenTelemetry Starter, MDC-Tracing und ELK-Stack-Integration für Produktions-Observability.
Freelance Java Spring Boot Entwickler Jobs 2026: Wo Aufträge finden, Tagessätze und Vorbereitung
Freelance Java Spring Boot Entwickler Aufträge 2026: aktuelle Tagessätze (Median 440 EUR), beste Plattformen für Projekte in Deutschland und Europa, Interview-Vorbereitung.
Java Spring Boot Entwickler Jobs 2026: Wo suchen, Gehaltsrahmen, wie vorbereiten
606 aktive Spring Boot Positionen im September 2026. Dieser Artikel analysiert Gehaltsdaten, Remote-Anteile und Interviewvorbereitung für Java Spring Boot Entwickler.