RAG und LLMs 2026: Retrieval-Augmented Generation im Data-Science-Interview
Retrieval-Augmented Generation (RAG) erklärt für Data-Science-Interviews 2026. Behandelt Vektordatenbanken, Chunking-Strategien, Embedding-Modelle, Agentic RAG, Graph RAG und produktionsreife Pipeline-Architektur.
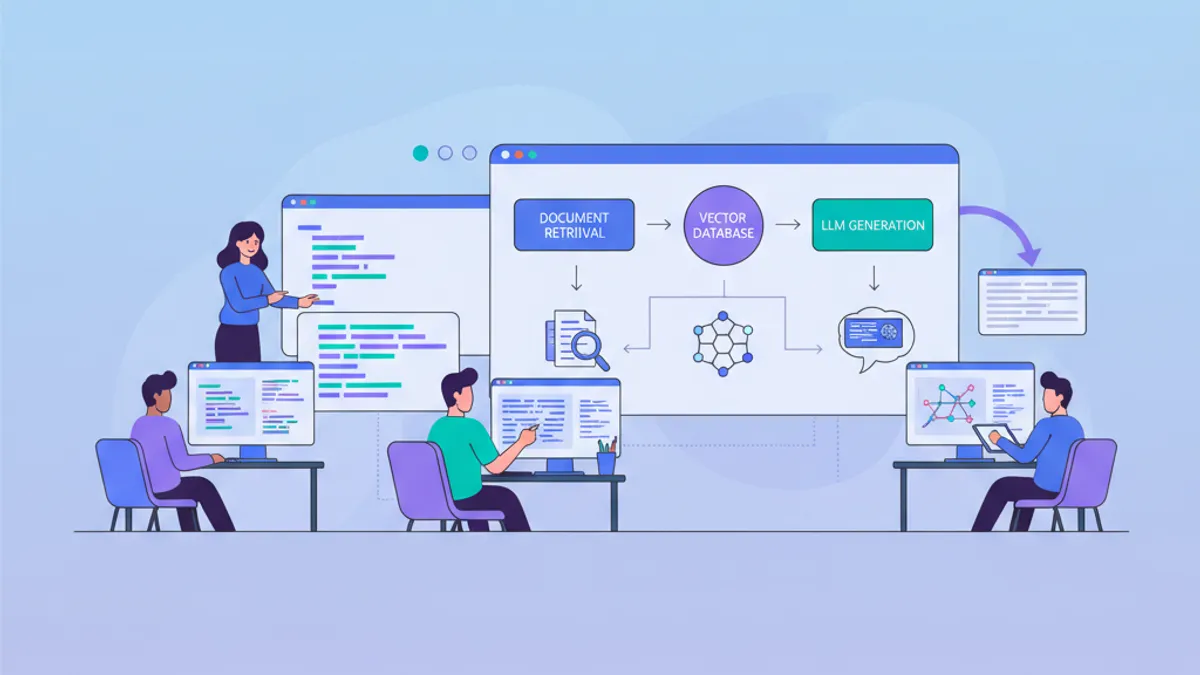
Retrieval-Augmented Generation (RAG) hat sich als Standardarchitektur für die Verankerung von LLM-Ausgaben in faktischen, aktuellen Daten etabliert. Bei Data-Science- und KI-Engineering-Interviews im Jahr 2026 erscheinen RAG-Fragen mittlerweile neben traditionellen ML-Themen und testen sowohl systemisches Designdenken als auch praktische Implementierungsfähigkeiten.
Retrieval-Augmented Generation kombiniert ein Retrieval-System (Vektorsuche über eine Wissensbasis) mit einem LLM-Generator, sodass das Modell Antworten aus echten Dokumenten generiert, anstatt sich auf auswendig gelerntes Trainingswissen zu verlassen.
Die RAG-Pipeline: End-to-End-Architektur
Ein RAG-System arbeitet in zwei Phasen: einer Offline-Indexierungsphase, die die Wissensbasis aufbaut, und einer Online-Abfragephase, die relevanten Kontext abruft und eine Antwort generiert.
Während der Indexierung durchlaufen Rohdokumente Bereinigung, Chunking und Embedding, bevor sie in einer Vektordatenbank gespeichert werden. Bei der Inferenz folgt die Benutzeranfrage demselben Embedding-Pfad, und die Nearest-Neighbor-Suche ruft die relevantesten Chunks ab. Diese Chunks werden Teil des LLM-Prompts und verankern die generierte Antwort im Quellmaterial.
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
Diese Pipeline deckt den grundlegenden RAG-Ablauf ab: Chunking, Embedding, Speichern, Abrufen, Generieren. Der Parameter search_type="mmr" stellt sicher, dass abgerufene Chunks sowohl relevant als auch divers sind, wodurch Redundanz im Kontextfenster reduziert wird.
Chunking-Strategien mit echtem Einfluss
Chunking bestimmt die Retrieval-Qualität mehr als jede andere Komponente. Schlechtes Chunking bedeutet, dass der Retriever Fragmente zurückgibt, denen entweder der Kontext fehlt oder die das Signal mit irrelevantem Inhalt verwässern.
Drei Chunking-Ansätze dominieren Produktionssysteme im Jahr 2026:
Fixed-Size Chunking teilt Text bei einer festen Token-Anzahl (typischerweise 256 bis 512 Token) mit Überlappung auf. Einfach zu implementieren, aber Sätze und Gedanken werden mitten im Text getrennt.
Semantisches Chunking erkennt Themenwechsel, indem die Embedding-Ähnlichkeit zwischen aufeinanderfolgenden Sätzen gemessen wird. Wenn die Ähnlichkeit unter einen Schwellenwert fällt, beginnt ein neuer Chunk. Jeder Chunk trägt eine kohärente Idee anstelle eines willkürlichen Textausschnitts.
Late Chunking wendet das Transformer-Modell zuerst auf das gesamte Dokument an, produziert kontextuelle Token-Embeddings und teilt dann in Chunks auf. Dadurch bleiben Langstrecken-Abhängigkeiten erhalten, die traditionelles Chunking zerstört.
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
Der zentrale Interview-Aspekt: Die Chunk-Größe ist ein Precision-Recall-Tradeoff. Kleine Chunks (100 Token) verbessern die Retrieval-Präzision, fragmentieren aber den Kontext. Große Chunks (1000 Token) bewahren den Kontext, verwässern aber die Embedding-Spezifität. Die meisten Produktionssysteme liegen bei 256 bis 512 Token mit 10 bis 20% Überlappung.
Vektordatenbanken und Embedding-Modelle in der Produktion
Die Vektordatenbank speichert Embeddings und unterstützt schnelle Approximate-Nearest-Neighbor (ANN)-Suchen. Die Wahl der richtigen Kombination aus Embedding-Modell und Vektordatenbank beeinflusst direkt die Retrieval-Latenz und Genauigkeit.
Embedding-Modelle im Jahr 2026 haben sich um einige leistungsstarke Optionen konsolidiert. OpenAIs text-embedding-3-large (3072 Dimensionen) und Open-Source-Alternativen wie bge-m3 von BAAI oder Coheres embed-v4 bieten starkes mehrsprachiges Retrieval. Das MTEB-Leaderboard bleibt der Standard-Benchmark für den Vergleich der Embedding-Qualität. text-embedding-3-large unterstützt Matryoshka Representation Learning, das eine Dimensionsreduzierung (auf 1024 oder 256) mit minimalem Qualitätsverlust ermöglicht und die Speicherkosten erheblich senkt.
Der Vektordatenbank-Markt hat sich 2026 konsolidiert. Vier Produkte decken den überwiegenden Anteil der RAG-Produktionsworkloads ab:
| Datenbank | Indexierung | Verwaltet | Stärke |
|---|---|---|---|
| Pinecone | Proprietär | Ja | Zero-Ops, integrierte Inferenz, Hybridsuche |
| Weaviate | HNSW | Ja/Self | Native BM25 + Dense-Fusion in einer Abfrage |
| Qdrant | HNSW | Ja/Self | Rust-Performance, Payload-Filterung, bestes kostenloses Tier |
| pgvector | IVF, HNSW | Self | PostgreSQL-Integration für bestehende Stacks |
Für Interview-Diskussionen ist das Verständnis des HNSW-Algorithmus (Hierarchical Navigable Small World) entscheidend: Er baut einen mehrschichtigen Graphen auf, in dem jeder Knoten mit seinen nächsten Nachbarn verbunden ist, und ermöglicht O(log n)-Suche auf Kosten eines höheren Speicherverbrauchs.
Der Kosten-Kipppunkt liegt bei 60 bis 80 Millionen Abfragen pro Monat. Darüber unterbietet selbstgehostetes Qdrant oder Weaviate auf Fixed-Cost-Infrastruktur konsequent Managed Pinecone Serverless um das 3- bis 10-fache.
Bereit für deine Data Science & ML-Interviews?
Übe mit unseren interaktiven Simulatoren, Flashcards und technischen Tests.
Hybrides Retrieval: Dense und Sparse kombinieren
Reine Vektorsuche versagt bei exakten Keyword-Matches und seltenen Begriffen. Reine lexikalische Suche (BM25) verpasst semantische Ähnlichkeit. Hybrides Retrieval kombiniert beide Ansätze, und im Jahr 2026 ist dies der Standard für produktive RAG-Systeme.
Das Standardmuster verwendet Reciprocal Rank Fusion (RRF), um gerankte Ergebnisse beider Retriever zusammenzuführen:
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
Hybrides Retrieval löst das "Vocabulary Mismatch"-Problem, bei dem ein Nutzer nach "Kündigung eines Abonnements" fragt, aber das relevante Dokument den Begriff "Kontobeendigungsrichtlinie" verwendet. BM25 erfasst den exakten Begriffsüberlapp, während die Vektorsuche die semantische Beziehung erkennt.
Reranking: Der zweistufige Filter
Retrieval liefert Kandidaten. Reranking sortiert sie nach tatsächlicher Relevanz. Cross-Encoder-Reranker wie Cohere Rerank oder bge-reranker-v2.5-gemma2-lightweight bewerten jedes Query-Dokument-Paar gemeinsam und liefern deutlich genauere Relevanzscores als die Bi-Encoder-Ähnlichkeit.
Die zweistufige Retrieval-Pipeline (breiter First-Stage-Recall mit Top 50 bis 100 Kandidaten via Vektor + BM25, dann präzises Reranking auf Top 5 bis 10 für den Prompt) ist der Standard in Produktionssystemen. Dies hält die Latenz handhabbar: Die erste Stufe nutzt schnelle ANN-Suche, während der teure Cross-Encoder nur eine kleine Kandidatenmenge verarbeitet.
Cross-Encoder sind genauer als Bi-Encoder, da sie Query und Dokument gemeinsam durch alle Transformer-Schichten verarbeiten. Bi-Encoder betten sie unabhängig voneinander ein und verlieren dabei feinkörnige Interaktionssignale. Der Kompromiss ist die Geschwindigkeit: Cross-Encoder können nicht vorindiziert werden.
Adaptives RAG: Queries zur richtigen Pipeline routen
Nicht jede Abfrage benötigt dieselbe Retrieval-Komplexität. Adaptives RAG trainiert einen kleinen Klassifikator, der jede Frage zum optimalen Pfad routet:
- Kein Retrieval für einfache faktische Fragen, die das Modell bereits kennt
- Einstufiges Retrieval für moderate Fragen
- Mehrstufiges iteratives Retrieval für komplexe Schlussfolgerungen
Dieses Muster balanciert Kosten und Genauigkeit über gemischte Workloads hinweg. Ein Produktionssystem, das 100.000 Abfragen pro Tag verarbeitet, kann die Inferenzkosten um 40% senken, indem einfache Fragen von teuren mehrstufigen Pipelines ferngehalten werden.
Der Klassifikator selbst kann ein kleines feingetunte Modell oder ein Zero-Shot-Prompt sein, der fragt: "Benötigt diese Frage externes Wissen, um akkurat beantwortet zu werden?"
Spekulatives RAG: Latenz gegen Geschwindigkeit tauschen
Spekulatives RAG führt Retrieval parallel zu einer schnellen Draft-Generierung aus. Wenn der Entwurf hohe Konfidenz zeigt (gemessen durch Logprob), wird der Retrieval-Schritt komplett übersprungen. Bei niedriger Konfidenz wird der abgerufene Kontext mit dem Entwurf zusammengeführt und eine Neugenerierung erfolgt.
Dieser Ansatz reduziert die durchschnittliche Latenz bei hochkonfidenten Abfragen um 30 bis 40%. Er funktioniert am besten für Echtzeit-Chatbots, Autocomplete-Vorschläge und Kundenservice-Systeme, bei denen die Antwortzeit wichtiger ist als erschöpfende Quellenrecherche bei jeder Anfrage.
Der Kompromiss: Spekulatives RAG liefert gelegentlich Antworten ohne Verankerung, wenn das Modell überkonfident ist. Produktionssysteme kombinieren es mit Konfidenz-Kalibrierung und Fallback zu vollem Retrieval, wenn die Unsicherheit einen Schwellenwert überschreitet.
Agentic RAG: Über Single-Shot-Retrieval hinaus
Naives RAG ruft einmal ab und generiert. Agentic RAG behandelt das LLM als Reasoning-Agenten, der entscheidet, wann abgerufen wird, was abgerufen wird und ob der abgerufene Kontext ausreichend ist.
Im Jahr 2026 ist Agentic RAG das dominierende Muster für komplexe Abfragen, die mehrstufiges Reasoning erfordern. Der Agent kann:
- Selbstbewertung: Evaluieren, ob abgerufene Dokumente die Frage beantworten
- Neuformulierung: Die Suchanfrage umformulieren, wenn die ersten Ergebnisse unzureichend sind
- Routing: Zwischen verschiedenen Wissensquellen wählen (Vektor-DB, SQL-Datenbank, API)
- Verifizierung: Fakten über mehrere abgerufene Passagen kreuzprüfen
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
Dieses Muster (Abrufen, Bewerten, optional Umformulieren und Wiederholen) ist als Corrective RAG (CRAG) bekannt. LangChains AgentExecutor ist ab 2026 veraltet; neue Projekte sollten create_react_agent() für vorgefertigte Muster oder LangGraphs StateGraph für benutzerdefinierte Orchestrierung verwenden. Für eine tiefere Behandlung von LangChain-Mustern für Data Scientists siehe den dedizierten Artikel.
Graph RAG: Strukturierte Wissensabfrage
Graph RAG extrahiert Entitäten und Beziehungen aus Dokumenten in einen Wissensgraphen und fragt dann sowohl den Graphen als auch den Vektorspeicher ab. Diese Architektur reduziert Halluzinationen bei faktischen Abfragen, indem sie Antworten in expliziten Entitätsbeziehungen statt in unstrukturierter Textähnlichkeit verankert.
Die Ingestion-Pipeline extrahiert Tripel (Subjekt, Prädikat, Objekt) aus jedem Dokument-Chunk. Bei der Abfrage identifiziert das System relevante Entitäten in der Frage, traversiert den Wissensgraphen nach verbundenen Fakten und kombiniert graph-abgerufenen Kontext mit vektor-abgerufenen Passagen.
Graph RAG eignet sich besonders für Multi-Hop-Reasoning-Fragen wie "Welches Team leitet das Projekt, das das in Dokument X erwähnte Framework verwendet?" Diese Abfragen erfordern das Verknüpfen von Fakten über mehrere Dokumente hinweg, was reine Vektorsuche nicht leisten kann, da kein einzelner Chunk die vollständige Antwort enthält.
Graph RAG verbessert die faktische Genauigkeit erheblich (bis zu 40% weniger Halluzinationen bei entitätslastigen Abfragen), erfordert jedoch eine ausgereifte Entity-Extraction-Pipeline. Eine fehlerhafte Extraktion erzeugt einen fehlerhaften Graphen, der die Ergebnisse unter das Niveau von naivem RAG senken kann. Microsofts GraphRAG-Projekt ging 2026 in den Wartungsmodus; es erhält Bugfixes, aber keine neuen Features.
Microsofts LazyGraphRAG-Variante (veröffentlicht Juni 2025) reduziert die Indexierungskosten drastisch, indem sie die Zusammenfassung bis zur Abfragezeit aufschiebt, was sie für explorative Analysen oder Streaming-Daten geeignet macht, bei denen der Vorab-Graphaufbau unpraktisch ist.
EU-AI-Act-Compliance für RAG-Systeme
Der EU AI Act wurde im August 2026 breit anwendbar. Die erste hochkarätige Strafe unter dem Gesetz traf Ende Mai 2026 den RAG-Chatbot eines europäischen Bankenkonsortiums, und eine Frankfurter Vermögensverwaltungsfirma erhielt im April 2026 eine Strafe von 4,5 Millionen Euro für ein kundenorientiertes RAG-System, das die Datenherkunft nicht erklären konnte.
RAG-Architekturen erfüllen von Natur aus mehrere Compliance-Anforderungen: Quellenrückverfolgbarkeit (Chunks tragen Dokumentreferenzen), Antworttransparenz (Zitate können angezeigt werden) und Auditierbarkeit (Retrieval-Logs existieren konstruktionsbedingt). Vollständige Compliance erfordert jedoch zusätzliche Maßnahmen:
Risikoklassifizierung: Ein öffentlicher Chatbot fällt unter begrenztes Risiko (Transparenz erforderlich). Ein medizinisches oder juristisches RAG-System ist hochriskant mit strengeren Dokumentations- und Aufsichtspflichten.
Audit-Logging: Aufzeichnen, welche Frage welche abgerufenen Chunks und welche Antwort ausgelöst hat. Dieses Log bildet die Grundlage der erforderlichen Rückverfolgbarkeit.
Menschliche Aufsicht: Hochrisikosysteme erfordern menschliche Validierung bei sensiblen Fällen, die Möglichkeit zur Korrektur von Ausgaben und Mechanismen zum Löschen indexierter Daten auf Anfrage.
Datenresidenz: Indexierung in der EU hosten und BYOK (Bring Your Own Key) verwenden, um sicherzustellen, dass Daten nicht über Drittanbieter-Konten außerhalb der Jurisdiktion übertragen werden.
Nichteinhaltung kann 7% des weltweiten Jahresumsatzes kosten. Für Interview-Diskussionen ist der Kernpunkt, dass RAGs inhärente Zitierfähigkeit ein Vorteil ist, aber die Governance-Schicht nicht ersetzt.
RAG-Systeme evaluieren: Die richtigen Metriken
Die RAG-Evaluierung teilt sich in Retrieval-Metriken und Generierungs-Metriken. Beide müssen unabhängig gemessen werden, um Fehler zu diagnostizieren.
Retrieval-Metriken:
- Recall@k: Wurden die relevanten Dokumente in den Top-k-Ergebnissen gefunden?
- MRR (Mean Reciprocal Rank): Wie hoch ist das erste relevante Ergebnis gerankt?
- NDCG: Entspricht das Ranking der idealen Relevanzreihenfolge?
Generierungs-Metriken:
- Faithfulness: Verwendet die Antwort nur Informationen aus dem abgerufenen Kontext? (Misst Halluzinationen)
- Answer Relevance: Beantwortet die Antwort die ursprüngliche Frage?
- Context Precision: Werden die abgerufenen Chunks tatsächlich in der Antwort verwendet?
Frameworks wie Ragas und DeepEval automatisieren diese Evaluierungen mit LLM-as-Judge-Mustern. Die häufigsten Data-Science-Interviewfragen beinhalten zunehmend RAG-Evaluierungsdesign, daher sollte man erklären können, wie man misst, ob ein RAG-System korrekt funktioniert.
Produktions-Fehlermodi und Debugging
RAG-Systeme versagen auf vorhersehbare Weise. Die Kenntnis dieser Muster ist sowohl für Interviews als auch für den realen Einsatz unerlässlich.
Context-Window-Verschmutzung tritt auf, wenn zu viele abgerufene Chunks das relevante Signal verwässern. Das LLM erhält 10 Chunks, aber nur 2 enthalten nützliche Informationen. Die Lösung: Reranker zum Filtern verwenden und den Top-k-Wert des Retrievers reduzieren.
Chunking-Artefakte entstehen, wenn Fixed-Size-Splitting Sätze, Tabellen oder Codeblöcke mitten im Element trennt. Der abgerufene Chunk ist syntaktisch unvollständig und semantisch nutzlos. Semantisches Chunking oder dokumentbewusstes Splitting (unter Berücksichtigung von Überschriften, Absätzen, Code-Fences) löst dieses Problem.
Embedding-Drift entsteht, wenn das Embedding-Modell aktualisiert wird, der Vektorspeicher aber noch Embeddings des alten Modells enthält. Queries, die mit dem neuen Modell kodiert werden, suchen in einem Vektorraum, der vom alten Modell erstellt wurde, was die Retrieval-Qualität verschlechtert. Lösung: Den gesamten Korpus nach jeder Modelländerung neu einbetten.
Veraltete Indizes liefern veraltete Informationen, weil die Ingestion-Pipeline hinter Dokumentaktualisierungen zurückbleibt. Bei Machine-Learning-Systemen ist dies analog zum Training-Serving-Skew, bei dem das Retrieval-System eine andere Datenverteilung sieht als in der Produktion existiert.
Quellen
- Turing Post: 20 Advanced RAG Types to Know in 2026 - umfassende Taxonomie von RAG-Mustern
- LangChain and LangGraph 1.0 Milestones - Deprecation von AgentExecutor, neue Muster
- Microsoft GraphRAG GitHub - Wartungsmodus-Status
- IgnitionRAG EU AI Act Guide - Compliance-Anforderungen für RAG-Systeme
- MarkTechPost: Best Vector Databases in 2026 - Marktkonsolidierung und Preisgestaltung
Fang an zu üben!
Teste dein Wissen mit unseren Interview-Simulatoren und technischen Tests.
Kernpunkte für RAG in Data-Science-Interviews
- RAG kombiniert Retrieval (Vektorsuche über eine Wissensbasis) mit LLM-Generierung, um fundierte, faktische Antworten zu erzeugen, ohne das Modell neu zu trainieren
- Die Chunking-Strategie hat den größten Einfluss auf die Retrieval-Qualität; semantisches Chunking und Late Chunking übertreffen Fixed-Size-Splitting in den meisten Anwendungsfällen
- Hybrides Retrieval (Dense Vektoren + Sparse BM25) mit Reciprocal Rank Fusion ist der Produktionsstandard und löst das Vocabulary-Mismatch-Problem, das reine Vektorsuche nicht bewältigen kann
- Cross-Encoder-Reranker fügen eine Präzisionsschicht nach dem breiten Retrieval hinzu und verarbeiten nur eine kleine Kandidatenmenge, um die Latenz akzeptabel zu halten
- Adaptives RAG routet Abfragen zur passenden Pipeline-Komplexität und senkt die Kosten bei gemischten Workloads um 40%
- Spekulatives RAG tauscht Verankerung gegen Geschwindigkeit und reduziert die Latenz bei hochkonfidenten Abfragen um 30 bis 40%
- Agentic RAG (Abrufen, Bewerten, Umformulieren, Wiederholen) und Graph RAG (Entitäts-Beziehungs-Extraktion) bewältigen komplexe Multi-Hop-Abfragen, bei denen naives RAG versagt
- EU-AI-Act-Compliance (August 2026) erfordert Audit-Logging, menschliche Aufsicht und Risikoklassifizierung für produktive RAG-Systeme
- Die Evaluierung muss Retrieval-Metriken (Recall@k, MRR) von Generierungs-Metriken (Faithfulness, Answer Relevance) trennen, um zu diagnostizieren, wo die Pipeline bricht
- Die häufigsten Produktionsfehler (Context-Verschmutzung, Chunking-Artefakte, Embedding-Drift, veraltete Indizes) haben alle einfache Lösungen, sobald sie identifiziert sind
Findest du den Bug in Data Science & ML?
Ein echter Codeausschnitt, ein versteckter Bug, ein Versuch pro Tag. Zum Ausprobieren ohne Konto.

Geschrieben von
Anthony Fillion-MailletGründer von SharpSkill
Seit über 10 Jahren Fullstack-Entwickler. Er leitet SharpSkill und verantwortet alles, was hier erscheint.
Aktualisiert am 24. August 2026
Tags
Teilen
Verwandte Artikel
LangChain für Data Scientists 2026: LLMs, Agents und Interview-Fragen
LangChain 0.3 für Data Science beherrschen: LCEL-Chains, RAG-Muster, ReAct-Agents und Memory-Systeme. Inklusive Interview-Fragen und Produktions-Deployment-Strategien.
MLOps 2026: MLflow, Model Registry und technische Interviewfragen
MLOps-Interviewfragen zum ML-Lebenszyklus, MLflow-Experiment-Tracking, zur Model-Registry-Beförderung, zu Deployment-Mustern, Drift-Monitoring und System Design für 2026 – mit Python-Code und Antworten.
Feature Engineering für Machine Learning: Techniken und Interview-Fragen 2026
Feature Engineering für ML-Interviews meistern: Skalierung, Encoding, Feature Selection und zeitbasierte Features mit Python-Codebeispielen.