ETL vs ELT 2026: Data-Pipeline-Architektur und Fragen für technische Interviews
ETL und ELT stellen zwei fundamentale Ansätze der Data-Pipeline-Architektur dar. Dieser Vergleich analysiert, wann welches Muster eingesetzt werden sollte, welche Tools zur Verfügung stehen und welche Fragen Data Engineers in technischen Interviews erwarten.
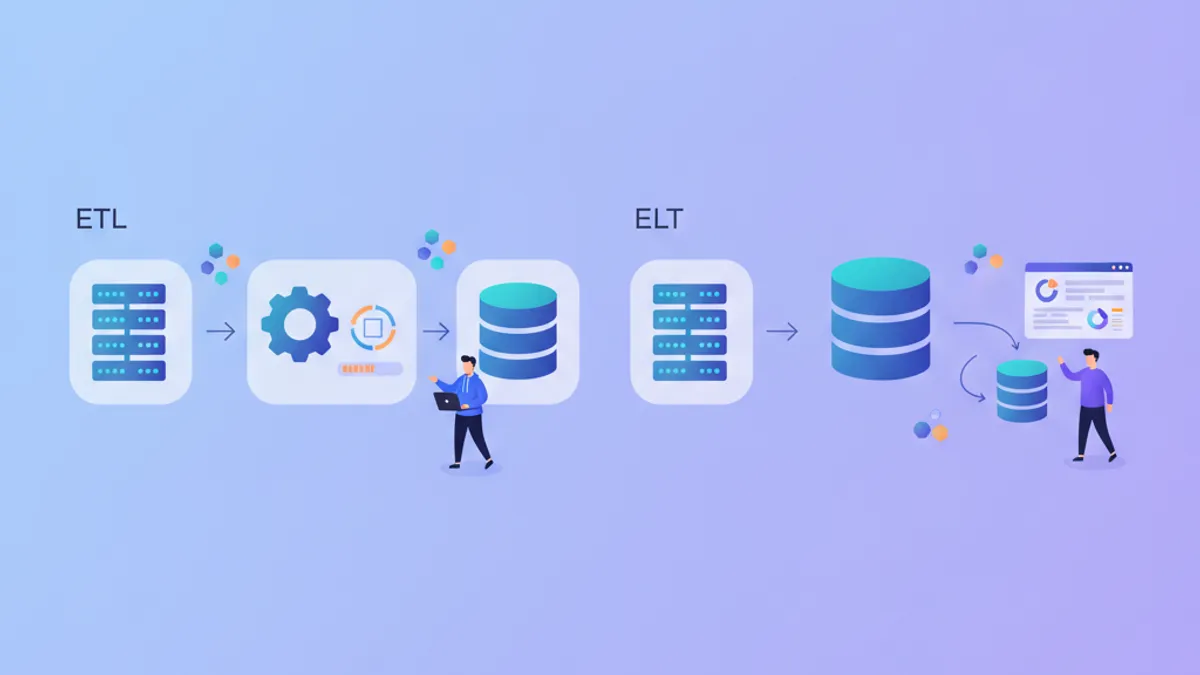
ETL vs ELT definiert, wie Daten von Quellsystemen in Analyseumgebungen bewegt werden. Die Wahl zwischen Extract-Transform-Load (ETL) und Extract-Load-Transform (ELT) beeinflusst Infrastrukturkosten, Datenaktualität und die erforderlichen Qualifikationen im Engineering-Team.
ETL transformiert Daten vor dem Laden in das Zielsystem und erfordert dedizierte Rechenressourcen. ELT lädt Rohdaten zuerst und transformiert sie dann mit der Rechenleistung des Ziel-Warehouses. Die meisten cloud-nativen Data Stacks bevorzugen 2026 ELT, da Rechenkapazität bedarfsgerecht skaliert.
ETL-Architektur: Transformation vor dem Laden
ETL entstand in einer Zeit, als Data Warehouses begrenzte Rechenkapazität hatten und Speicher teuer war. Das Muster war sinnvoll: Daten außerhalb des Warehouses filtern und aggregieren, nur das für die Analyse Notwendige laden. Oracle Warehouse Builder, Informatica PowerCenter und Talend entwickelten Tooling für dieses Modell.
Die Transformationsphase in ETL läuft auf Zwischenservern. Daten bewegen sich von der Quelle in einen Staging-Bereich, werden bereinigt und umstrukturiert, dann ins Ziel geladen. Dieser Ansatz reduziert die Warehouse-Last, erzeugt aber einen Engpass auf der Transformationsebene.
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
ETL funktioniert gut, wenn die Transformationslogik stabil bleibt und Datenvolumen vorhersehbar sind. Der Nachteil zeigt sich bei Änderungen der Anforderungen: Modifikationen an Transformationen erfordern die vollständige Neuverarbeitung historischer Daten.
ELT-Architektur: Zuerst laden, dann im Warehouse transformieren
ELT verlagert die Transformation ins Data Warehouse. Snowflake, BigQuery, Databricks und Redshift bieten nahezu unbegrenzte Rechenkapazität, die mit der Abfragekomplexität skaliert. Das zuerst Laden von Rohdaten bewahrt den Quellzustand; Transformationen werden zu SQL-Modellen, die versioniert und ohne erneute Extraktion wiederholt werden können.
Das dbt-Projekt (data build tool) popularisierte ELT, indem es SQL-Transformationen als Code behandelt. Anstelle von Black-Box-ETL-Jobs leben Transformationen in der Versionskontrolle als SELECT-Statements, die Rohtabellen referenzieren und abgeleitete Modelle erstellen.
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggELT bewahrt Rohdaten, was Nachverarbeitung ermöglicht, wenn sich die Geschäftslogik ändert. War eine Berechnung vor sechs Monaten fehlerhaft, korrigiert das Beheben des dbt-Modells und ein vollständiger Refresh die historischen Daten. Bei ETL erfordert dieselbe Korrektur eine erneute Extraktion aus Quellen, die die ursprünglichen Datensätze möglicherweise nicht mehr haben.
Vergleichstabelle: ETL vs ELT Trade-offs
| Faktor | ETL | ELT |
|---|---|---|
| Rechenort | Dedizierter Transformationsserver | Ziel-Warehouse |
| Rohdatenaufbewahrung | Oft nach Transformation verworfen | In Landing Zone erhalten |
| Neuverarbeitungsaufwand | Erneute Extraktion aus Quelle | SQL-Modelle erneut ausführen |
| Schema-Flexibilität | Zur Transformationszeit fixiert | Schema-on-Read möglich |
| Tooling-Beispiele | Informatica, Talend, SSIS | dbt, Dataform, SQLMesh |
| Optimal für | Stabile Anforderungen, Legacy-Systeme | Wechselnde Anforderungen, Cloud-Warehouses |
| Latenz | Höher (Transform vor Load) | Niedriger (Load dann Transform) |
| Data Governance | Einfacher (Daten vor Warehouse gefiltert) | Erfordert Warehouse-Level-Kontrollen |
Bereit für deine Data Engineering-Interviews?
Übe mit unseren interaktiven Simulatoren, Flashcards und technischen Tests.
Hybride Ansätze: Wenn ETL und ELT kombiniert werden
Moderne Data Stacks verwenden selten reines ETL oder ELT. Apache Airflow orchestriert Pipelines, die beide Muster kombinieren. Sensible Daten werden möglicherweise vor dem Laden anonymisiert (ein ETL-Schritt), während Aggregationen im Warehouse laufen (ELT).
Fivetran und Airbyte extrahieren und laden Rohdaten ohne Transformation, dann transformiert dbt innerhalb des Warehouses. Aber diese Tools unterstützen auch leichtgewichtige Transformationen während der Extraktion: Spaltenauswahl, Datentyp-Konvertierung, Hashing von PII-Feldern. Das verwischt die ETL/ELT-Grenze.
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
Die Pipeline oben extrahiert aus Salesforce mit Airbyte (das E-Mail-Adressen während der Synchronisation hashen kann), lädt zu Snowflake, dann führt dbt-Modelle für Geschäftstransformationen aus. Weder reines ETL noch reines ELT, aber praktikabel.
Interviewfragen: ETL vs ELT für Data Engineers
Technische Interviews für Data-Engineering-Rollen in Unternehmen mit modernen Data Stacks prüfen das Verständnis der Pipeline-Architektur. Diese Fragen erscheinen häufig, basierend auf Mustern aus ETL/ELT-Interviewvorbereitungsmodulen.
Frage 1: Wann würde man ETL gegenüber ELT bevorzugen?
Starke Antworten identifizieren spezifische Szenarien:
- Compliance-Anforderungen: DSGVO oder HIPAA schreiben vor, dass bestimmte Daten niemals in Rohform ins Warehouse gelangen. PII muss vor dem Laden anonymisiert oder entfernt werden.
- Legacy-Warehouse-Einschränkungen: On-Premises-Systeme wie Teradata oder ältere Redshift-Konfigurationen mit fester Rechenkapazität profitieren von voraggregierten Ladungen.
- Netzwerkkosten: Täglich 10TB in ein Cloud-Warehouse laden und nach der Transformation 90% verwerfen verschwendet Egress-Bandbreite. Vorfilterung ist wirtschaftlich sinnvoll.
Schwache Antworten sagen "ETL ist veraltet" oder geben keine konkreten Szenarien. Interviewer suchen nach Nuancen.
Frage 2: Wie werden Schemaänderungen in einer ELT-Pipeline behandelt?
Dies testet das Verständnis von Rohdaten-Landing-Zones. Erwartete Themen:
- JSON- oder semi-strukturierte Spalten, die neue Felder ohne Schema-Migration absorbieren
- Staging-Modelle, die explizit Spalten auswählen und nachgelagerte Modelle von Quelländerungen isolieren
- dbt-Makros oder Dataform-Assertions, die Builds fehlschlagen lassen, wenn erwartete Spalten verschwinden
- Monitoring für Schema-Drift mit Tools wie Monte Carlo oder Great Expectations
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
Frage 3: Vergleichen Sie die Orchestrierung von ETL mit Airflow und das Ausführen von dbt für ELT
Die Frage prüft das Verständnis, dass diese Tools unterschiedliche Probleme lösen:
- Airflow orchestriert Aufgaben: Extraktion, API-Aufrufe, Dateiübertragungen, Modelltraining. Es verwaltet Abhängigkeiten zwischen heterogenen Jobs.
- dbt transformiert Daten innerhalb eines Warehouses. Es verwaltet Abhängigkeiten zwischen SQL-Modellen, führt Tests aus, generiert Dokumentation.
Eine vollständige Pipeline verwendet oft beides: Airflow triggert Airbyte-Syncs, wartet auf Fertigstellung, dann triggert dbt-Runs. Zu wissen, wann welches Tool verwendet wird, unterscheidet Senior-Kandidaten.
Frage 4: Ihre ELT-Pipeline verarbeitet täglich 500M Zeilen und Analysten berichten von langsamen Abfragen
Diese offene Frage testet diagnostisches Denken:
- Modell-Materialisierung prüfen: Sind aufwendige Modelle noch Views? Inkrementelle Modelle oder Tabellen könnten helfen.
- Partitionierung und Clustering: Für BigQuery, sind Fakttabellen nach Datum partitioniert? Für Snowflake, ist Clustering für häufige Abfragemuster optimiert?
- Query Pushdown: Fragen Analysten Staging-Modelle ab statt vor-aggregierter Marts?
- Warehouse-Sizing: Ist die Rechenkapazität während der Abfragezeiten angemessen skaliert?
- Freshness-Anforderungen: Könnte die Transformation nachts statt während der Geschäftszeiten laufen?
Es gibt keine einzelne richtige Antwort. Interviewer bewerten systematisches Troubleshooting.
Tooling-Landschaft 2026
Der Data-Integration-Markt hat sich um einige Muster konsolidiert:
Extraktion und Laden: Fivetran, Airbyte, Stitch und Meltano übernehmen den EL-Teil. Diese Tools verbinden sich mit Hunderten von Quellen und synchronisieren zu Cloud-Warehouses ohne Custom-Code.
Transformation: dbt dominiert SQL-basierte Transformation. Alternativen umfassen Dataform (jetzt Teil von Google Cloud), SQLMesh (Open Source mit virtuellen Datenumgebungen) und Coalesce (visuelles Modeling).
Orchestrierung: Airflow bleibt der Standard für komplexe Pipelines. Dagster und Prefect bieten Alternativen mit besserer lokaler Entwicklung und Asset-zentrierten Views.
Qualität: Great Expectations, dbt-Tests, Monte Carlo und Soda bieten Data-Quality-Monitoring. Diese erkennen Probleme zwischen Extraktion und nachgelagertem Verbrauch.
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
Fang an zu üben!
Teste dein Wissen mit unseren Interview-Simulatoren und technischen Tests.
Pipeline-Architektur für neue Projekte auswählen
Für die meisten Greenfield-Projekte in 2026 ist ELT der Standard. Cloud-Warehouse-Compute kostet weniger als das Warten von Transformationsservern. Rohdatenaufbewahrung ermöglicht nachträgliche Korrekturen. SQL-basierte Transformationen sind auditierbar und versionskontrolliert.
ETL bleibt relevant für:
- Regulatorische Umgebungen, die Datenminimierung vor dem Warehouse-Eintritt erfordern
- Echtzeit-Streaming, wo Transformation zur Ingestion-Zeit erfolgen muss (Kafka Streams, Flink)
- Edge-Computing-Szenarien mit begrenztem nachgelagertem Speicher
- Legacy-Integrationen, bei denen das Quellsystem das Exportformat kontrolliert
Die interview-taugliche Antwort erkennt beide Muster an und erklärt die Trade-offs ohne ideologische Präferenz.
Schlüsselerkenntnisse zur Data-Pipeline-Architektur
- ETL transformiert Daten vor dem Laden, reduziert die Warehouse-Last, erzeugt aber Neuverarbeitungsreibung bei Logikänderungen
- ELT lädt Rohdaten zuerst und ermöglicht SQL-basierte Transformationen, die versioniert, getestet und gegen historische Daten erneut ausgeführt werden können
- Moderne Stacks kombinieren typischerweise beides: leichtgewichtige Extraktionstransformationen (PII-Hashing, Typ-Casting) mit Warehouse-basierter Aggregation
- dbt ist der Standard für ELT-Transformation geworden und behandelt SQL-Modelle als testbaren, dokumentierten Code
- Interviewfragen prüfen Szenario-Auswahl, Schema-Evolution-Handling und Tooling-Trade-offs statt auswendig gelernte Definitionen
- Rohdatenaufbewahrung in ELT-Pipelines ermöglicht Korrekturen historischer Berechnungen ohne erneute Extraktion aus Quellen
Findest du den Bug in Data Engineering?
Ein echter Codeausschnitt, ein versteckter Bug, ein Versuch pro Tag. Zum Ausprobieren ohne Konto.

Geschrieben von
Anthony Fillion-MailletGründer von SharpSkill
Seit über 10 Jahren Fullstack-Entwickler. Er leitet SharpSkill und verantwortet alles, was hier erscheint.
Aktualisiert am 14. September 2026
Tags
Teilen
Verwandte Artikel
ETL vs ELT 2026: Datenpipeline-Architektur im Vergleich
ETL vs ELT Vergleich für moderne Datenpipelines. Architekturunterschiede, Leistungs-Kompromisse und wann welcher Ansatz mit Snowflake, BigQuery und dbt in 2026 sinnvoll ist.

Apache Spark 4.2 vs Databricks 2026: Architektur, Performance und Interview-Fragen
Vergleich von Apache Spark 4.2 und Databricks im Jahr 2026. Architekturunterschiede, Performance-Merkmale und häufige Interview-Fragen für Data-Engineering-Positionen.
Apache Airflow in 2026: Pipeline-Orchestrierung, DAGs und Interview-Fragen
Umfassender Leitfaden zu Apache Airflow 3.2 in 2026: DAG-Erstellung mit dem Task SDK, Dynamic Task Mapping, Asset Partitions und die wichtigsten Interview-Fragen für Data Engineers.