RAG e LLMs em 2026: Retrieval-Augmented Generation para Entrevistas de Data Science
Retrieval-Augmented Generation (RAG) explicado para entrevistas de data science em 2026. Bancos vetoriais, chunking, embeddings, RAG agêntico, Graph RAG e conformidade com EU AI Act.
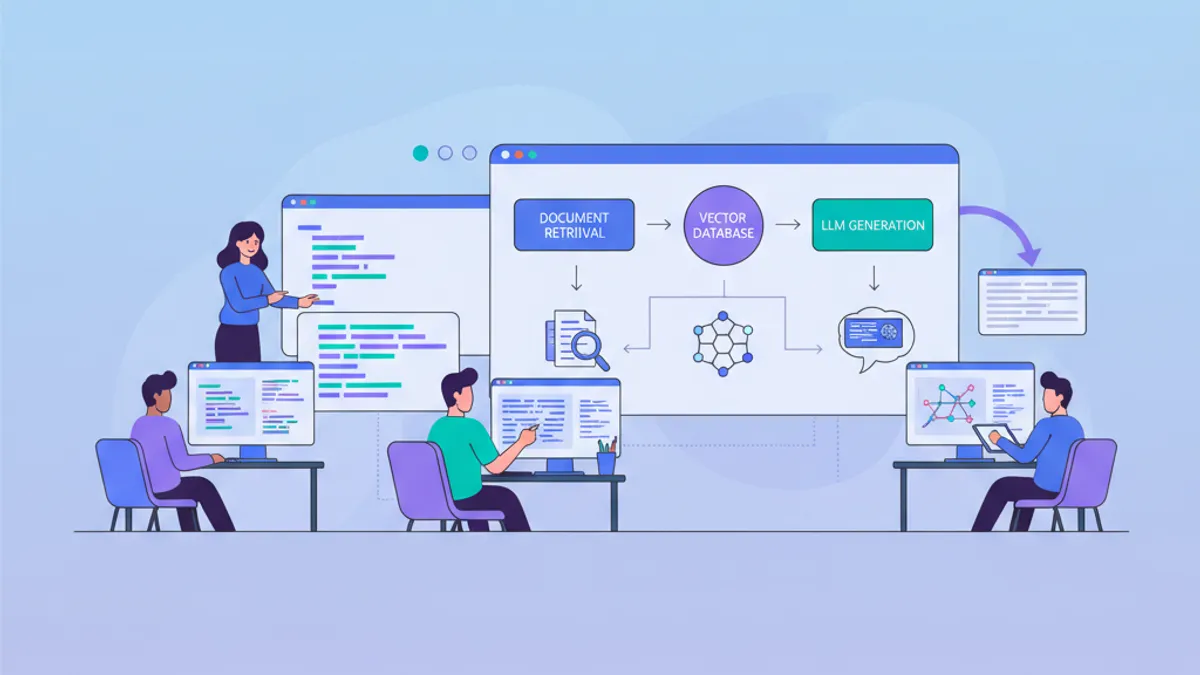
Retrieval-Augmented Generation (RAG) se consolidou como a arquitetura padrão para fundamentar outputs de LLMs em dados atualizados e factuais. Nas entrevistas de data science e engenharia de IA em 2026, perguntas sobre RAG aparecem ao lado de tópicos tradicionais de ML, avaliando tanto pensamento de design de sistemas quanto habilidades de implementação prática.
Retrieval-Augmented Generation combina um sistema de recuperação (busca vetorial sobre uma base de conhecimento) com um gerador LLM, de modo que o modelo responde a partir de documentos reais em vez de depender de dados memorizados durante o treinamento.
Como o pipeline RAG funciona de ponta a ponta
Um sistema RAG opera em duas fases: uma fase de ingestão offline que constrói a base de conhecimento, e uma fase de consulta online que recupera contexto relevante e gera uma resposta.
Durante a ingestão, documentos brutos passam por limpeza, chunking e embedding antes de serem armazenados em um banco de dados vetorial. Durante a inferência, a consulta do usuário segue o mesmo caminho de embedding, e a busca por vizinhos mais próximos recupera os chunks mais relevantes. Esses chunks se tornam parte do prompt do LLM, fundamentando a resposta gerada no material fonte.
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
Esse pipeline cobre o ciclo RAG básico: fragmentar, codificar, armazenar, recuperar e gerar. O parâmetro search_type="mmr" garante que os chunks recuperados sejam tanto relevantes quanto diversos, reduzindo redundância na janela de contexto.
Estratégias de chunking que realmente importam
O chunking determina a qualidade de recuperação mais do que qualquer outro componente. Um chunking ruim significa que o retriever retorna fragmentos que carecem de contexto ou diluem o sinal com conteúdo irrelevante.
Três abordagens de chunking dominam os sistemas de produção em 2026:
Chunking de tamanho fixo divide o texto em uma contagem de tokens definida (tipicamente de 256 a 512 tokens) com sobreposição. Simples de implementar, mas corta frases e ideias no meio do pensamento.
Chunking semântico detecta limites de tópico medindo a similaridade de embedding entre frases consecutivas. Quando a similaridade cai abaixo de um limiar, um novo chunk começa. Cada chunk carrega uma ideia coerente em vez de uma fatia arbitrária de texto.
Late chunking aplica primeiro o modelo transformer ao documento completo, produzindo embeddings de tokens contextuais, e então divide em chunks. Isso preserva dependências de longo alcance que o chunking tradicional destrói.
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
O ponto chave para entrevistas: o tamanho do chunk é um trade-off entre precisão e recall. Chunks pequenos (100 tokens) melhoram a precisão de recuperação mas fragmentam o contexto. Chunks grandes (1000 tokens) preservam o contexto mas diluem a especificidade do embedding. A maioria dos sistemas de produção fica entre 256 e 512 tokens com 10 a 20% de sobreposição.
Bancos de dados vetoriais e modelos de embedding em produção
O banco de dados vetorial armazena embeddings e suporta busca rápida de vizinhos mais próximos aproximados (ANN). A escolha da combinação certa de modelo de embedding e banco de dados vetorial impacta diretamente a latência e precisão de recuperação.
Os modelos de embedding em 2026 convergiram em algumas opções de alto desempenho. O text-embedding-3-large da OpenAI (3072 dimensões) e alternativas open-source como bge-m3 da BAAI ou embed-v4 da Cohere oferecem recuperação multilíngue de qualidade. O MTEB leaderboard continua sendo o benchmark padrão para comparar qualidade de embeddings. O modelo text-embedding-3-large suporta aprendizado de representação Matryoshka, permitindo truncamento de dimensões (para 1024 ou 256) com perda mínima de qualidade, reduzindo significativamente os custos de armazenamento.
O mercado de bancos de dados vetoriais se consolidou em 2026. Quatro produtos representam a grande maioria das cargas de trabalho RAG em produção:
| Database | Indexing | Managed | Strength |
|---|---|---|---|
| Pinecone | Proprietary | Yes | Zero-ops, inferência integrada, busca híbrida |
| Weaviate | HNSW | Yes/Self | Fusão nativa BM25 + dense em uma consulta |
| Qdrant | HNSW | Yes/Self | Performance Rust, filtragem de payload, melhor tier gratuito |
| pgvector | IVF, HNSW | Self | Integração PostgreSQL para stacks existentes |
Para discussões em entrevistas, o ponto crítico é entender o algoritmo HNSW (Hierarchical Navigable Small World): ele constrói um grafo multicamada onde cada nó se conecta aos seus vizinhos mais próximos, permitindo busca O(log n) ao custo de maior uso de memória.
O ponto de inflexão de custos está entre 60 e 80 milhões de consultas por mês. Acima disso, Qdrant ou Weaviate auto-hospedados em infraestrutura de custo fixo consistentemente custam de 3 a 10 vezes menos que Pinecone Serverless.
Pronto para mandar bem nas entrevistas de Data Science & ML?
Pratique com nossos simuladores interativos, flashcards e testes tecnicos.
Recuperação híbrida: combinando busca densa e esparsa
A busca vetorial pura falha em correspondências exatas de palavras-chave e termos raros. A busca léxica pura (BM25) não captura similaridade semântica. A recuperação híbrida combina ambas, e em 2026 esse é o padrão para sistemas RAG em produção.
O padrão utiliza Reciprocal Rank Fusion (RRF) para mesclar resultados ranqueados de ambos os retrievers:
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
A recuperação híbrida resolve o problema de "desalinhamento de vocabulário" onde um usuário pergunta sobre "cancelar uma assinatura" mas o documento relevante usa "política de encerramento de conta". BM25 captura a correspondência exata de termos enquanto a busca vetorial captura o relacionamento semântico.
Reranking: o filtro de segunda etapa
A recuperação retorna candidatos. O reranking os ordena por relevância real. Rerankers cross-encoder como Cohere Rerank ou bge-reranker-v2.5-gemma2-lightweight pontuam cada par consulta-documento conjuntamente, produzindo scores de relevância muito mais precisos do que similaridade por bi-encoder.
O pipeline de recuperação em duas etapas (amplo recall na primeira etapa com top 50 a 100 candidatos via vector + BM25, depois reranking preciso para top 5 a 10 para o prompt) é padrão em produção. Isso mantém a latência gerenciável: a primeira etapa usa busca ANN rápida, enquanto o caro cross-encoder processa apenas um pequeno conjunto de candidatos.
Cross-encoders são mais precisos que bi-encoders porque processam a consulta e o documento juntos através de todas as camadas do transformer. Bi-encoders os codificam independentemente, perdendo sinais de interação fina. O trade-off é velocidade: cross-encoders não podem ser pré-indexados.
RAG adaptativo: roteando consultas para o pipeline certo
Nem toda consulta precisa da mesma complexidade de recuperação. O RAG adaptativo treina um pequeno classificador para rotear cada pergunta para o caminho ideal:
- Sem recuperação para consultas factuais simples que o modelo já conhece
- Recuperação de passo único para consultas moderadas
- Recuperação iterativa multi-passo para raciocínio complexo
Esse padrão equilibra custo e precisão em cargas de trabalho mistas. Um sistema de produção processando 100.000 consultas por dia pode reduzir custos de inferência em 40% roteando perguntas simples para longe de pipelines multi-passo caros.
O classificador em si pode ser um pequeno modelo fine-tuned ou um prompt zero-shot perguntando: "Essa pergunta requer conhecimento externo para responder com precisão?"
RAG especulativo: trocando fundamentação por velocidade
O RAG especulativo executa a recuperação em paralelo com uma geração de rascunho rápida. Se o rascunho mostra alta confiança (medida por logprob), a etapa de recuperação é completamente pulada. Se a confiança é baixa, o contexto recuperado se mescla com o rascunho e a regeneração ocorre.
Essa abordagem reduz a latência média de 30 a 40% em consultas de alta confiança. Funciona melhor para chatbots em tempo real, sugestões de autocompletar e sistemas de atendimento ao cliente onde o tempo de resposta importa mais do que sourcing exaustivo em cada consulta.
O trade-off: RAG especulativo ocasionalmente retorna respostas sem fundamentação quando o modelo está confiante demais. Sistemas de produção o combinam com calibração de confiança e fallback para recuperação completa quando a incerteza excede um limiar.
RAG agêntico: além da recuperação de passo único
RAG ingênuo recupera uma vez e gera. RAG agêntico trata o LLM como um agente de raciocínio que decide quando recuperar, o que recuperar e se o contexto recuperado é suficiente.
Em 2026, RAG agêntico é o padrão dominante para consultas complexas que requerem raciocínio multi-passo. O agente pode:
- Auto-avaliar: avaliar se os documentos recuperados respondem a pergunta
- Re-consultar: reformular a consulta de busca se os resultados iniciais são insuficientes
- Rotear: escolher entre diferentes fontes de conhecimento (DB vetorial, banco SQL, API)
- Verificar: cruzar fatos entre múltiplas passagens recuperadas
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
Esse padrão (recuperar, avaliar, opcionalmente reescrever e tentar novamente) é conhecido como Corrective RAG (CRAG). O AgentExecutor do LangChain está depreciado desde 2026; novos projetos devem usar create_react_agent() para padrões pré-construídos ou o StateGraph do LangGraph para orquestração personalizada. Para uma cobertura mais profunda dos padrões LangChain para data scientists, consulte o artigo dedicado.
Graph RAG: recuperação de conhecimento estruturado
Graph RAG extrai entidades e relacionamentos de documentos em um grafo de conhecimento, então consulta tanto o grafo quanto o banco vetorial. Essa arquitetura reduz alucinação em consultas factuais fundamentando respostas em relacionamentos explícitos entre entidades em vez de similaridade de texto não estruturado.
O pipeline de ingestão extrai triplas (sujeito, predicado, objeto) de cada chunk de documento. No momento da consulta, o sistema identifica entidades relevantes na pergunta, atravessa o grafo de conhecimento para fatos conectados, e combina contexto recuperado do grafo com passagens recuperadas por vetores.
Graph RAG se destaca em perguntas de raciocínio multi-hop como "Qual equipe lidera o projeto que usa o framework mencionado no documento X?" Essas consultas requerem conectar fatos através de múltiplos documentos, algo com que a busca vetorial pura tem dificuldade porque nenhum chunk único contém a resposta completa.
Graph RAG melhora significativamente a precisão factual (até 40% de redução em alucinação em consultas com muitas entidades) mas requer um pipeline maduro de extração de entidades. Extração ruidosa produz um grafo ruidoso, o que pode degradar resultados abaixo do RAG ingênuo. O projeto GraphRAG da Microsoft entrou em modo de manutenção em 2026; receberá correções de bugs mas não novas funcionalidades.
A variante LazyGraphRAG da Microsoft (lançada em junho de 2025) reduz drasticamente os custos de indexação ao adiar a sumarização até o momento da consulta, tornando-a adequada para análise exploratória ou dados em streaming onde a construção antecipada do grafo não é prática.
Conformidade com o EU AI Act para sistemas RAG
O EU AI Act se tornou amplamente aplicável em agosto de 2026. A primeira multa de alto perfil sob a Lei atingiu um consórcio bancário europeu cujo chatbot RAG não cumpria os requisitos de transparência no final de maio de 2026, e uma firma de gestão de patrimônio de Frankfurt recebeu uma penalidade de 4,5 milhões de euros em abril de 2026 por um sistema RAG voltado ao cliente que não explicava a procedência dos dados.
Arquiteturas RAG naturalmente satisfazem vários requisitos de conformidade: rastreabilidade de fontes (chunks carregam referências de documentos), transparência de respostas (citações podem ser expostas), e auditabilidade (logs de recuperação existem por construção). No entanto, conformidade completa requer medidas adicionais:
Classificação de risco: Um chatbot público cai sob risco limitado (transparência requerida). Um sistema RAG médico ou legal é de alto risco com obrigações mais estritas de documentação e supervisão.
Logging de auditoria: Registrar qual pergunta acionou quais chunks recuperados e qual resposta foi gerada. Esse log forma a base da rastreabilidade requerida.
Supervisão humana: Sistemas de alto risco requerem validação humana em casos sensíveis, a capacidade de corrigir outputs, e mecanismos para apagar dados indexados sob solicitação.
Residência de dados: Hospedar indexação na UE e usar BYOK (Bring Your Own Key) para garantir que dados não transitem por contas de terceiros fora da jurisdição.
Não conformidade pode custar 7% da receita anual global. Para discussões em entrevistas, o ponto chave é que a capacidade inerente de citação do RAG é uma vantagem, mas não substitui a camada de governança.
Avaliando sistemas RAG: métricas que importam
A avaliação de RAG se divide em métricas de recuperação e métricas de geração. Ambas devem ser medidas independentemente para diagnosticar falhas.
Métricas de recuperação:
- Recall@k: Os documentos relevantes apareceram nos top k resultados?
- MRR (Mean Reciprocal Rank): Quão alto está ranqueado o primeiro resultado relevante?
- NDCG: O ranking corresponde ao ordenamento de relevância ideal?
Métricas de geração:
- Fidelidade: A resposta usa apenas informação do contexto recuperado? (Mede alucinação)
- Relevância da resposta: A resposta aborda a pergunta original?
- Precisão do contexto: Os chunks recuperados são realmente usados na resposta?
Frameworks como Ragas e DeepEval automatizam essas avaliações usando padrões LLM-as-judge. As principais perguntas de entrevista de data science incluem cada vez mais design de avaliação RAG, então é preciso estar preparado para explicar como medir se um sistema RAG está funcionando corretamente.
Modos de falha em produção e depuração
Sistemas RAG falham de maneiras previsíveis. Conhecer esses padrões é essencial tanto para entrevistas quanto para deploy real.
Poluição da janela de contexto acontece quando muitos chunks recuperados diluem o sinal relevante. O LLM recebe 10 chunks mas apenas 2 contêm informação útil. A correção: usar um reranker para filtrar e reduzir o top-k do retriever.
Artefatos de chunking ocorrem quando divisão de tamanho fixo quebra frases, tabelas ou blocos de código no meio do elemento. O chunk recuperado é sintaticamente incompleto e semanticamente inútil. Chunking semântico ou divisão consciente do documento (respeitando headers, parágrafos, code fences) resolve isso.
Drift de embedding emerge quando o modelo de embedding é atualizado mas o store vetorial ainda contém embeddings do modelo antigo. Consultas codificadas com o novo modelo buscam em um espaço vetorial construído pelo antigo, degradando a qualidade de recuperação. Solução: re-embedar todo o corpus após qualquer mudança de modelo.
Índices obsoletos entregam informação desatualizada porque o pipeline de ingestão ficou para trás das atualizações de documentos. Em sistemas de machine learning, isso é análogo ao training-serving skew, onde o sistema de recuperação vê uma distribuição de dados diferente do que existe em produção.
Fontes
- Turing Post: 20 Advanced RAG Types to Know in 2026 - taxonomia completa de padrões RAG
- LangChain and LangGraph 1.0 Milestones - depreciação do AgentExecutor, novos padrões
- Microsoft GraphRAG GitHub - status de modo de manutenção
- IgnitionRAG EU AI Act Guide - requisitos de conformidade para sistemas RAG
- MarkTechPost: Best Vector Databases in 2026 - consolidação de mercado e preços
Comece a praticar!
Teste seus conhecimentos com nossos simuladores de entrevista e testes tecnicos.
Pontos chave sobre RAG para entrevistas de Data Science
- RAG combina recuperação (busca vetorial sobre uma base de conhecimento) com geração LLM para produzir respostas fundamentadas e factuais sem retreinar o modelo
- A estratégia de chunking tem o maior impacto na qualidade de recuperação; chunking semântico e late chunking superam divisão de tamanho fixo na maioria dos casos de uso
- Recuperação híbrida (vetores densos + BM25 esparso) com Reciprocal Rank Fusion é o padrão de produção, resolvendo o problema de desalinhamento de vocabulário que busca vetorial pura não consegue lidar
- Rerankers cross-encoder adicionam uma camada de precisão após recuperação ampla, processando apenas um pequeno conjunto de candidatos para manter a latência aceitável
- RAG adaptativo roteia consultas para a complexidade de pipeline apropriada, reduzindo custos em 40% em cargas de trabalho mistas
- RAG especulativo troca fundamentação por velocidade, reduzindo latência de 30 a 40% em consultas de alta confiança
- RAG agêntico (recuperar, avaliar, reescrever, tentar novamente) e Graph RAG (extração de relacionamentos entre entidades) lidam com consultas complexas multi-hop onde RAG ingênuo falha
- Conformidade com o EU AI Act (agosto 2026) requer logging de auditoria, supervisão humana e classificação de risco para sistemas RAG em produção
- A avaliação deve separar métricas de recuperação (Recall@k, MRR) de métricas de geração (fidelidade, relevância da resposta) para diagnosticar onde o pipeline quebra
- As falhas de produção mais comuns (poluição de contexto, artefatos de chunking, drift de embedding, índices obsoletos) todas têm correções diretas uma vez identificadas
Você saberia encontrar o bug em Data Science & ML?
Um trecho real, um bug escondido, uma tentativa por dia. Sem conta para testar.

Escrito por
Anthony Fillion-MailletFundador da SharpSkill
Desenvolvedor fullstack há mais de 10 anos. Dirige a SharpSkill e responde por tudo o que é publicado aqui.
Atualizado em 24 de agosto de 2026
Tags
Compartilhar
Artigos relacionados
Feature Engineering para Machine Learning: Tecnicas e Perguntas de Entrevista 2026
Guia completo de feature engineering para entrevistas de data science em 2026. Encoding categorico, scaling, selecao de features, pipelines de producao e perguntas frequentes.

XGBoost vs LightGBM em 2026: Gradient Boosting e Perguntas de Entrevista em Data Science
Domine XGBoost e LightGBM para entrevistas de data science. Compare algoritmos de gradient boosting, aprenda otimização de hiperparâmetros e prepare-se com perguntas técnicas e exemplos em Python.

Pipelines Scikit-Learn em 2026: Feature Engineering e Perguntas de Entrevista
Domine os pipelines do scikit-learn para feature engineering e prepare-se para entrevistas técnicas. Guia completo com ColumnTransformer, GridSearchCV e melhores práticas de deploy.