ETL vs ELT em 2026: Arquitetura de Pipelines de Dados e Perguntas de Entrevista
Análise aprofundada das arquiteturas ETL e ELT, comparação de padrões de pipelines de dados e perguntas de entrevista para engenheiros de dados em 2026.
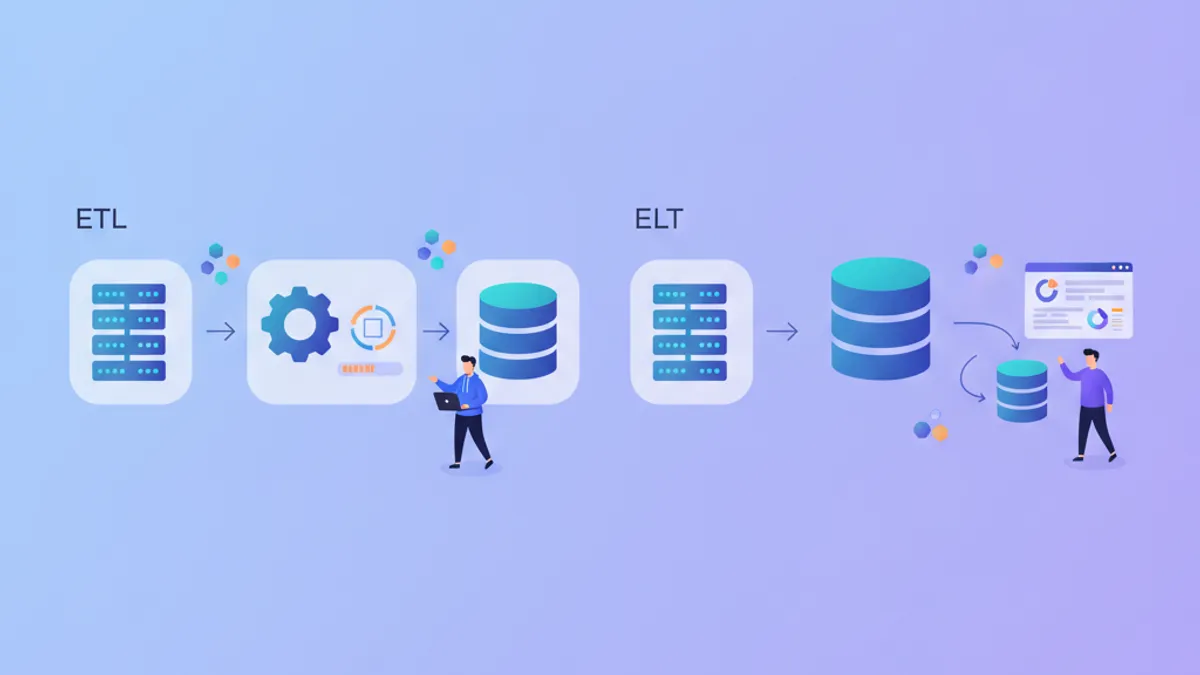
ETL vs ELT define como os dados se movem dos sistemas de origem para os ambientes de análise. A escolha entre extrair, transformar e depois carregar (ETL) ou extrair, carregar e depois transformar (ELT) afeta os custos de infraestrutura, a frescura dos dados e as habilidades exigidas das equipes de engenharia.
ETL transforma os dados antes de carregar no sistema de destino, exigindo recursos de computação dedicados. ELT carrega os dados brutos primeiro e depois os transforma usando o poder de processamento do warehouse de destino. A maioria dos stacks de dados cloud-nativos em 2026 favorece ELT porque a computação escala sob demanda.
Arquitetura ETL: Transformar Antes de Carregar
O ETL surgiu quando os data warehouses tinham capacidade de computação limitada e o armazenamento era caro. O padrão fazia sentido: filtrar e agregar dados fora do warehouse, carregar apenas o que a análise exigia. Oracle Warehouse Builder, Informatica PowerCenter e Talend construíram ferramentas em torno deste modelo.
A etapa de transformação no ETL roda em servidores intermediários. Os dados se movem da origem para uma área de staging, são limpos e remodelados, e depois carregados no destino. Esta abordagem reduz a carga do warehouse mas cria um gargalo na camada de transformação.
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
O ETL funciona bem quando a lógica de transformação permanece estável e os volumes de dados são previsíveis. A desvantagem aparece quando os requisitos mudam: modificar transformações significa reprocessar dados históricos do zero.
Arquitetura ELT: Carregar Primeiro, Transformar no Warehouse
O ELT move a transformação para dentro do data warehouse. Snowflake, BigQuery, Databricks e Redshift fornecem computação quase ilimitada que escala com a complexidade das consultas. Carregar dados brutos primeiro preserva o estado da origem; as transformações se tornam modelos SQL que podem ser versionados e reexecutados sem nova extração.
O projeto dbt (data build tool) popularizou o ELT tratando transformações SQL como código. Em vez de jobs ETL de caixa preta, as transformações residem em controle de versão como instruções SELECT que referenciam tabelas brutas e constroem modelos derivados.
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggO ELT preserva os dados brutos, o que permite reprocessamento quando a lógica de negócio muda. Se um cálculo estava errado há seis meses, corrigir o modelo dbt e executar um refresh completo corrige os dados históricos. Com ETL, a mesma correção requer re-extrair de fontes que podem não ter mais os registros originais.
Tabela Comparativa: Trade-offs ETL vs ELT
| Fator | ETL | ELT |
|---|---|---|
| Localização da computação | Servidor de transformação dedicado | Warehouse de destino |
| Retenção de dados brutos | Frequentemente descartados após transformar | Preservados na zona de landing |
| Custo de reprocessamento | Re-extrair da fonte | Re-executar modelos SQL |
| Flexibilidade de esquema | Fixo no momento da transformação | Schema-on-read possível |
| Exemplos de ferramentas | Informatica, Talend, SSIS | dbt, Dataform, SQLMesh |
| Melhor para | Requisitos estáveis, sistemas legados | Requisitos mutáveis, warehouses cloud |
| Latência | Maior (transformar antes de carregar) | Menor (carregar depois transformar) |
| Governança de dados | Mais fácil (dados filtrados antes do warehouse) | Requer controles no nível do warehouse |
Pronto para mandar bem nas entrevistas de Data Engineering?
Pratique com nossos simuladores interativos, flashcards e testes tecnicos.
Abordagens Híbridas: Quando ETL e ELT se Combinam
Stacks de dados modernos raramente usam ETL ou ELT puros. Apache Airflow orquestra pipelines que misturam ambos os padrões. Dados sensíveis podem ser anonimizados antes de carregar (um passo ETL), enquanto agregações rodam no warehouse (ELT).
Fivetran e Airbyte extraem e carregam dados brutos sem transformação, depois dbt transforma dentro do warehouse. Mas essas ferramentas também suportam transformações leves durante a extração: seleção de colunas, conversão de tipos de dados, hashing de campos PII. Isso difumina a fronteira ETL/ELT.
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
O pipeline acima extrai do Salesforce com Airbyte (que pode hashear endereços de email durante a sincronização), carrega no Snowflake e depois executa modelos dbt para transformações de negócio. Nem ETL puro nem ELT puro, mas prático.
Perguntas de Entrevista: ETL vs ELT para Engenheiros de Dados
Entrevistas técnicas para posições de engenharia de dados em empresas usando stacks de dados modernos avaliam a compreensão da arquitetura de pipelines. Estas perguntas aparecem frequentemente, baseadas em padrões de módulos de preparação para entrevistas ETL/ELT.
Pergunta 1: Quando Você Escolheria ETL ao Invés de ELT?
Respostas fortes identificam cenários específicos:
- Requisitos de conformidade: LGPD/GDPR ou HIPAA exigem que certos dados nunca cheguem ao warehouse em forma bruta. PII devem ser anonimizados ou removidos antes de carregar.
- Restrições de warehouse legado: Sistemas on-premises como Teradata ou configurações antigas do Redshift com computação fixa se beneficiam de cargas pré-agregadas.
- Custos de rede: Carregar 10TB diariamente para um warehouse cloud, depois descartar 90% após transformar, desperdiça largura de banda de egress. Pré-filtragem faz sentido econômico.
Respostas fracas dizem "ETL está obsoleto" ou falham em dar cenários concretos. Entrevistadores procuram nuances.
Pergunta 2: Como Você Lida com Mudanças de Esquema em um Pipeline ELT?
Isso testa a compreensão de zonas de landing de dados brutos. Tópicos esperados:
- Colunas JSON ou semi-estruturadas que absorvem novos campos sem migração de esquema
- Modelos de staging que selecionam colunas explicitamente, isolando modelos downstream de mudanças na fonte
- Macros dbt ou assertions do Dataform que falham builds quando colunas esperadas desaparecem
- Monitoramento de drift de esquema usando ferramentas como Monte Carlo ou Great Expectations
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
Pergunta 3: Compare Orquestração ETL com Airflow vs Executar dbt para ELT
A pergunta avalia a compreensão de que essas ferramentas resolvem problemas diferentes:
- Airflow orquestra tarefas: extração, chamadas de API, transferências de arquivos, treinamento de modelos. Gerencia dependências entre jobs heterogêneos.
- dbt transforma dados dentro de um warehouse. Gerencia dependências entre modelos SQL, executa testes, gera documentação.
Um pipeline completo frequentemente usa ambos: Airflow dispara sincronizações do Airbyte, aguarda a conclusão e depois dispara execuções do dbt. Saber quando usar cada ferramenta distingue candidatos seniores.
Pergunta 4: Seu Pipeline ELT Processa 500M de Linhas Diárias e Analistas Reportam Consultas Lentas
Esta pergunta aberta testa o pensamento diagnóstico:
- Verificar materialização de modelos: Os modelos pesados ainda são views? Modelos incrementais ou tabelas podem ajudar.
- Particionar e clusterizar: Para BigQuery, as tabelas de fatos estão particionadas por data? Para Snowflake, o clustering está otimizado para padrões de consulta comuns?
- Pushdown de consultas: Os analistas estão consultando modelos de staging ao invés de marts pré-agregados?
- Dimensionamento do warehouse: A computação está escalada apropriadamente durante os horários de consulta?
- Requisitos de frescura: A transformação poderia rodar à noite ao invés do horário comercial?
Não existe uma única resposta correta. Entrevistadores avaliam troubleshooting sistemático.
Panorama de Ferramentas em 2026
O mercado de integração de dados se consolidou em torno de alguns padrões:
Extração e carga: Fivetran, Airbyte, Stitch e Meltano lidam com a porção EL. Essas ferramentas se conectam a centenas de fontes e sincronizam para warehouses cloud sem código customizado.
Transformação: dbt domina a transformação baseada em SQL. Alternativas incluem Dataform (agora parte do Google Cloud), SQLMesh (open source com ambientes de dados virtuais) e Coalesce (modelagem visual).
Orquestração: Airflow continua sendo o padrão para pipelines complexos. Dagster e Prefect oferecem alternativas com melhor desenvolvimento local e visões centradas em assets.
Qualidade: Great Expectations, testes dbt, Monte Carlo e Soda fornecem monitoramento de qualidade de dados. Essas ferramentas detectam problemas entre extração e consumo downstream.
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
Comece a praticar!
Teste seus conhecimentos com nossos simuladores de entrevista e testes tecnicos.
Selecionando Arquitetura de Pipeline para Novos Projetos
Para a maioria dos projetos greenfield em 2026, ELT é o padrão. Computação em warehouses cloud custa menos que manter servidores de transformação. A preservação de dados brutos permite correções retroativas. Transformações baseadas em SQL são auditáveis e versionadas.
ETL continua relevante para:
- Ambientes regulatórios exigindo minimização de dados antes de entrar no warehouse
- Streaming em tempo real onde a transformação deve ocorrer no momento da ingestão (Kafka Streams, Flink)
- Cenários de edge computing com armazenamento downstream limitado
- Integrações legadas onde o sistema de origem controla o formato de exportação
A resposta pronta para a entrevista reconhece ambos os padrões e explica os trade-offs sem preferência ideológica.
Pontos-Chave para Arquitetura de Pipelines de Dados
- ETL transforma dados antes de carregar, reduzindo a carga do warehouse mas criando fricção de reprocessamento quando a lógica muda
- ELT carrega dados brutos primeiro, permitindo transformações SQL que podem ser versionadas, testadas e reexecutadas contra dados históricos
- Stacks modernos tipicamente combinam ambos: transformações de extração leves (hashing de PII, conversão de tipos) com agregação baseada no warehouse
- dbt se tornou o padrão para transformação ELT, tratando modelos SQL como código testável e documentado
- Perguntas de entrevista avaliam seleção de cenários, tratamento de evolução de esquema e trade-offs de ferramentas ao invés de definições decoradas
- A preservação de dados brutos em pipelines ELT permite correções a cálculos históricos sem re-extrair das fontes
Você saberia encontrar o bug em Data Engineering?
Um trecho real, um bug escondido, uma tentativa por dia. Sem conta para testar.

Escrito por
Anthony Fillion-MailletFundador da SharpSkill
Desenvolvedor fullstack há mais de 10 anos. Dirige a SharpSkill e responde por tudo o que é publicado aqui.
Atualizado em 14 de setembro de 2026
Compartilhar
Artigos relacionados
Great Expectations em 2026: Validação de Qualidade de Dados e Perguntas de Entrevista
Guia completo sobre Great Expectations 1.22 para validação de qualidade de dados. Expectations, Checkpoints, integração com Airflow e perguntas de entrevista de data engineering.

Apache Beam vs Spark em 2026: Pipelines Unificados e Perguntas de Entrevista
Comparação detalhada entre Apache Beam e Spark para pipelines de dados em 2026. Portabilidade, windowing, performance e perguntas técnicas de entrevista.

Apache Flink em 2026: Processamento de Streams, Event Time e Perguntas de Entrevista
Guia completo sobre Apache Flink 2.3 para processamento de streams em tempo real. Watermarks, janelas, gerenciamento de estado e preparação para entrevistas de data engineering.