ETL vs ELT em 2026: Arquitetura de Pipelines de Dados Explicada
Comparação completa entre arquiteturas ETL e ELT para pipelines de dados em 2026, incluindo análise de custos, performance, exemplos de código e critérios de decisão para engenheiros de dados.
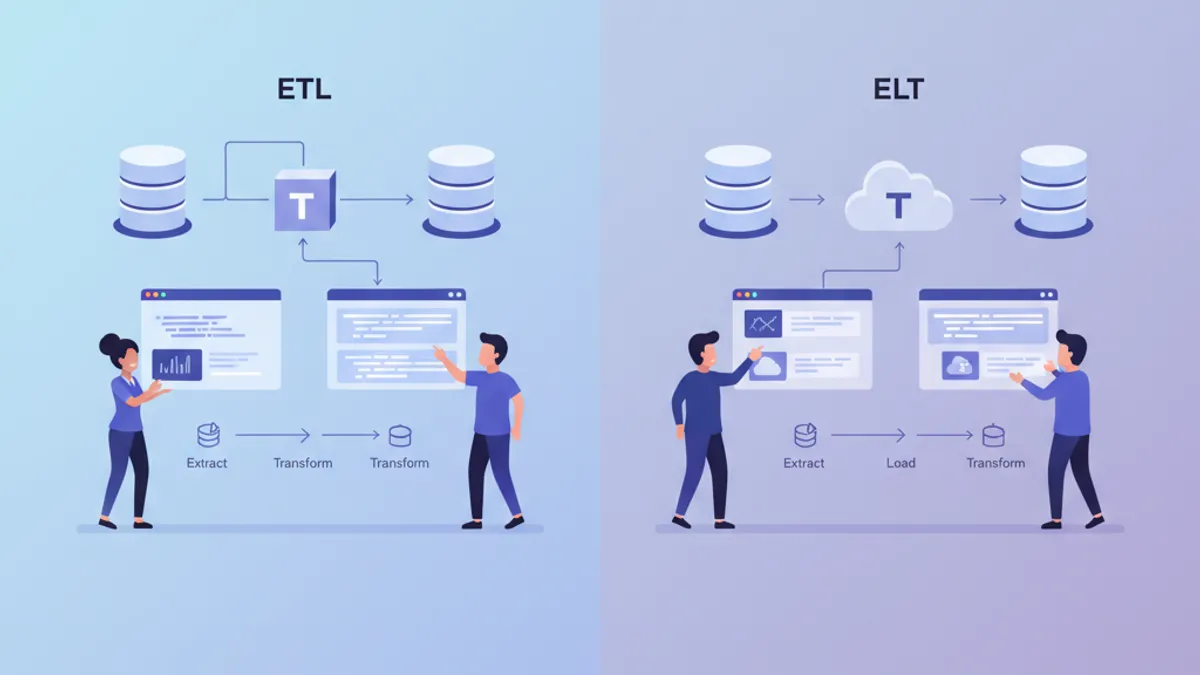
A arquitetura de pipelines de dados representa um dos pilares fundamentais da engenharia de dados moderna, e a escolha entre ETL vs ELT determina não apenas o fluxo técnico das informações, mas também os custos operacionais, a escalabilidade e a agilidade das equipes de analytics. Em 2026, com a consolidação de data warehouses cloud-native e ferramentas de transformação como dbt, essa decisão arquitetural ganhou novos contornos que todo engenheiro de dados precisa compreender.
A diferença fundamental entre ETL e ELT está no momento da transformação: no ETL, os dados são transformados antes de chegar ao destino final; no ELT, os dados brutos são carregados primeiro e transformados diretamente no warehouse utilizando seu poder computacional.
Fundamentos do ETL: Extract, Transform, Load
O padrão ETL (Extract, Transform, Load) surgiu em uma era onde o armazenamento era caro e o poder computacional dos data warehouses era limitado. Nesse modelo, um servidor intermediário extrai dados das fontes, aplica todas as transformações necessárias e só então carrega os dados já processados no destino final.
Essa abordagem possui vantagens claras quando há necessidade de mascaramento de dados sensíveis antes do armazenamento ou quando o volume de dados brutos excede a capacidade econômica do warehouse de destino.
# etl_pipeline.py
import pandas as pd
from sqlalchemy import create_engine

def extract(source_url: str) -> pd.DataFrame:
    """Extract raw data from source system."""
    return pd.read_csv(source_url)

def transform(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading."""
    # Remove rows with missing revenue
    df = df.dropna(subset=["revenue"])
    # Normalize currency to USD
    df["revenue_usd"] = df.apply(
        lambda row: row["revenue"] * get_exchange_rate(row["currency"]),
        axis=1
    )
    # Aggregate to daily granularity
    return df.groupby("date").agg({"revenue_usd": "sum"}).reset_index()

def load(df: pd.DataFrame, engine) -> None:
    """Write transformed data to the warehouse."""
    df.to_sql("daily_revenue", engine, if_exists="append", index=False)

# Pipeline execution: Extract -> Transform -> Load
engine = create_engine("postgresql://warehouse:5432/analytics")
raw = extract("s3://data-lake/sales/2026-04-13.csv")
cleaned = transform(raw)
load(cleaned, engine)
O código acima exemplifica um pipeline ETL clássico onde cada função representa uma etapa distinta. A transformação ocorre em memória no servidor de processamento antes que qualquer dado chegue ao PostgreSQL de destino.
Arquitetura ELT e o Paradigma Moderno
O ELT (Extract, Load, Transform) inverte a ordem das operações, aproveitando a capacidade computacional massiva dos data warehouses modernos como Snowflake, BigQuery e Databricks. Os dados são extraídos das fontes e carregados em estado bruto ou minimamente processado, com todas as transformações executadas posteriormente dentro do próprio warehouse.
Essa arquitetura se tornou predominante devido a três fatores convergentes: o custo decrescente de armazenamento cloud, a separação de compute e storage nos warehouses modernos, e o surgimento de ferramentas como dbt que tornaram as transformações SQL versionáveis, testáveis e documentáveis.
-- models/daily_revenue.sql (dbt model)
-- Transforms raw sales data inside the warehouse

WITH raw_sales AS (
    SELECT
        sale_date,
        revenue,
        currency,
        exchange_rate
    FROM {{ source('raw', 'sales_events') }}
    WHERE revenue IS NOT NULL
),

normalized AS (
    SELECT
        sale_date,
        revenue * exchange_rate AS revenue_usd
    FROM raw_sales
)

SELECT
    sale_date,
    SUM(revenue_usd) AS total_revenue_usd,
    COUNT(*) AS transaction_count
FROM normalized
GROUP BY sale_date
O modelo dbt acima realiza a mesma transformação do exemplo Python anterior, porém executando diretamente no warehouse. A vantagem imediata é que não há necessidade de mover dados para um servidor externo, eliminando gargalos de rede e aproveitando o processamento distribuído nativo.
Estruturação de Projetos dbt para Pipelines ELT
Um projeto dbt bem estruturado segue convenções que facilitam a manutenção e o entendimento do fluxo de dados. A organização em camadas staging, intermediate e marts reflete a progressão dos dados desde a ingestão bruta até os modelos consumidos por ferramentas de BI.
# dbt_project.yml - Modern ELT project configuration
name: analytics_pipeline
version: "1.0.0"

models:
  analytics_pipeline:
    staging:             # 1:1 mappings from raw sources
      +materialized: view
      +schema: staging
    intermediate:        # Business logic, joins, calculations
      +materialized: ephemeral
    marts:               # Final tables consumed by BI tools
      +materialized: table
      +schema: analytics
A camada staging contém mapeamentos diretos das fontes brutas, geralmente como views para evitar duplicação de dados. Os modelos intermediários aplicam lógica de negócio e são frequentemente efêmeros, existindo apenas como CTEs durante a execução. Já os marts representam as tabelas finais otimizadas para consumo analítico.
Pronto para mandar bem nas entrevistas de Data Engineering?
Pratique com nossos simuladores interativos, flashcards e testes tecnicos.
Comparação Arquitetural: ETL versus ELT
A tabela abaixo apresenta as principais dimensões de comparação entre as duas arquiteturas.
| Dimensão | ETL | ELT |
|---|---|---|
| Local da transformação | Servidor intermediário | Dentro do data warehouse |
| Momento da transformação | Antes do carregamento | Após o carregamento |
| Dados armazenados | Apenas dados transformados | Dados brutos + transformados |
| Escalabilidade | Limitada pelo servidor ETL | Escalabilidade elástica do warehouse |
| Flexibilidade | Requer reprocessamento para mudanças | Transformações iterativas sobre dados brutos |
| Governança de dados | Dados sensíveis filtrados antes do warehouse | Requer controles adicionais no warehouse |
| Ferramentas típicas | Informatica, Talend, Apache Spark | Fivetran, Airbyte, dbt, Snowflake |
| Latência | Maior (processamento intermediário) | Menor (carregamento direto) |
Análise de Custos e Performance
A decisão entre ETL e ELT também envolve considerações financeiras significativas. A tabela seguinte compara cenários típicos de implementação.
| Métrica | ETL (EC2 + RDS) | ELT (Fivetran + Snowflake + dbt) |
|---|---|---|
| Custo de infraestrutura | Instâncias EC2 dedicadas (fixo) | Pay-per-query (variável) |
| Custo de armazenamento | Menor (dados já agregados) | Maior (dados brutos preservados) |
| Custo de desenvolvimento | Alto (código customizado) | Menor (ferramentas gerenciadas) |
| Tempo de implementação | Semanas a meses | Dias a semanas |
| Custo de manutenção | Equipe dedicada necessária | Manutenção reduzida |
| Escalabilidade de custo | Linear com volume | Sublinear com otimizações |
| TCO para 10TB/mês | Aproximadamente R$ 15.000-25.000 | Aproximadamente R$ 8.000-18.000 |
Carregar dados brutos diretamente no warehouse sem governança adequada representa um risco significativo de compliance. Informações pessoais identificáveis (PII), dados de saúde (HIPAA) e dados financeiros sensíveis requerem mascaramento ou pseudonimização antes do carregamento, mesmo em arquiteturas ELT.
O Padrão Híbrido: ETLT e Pipelines Compostos
Na prática, muitas organizações adotam uma abordagem híbrida que combina elementos de ambas as arquiteturas. O padrão ETLT aplica transformações leves durante a extração, como mascaramento de PII, seguido de carregamento de dados semi-brutos e transformações pesadas no warehouse.
# hybrid_pipeline.py
# Light ETL at extraction + heavy ELT in warehouse

def extract_and_mask(source: str) -> pd.DataFrame:
    """Extract with minimal transformation: PII masking only."""
    df = pd.read_json(source)
    # Mask email addresses before loading
    df["email"] = df["email"].apply(lambda e: hash_pii(e))
    # Remove raw IP addresses
    df.drop(columns=["ip_address"], inplace=True)
    return df

def load_raw(df: pd.DataFrame, warehouse) -> None:
    """Load masked but otherwise raw data to warehouse."""
    df.to_sql("raw_user_events", warehouse, if_exists="append", index=False)

# Heavy transformations happen in dbt inside the warehouse
# See: models/marts/user_engagement.sql
Essa abordagem preserva os benefícios do ELT (flexibilidade, escalabilidade, iteração rápida) enquanto endereça preocupações de segurança e compliance que impediriam o carregamento de dados verdadeiramente brutos.
O padrão ETLT está se tornando o novo padrão de facto em 2026. Ferramentas como Fivetran e Airbyte já oferecem transformações inline configuráveis para mascaramento de PII, enquanto dbt Cloud permite orquestração completa das transformações no warehouse. Essa convergência elimina a falsa dicotomia entre ETL e ELT.
Qualidade de Dados e Testes em Pipelines ELT
Uma vantagem significativa do ecossistema ELT moderno é a capacidade de implementar testes de qualidade de dados como parte do pipeline de transformação. O dbt permite definir expectativas sobre os dados que são validadas a cada execução.
# models/staging/stg_orders.yml
version: 2

models:
  - name: stg_orders
    description: "Cleaned orders from raw source"
    columns:
      - name: order_id
        tests:
          - unique           # No duplicate orders
          - not_null         # Every row has an ID
      - name: order_total
        tests:
          - not_null
          - dbt_utils.accepted_range:
              min_value: 0   # No negative totals
              max_value: 100000
      - name: customer_id
        tests:
          - not_null
          - relationships:   # Foreign key integrity
              to: ref('stg_customers')
              field: customer_id
Esses testes declarativos garantem integridade referencial, unicidade de chaves e validação de ranges, detectando anomalias nos dados antes que afetem dashboards e análises downstream.
Critérios de Decisão para Arquitetura de Pipelines
A escolha entre ETL, ELT ou abordagens híbridas depende de múltiplos fatores organizacionais e técnicos.
Cenários favoráveis ao ETL tradicional:
- Orçamento restrito para armazenamento cloud
- Requisitos rígidos de compliance que proíbem dados brutos no warehouse
- Fontes de dados com volume extremamente alto e baixo valor analítico
- Infraestrutura on-premises sem acesso a warehouses cloud-native
Cenários favoráveis ao ELT moderno:
- Necessidade de iteração rápida em modelos de dados
- Equipes de analytics que preferem SQL sobre Python
- Uso de warehouses cloud com separação de compute e storage
- Requisitos de auditoria que exigem preservação de dados brutos
Cenários favoráveis ao ETLT híbrido:
- Combinação de dados sensíveis e não sensíveis
- Migração gradual de pipelines ETL legados
- Múltiplas equipes com diferentes níveis de acesso aos dados
Tendências e Evolução da Arquitetura de Dados
O ecossistema de data engineering continua evoluindo rapidamente. Algumas tendências relevantes para 2026 incluem a consolidação de plataformas unificadas que combinam ingestão, transformação e orquestração, a adoção crescente de streaming ELT para casos de uso em tempo real, e a integração de governança de dados como componente nativo dos pipelines.
A distinção entre ETL e ELT está se tornando menos relevante à medida que as ferramentas modernas abstraem a complexidade subjacente. O foco está migrando para a modelagem semântica dos dados, a qualidade e observabilidade dos pipelines, e a capacidade de servir múltiplos casos de uso a partir de uma única fonte de verdade.
Conclusão
A arquitetura de pipelines de dados em 2026 oferece mais opções e flexibilidade do que nunca. Os pontos principais a considerar são:
- ETL permanece relevante para cenários com restrições de compliance ou infraestrutura on-premises
- ELT é a escolha predominante para organizações cloud-native que priorizam agilidade e escalabilidade
- ETLT híbrido combina o melhor dos dois mundos, aplicando transformações leves na extração e pesadas no warehouse
- Ferramentas como dbt revolucionaram a qualidade e testabilidade das transformações de dados
- A decisão deve ser guiada por requisitos de negócio, compliance, custos e capacidades da equipe
- Não existe resposta universal: a melhor arquitetura é aquela que atende aos requisitos específicos da organização
O domínio dessas arquiteturas e suas nuances representa uma competência essencial para engenheiros de dados que desejam projetar sistemas robustos, escaláveis e economicamente viáveis.
Comece a praticar!
Teste seus conhecimentos com nossos simuladores de entrevista e testes tecnicos.
Você saberia encontrar o bug em Data Engineering?
Um trecho real, um bug escondido, uma tentativa por dia. Sem conta para testar.

Escrito por
Anthony Fillion-MailletFundador da SharpSkill
Desenvolvedor fullstack há mais de 10 anos. Dirige a SharpSkill e responde por tudo o que é publicado aqui.
Atualizado em 13 de abril de 2026
Tags
Compartilhar
Artigos relacionados
Apache Spark com Python: construindo pipelines de dados passo a passo
Tutorial prático de PySpark cobrindo operações com DataFrame, construção de pipelines ETL e recursos do Spark 4.0. Inclui exemplos de código prontos para produção voltados a engenheiros de dados que se preparam para entrevistas técnicas.
Snowflake em 2026: arquitetura, SQL e perguntas de entrevista para engenheiro de dados
Um guia de 2026 sobre a arquitetura do Snowflake para engenheiros de dados: como armazenamento e computação se separam, como funcionam virtual warehouses e micro-partitions e as perguntas de entrevista que testam experiência de produção.
Top 25 Perguntas de Entrevista para Engenharia de Dados em 2026
Guia completo com as 25 perguntas mais relevantes para entrevistas de engenharia de dados em 2026. Inclui SQL, Spark, Kafka, ETL/ELT, modelagem de dados e design de pipelines.