RAG en LLMs in 2026: Retrieval-Augmented Generation voor Data Science Sollicitaties
Retrieval-Augmented Generation (RAG) uitgelegd voor data science sollicitaties in 2026. Behandelt vectordatabases, chunkingstrategieën, embedding-modellen, agentic RAG, Graph RAG en productieklare pipeline-architectuur.
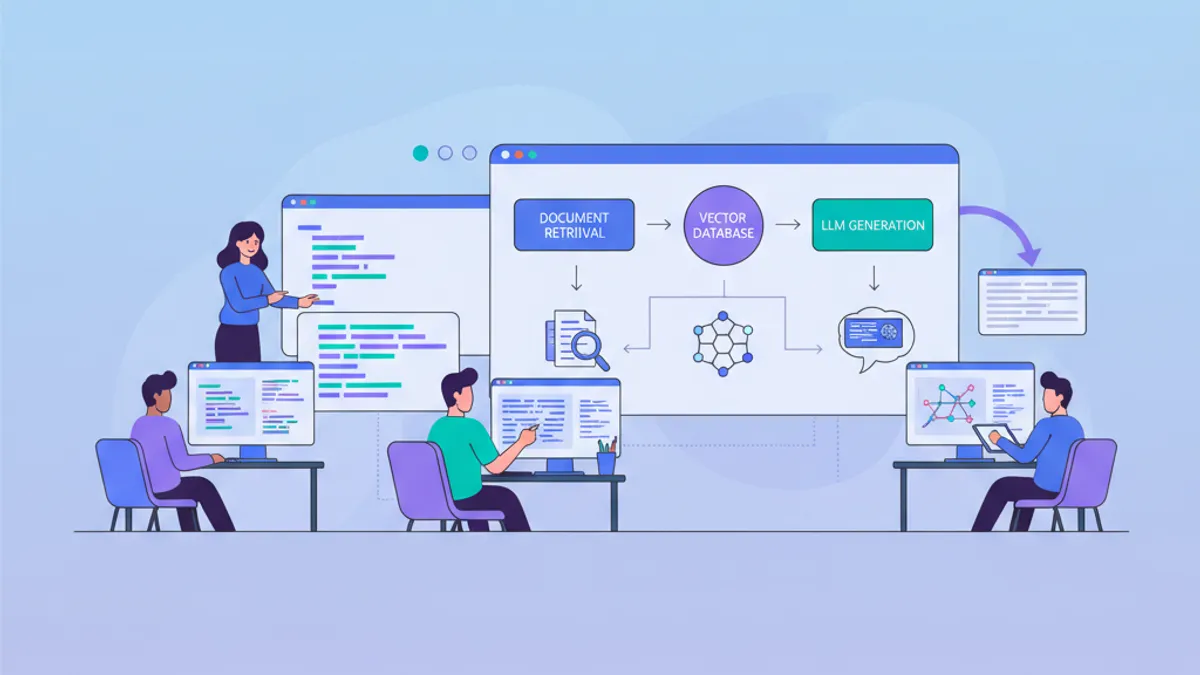
Retrieval-Augmented Generation (RAG) is uitgegroeid tot de standaardarchitectuur voor het verankeren van LLM-output in feitelijke, actuele data. Bij data science en AI engineering sollicitaties in 2026 verschijnen RAG-vragen inmiddels naast traditionele ML-onderwerpen, waarbij zowel systeemontwerp als praktische implementatievaardigheden worden getest.
Retrieval-Augmented Generation combineert een retrieval-systeem (vectorzoekopdrachten over een kennisbasis) met een LLM-generator, zodat het model antwoorden geeft op basis van echte documenten in plaats van te vertrouwen op gememoriseerde trainingsdata.
Hoe de RAG-pipeline End-to-End werkt
Een RAG-systeem werkt in twee fasen: een offline ingestiefase die de kennisbasis opbouwt, en een online queryfase die relevante context ophaalt en een antwoord genereert.
Tijdens ingestie doorlopen ruwe documenten schoonmaak, chunking en embedding voordat ze worden opgeslagen in een vectordatabase. Tijdens inferentie volgt de gebruikersquery hetzelfde embedding-pad, en nearest-neighbor search haalt de meest relevante chunks op. Deze chunks worden onderdeel van de LLM-prompt, waardoor het gegenereerde antwoord wordt verankerd in bronmateriaal.
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
Deze pipeline dekt de kern van de RAG-loop: chunk, embed, opslaan, ophalen, genereren. De parameter search_type="mmr" zorgt ervoor dat opgehaalde chunks zowel relevant als divers zijn, waardoor redundantie in het contextvenster wordt verminderd.
Chunkingstrategieën die er echt toe doen
Chunking bepaalt de retrieval-kwaliteit meer dan enig ander component. Slechte chunking betekent dat de retriever fragmenten teruggeeft die ofwel context missen of het signaal verdunnen met irrelevante inhoud.
Drie chunkingbenaderingen domineren productiesystemen in 2026:
Fixed-size chunking splitst tekst bij een vast aantal tokens (typisch 256 tot 512 tokens) met overlap. Eenvoudig te implementeren, maar breekt zinnen en ideeën midden in de tekst.
Semantische chunking detecteert themawisselingen door de embedding-similariteit tussen opeenvolgende zinnen te meten. Wanneer de similariteit onder een drempelwaarde zakt, begint een nieuwe chunk. Elke chunk draagt een samenhangend idee in plaats van een willekeurig stuk tekst.
Late chunking past het transformer-model eerst toe op het volledige document, produceert contextuele token-embeddings en splitst dan in chunks. Dit behoudt langafstandsafhankelijkheden die traditionele chunking vernietigt.
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
Het kernpunt voor sollicitaties: chunkgrootte is een precision-recall trade-off. Kleine chunks (100 tokens) verbeteren de retrieval-precisie maar fragmenteren context. Grote chunks (1000 tokens) behouden context maar verdunnen de embedding-specificiteit. De meeste productiesystemen zitten op 256 tot 512 tokens met 10 tot 20% overlap.
Vectordatabases en Embedding-modellen in Productie
De vectordatabase slaat embeddings op en ondersteunt snelle approximate nearest-neighbor (ANN) zoekopdrachten. De keuze van de juiste combinatie van embedding-model en vectordatabase beïnvloedt direct de retrieval-latency en nauwkeurigheid.
Embedding-modellen in 2026 zijn geconvergeerd rond enkele hoogpresterende opties. OpenAI's text-embedding-3-large (3072 dimensies) en open-source alternatieven zoals bge-m3 van BAAI of Cohere's embed-v4 bieden sterke meertalige retrieval. De MTEB-leaderboard blijft de standaard benchmark voor het vergelijken van embedding-kwaliteit. text-embedding-3-large ondersteunt Matryoshka representation learning, waardoor dimensie-truncatie (naar 1024 of 256) mogelijk is met minimaal kwaliteitsverlies, wat de opslagkosten aanzienlijk verlaagt.
De vectordatabase-markt is geconsolideerd in 2026. Vier producten beslaan het overgrote deel van de RAG-productie-workloads:
| Database | Indexering | Beheerd | Sterk punt |
|---|---|---|---|
| Pinecone | Proprietair | Ja | Zero-ops, ingebouwde inferentie, hybride zoeken |
| Weaviate | HNSW | Ja/Self | Native BM25 + dense fusie in één query |
| Qdrant | HNSW | Ja/Self | Rust-performance, payload-filtering, beste gratis tier |
| pgvector | IVF, HNSW | Self | PostgreSQL-integratie voor bestaande stacks |
Voor sollicitatiegesprekken is begrip van het HNSW-algoritme (Hierarchical Navigable Small World) essentieel: het bouwt een meerlagige graaf waarbij elk knooppunt verbonden is met zijn naaste buren, wat O(log n) zoekopdrachten mogelijk maakt tegen hogere geheugenkosten.
Het kostenkantelpunt ligt bij 60 tot 80 miljoen queries per maand. Daarboven onderbieded zelfgehost Qdrant of Weaviate op fixed-cost infrastructuur consistent managed Pinecone Serverless met 3x tot 10x.
Klaar om je Data Science & ML gesprekken te halen?
Oefen met onze interactieve simulatoren, flashcards en technische tests.
Hybride Retrieval: Dense en Sparse combineren
Pure vectorgebaseerde retrieval faalt bij exacte keyword-matches en zeldzame termen. Pure lexicale zoekopdrachten (BM25) missen semantische similariteit. Hybride retrieval combineert beide, en in 2026 is dit de standaard voor productie-RAG-systemen.
Het standaardpatroon gebruikt Reciprocal Rank Fusion (RRF) om gerangschikte resultaten van beide retrievers samen te voegen:
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
Hybride retrieval lost het "vocabulary mismatch" probleem op waarbij een gebruiker vraagt naar "het opzeggen van een abonnement" maar het relevante document de term "beëindigingsbeleid van de account" gebruikt. BM25 vangt de exacte termoverlap op, terwijl vectorzoekopdrachten de semantische relatie vastleggen.
Reranking: Het tweefase-filter
Retrieval levert kandidaten. Reranking sorteert ze op werkelijke relevantie. Cross-encoder rerankers zoals Cohere Rerank of bge-reranker-v2.5-gemma2-lightweight scoren elk query-documentpaar gezamenlijk, wat veel nauwkeurigere relevantiescores oplevert dan bi-encoder similariteit.
De tweefasige retrieval-pipeline (brede eerste-fase recall met top 50 tot 100 kandidaten via vector + BM25, daarna precies reranking naar top 5 tot 10 voor de prompt) is standaard in productiesystemen. Dit houdt de latency beheersbaar: de eerste fase gebruikt snelle ANN-zoekopdrachten, terwijl de dure cross-encoder alleen een kleine kandidatenset verwerkt.
Cross-encoders zijn nauwkeuriger dan bi-encoders omdat ze de query en het document samen door alle transformer-lagen verwerken. Bi-encoders embedden ze onafhankelijk, waardoor fijnmazige interactiesignalen verloren gaan. De trade-off is snelheid: cross-encoders kunnen niet worden voorgeïndexeerd.
Adaptieve RAG: Queries naar de juiste Pipeline routeren
Niet elke query heeft dezelfde retrieval-complexiteit nodig. Adaptieve RAG traint een kleine classifier om elke vraag naar het optimale pad te routeren:
- Geen retrieval voor eenvoudige feitelijke queries die het model al kent
- Eenstaps-retrieval voor matige queries
- Meerstaps iteratieve retrieval voor complexe redeneringen
Dit patroon balanceert kosten en nauwkeurigheid over gemengde workloads. Een productiesysteem dat 100.000 queries per dag verwerkt kan de inferentiekosten met 40% verlagen door eenvoudige vragen weg te routeren van dure meerstaps-pipelines.
De classifier zelf kan een klein fine-tuned model zijn of een zero-shot prompt die vraagt: "Heeft deze vraag externe kennis nodig om nauwkeurig te worden beantwoord?"
Speculatieve RAG: Latency inruilen voor Snelheid
Speculatieve RAG voert retrieval parallel uit met een snelle draft-generatie. Als de draft hoge confidence toont (gemeten via logprob), wordt de retrieval-stap volledig overgeslagen. Als de confidence laag is, wordt opgehaalde context samengevoegd met de draft en vindt regeneratie plaats.
Deze aanpak vermindert de gemiddelde latency met 30 tot 40% bij high-confidence queries. Het werkt het beste voor real-time chatbots, autocomplete-suggesties en klantenservicesystemen waar responstijd belangrijker is dan uitputtende bronvermelding bij elke query.
De trade-off: speculatieve RAG retourneert occasioneel antwoorden zonder verankering wanneer het model overconfident is. Productiesystemen combineren het met confidence-calibratie en fallback naar volledige retrieval wanneer onzekerheid een drempel overschrijdt.
Agentic RAG: Voorbij Single-Shot Retrieval
Naïeve RAG haalt eenmaal op en genereert. Agentic RAG behandelt het LLM als een redenerende agent die beslist wanneer op te halen, wat op te halen, en of de opgehaalde context voldoende is.
In 2026 is agentic RAG het dominante patroon voor complexe queries die meerstapsredenering vereisen. De agent kan:
- Zelfbeoordeling: Evalueren of opgehaalde documenten de vraag beantwoorden
- Herschrijven: De zoekopdracht herformuleren als initiële resultaten onvoldoende zijn
- Routeren: Kiezen tussen verschillende kennisbronnen (vector DB, SQL-database, API)
- Verifiëren: Feiten kruislings controleren over meerdere opgehaalde passages
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
Dit patroon (ophalen, beoordelen, eventueel herschrijven en opnieuw proberen) staat bekend als Corrective RAG (CRAG). LangChain's AgentExecutor is deprecated sinds 2026; nieuwe projecten moeten create_react_agent() gebruiken voor ingebouwde patronen of LangGraph's StateGraph voor aangepaste orkestratie. Voor diepgaandere behandeling van LangChain-patronen voor data scientists, zie het speciale artikel.
Graph RAG: Gestructureerde Kennisretrieval
Graph RAG extraheert entiteiten en relaties uit documenten naar een kennisgraaf, en bevraagt vervolgens zowel de graaf als de vectorstore. Deze architectuur vermindert hallucinaties bij feitelijke queries door antwoorden te verankeren in expliciete entiteitsrelaties in plaats van ongestructureerde tekstsimilariteit.
De ingestie-pipeline extraheert triples (subject, predicaat, object) uit elke document-chunk. Tijdens query-tijd identificeert het systeem relevante entiteiten in de vraag, traverseert de kennisgraaf voor verbonden feiten, en combineert graaf-opgehaalde context met vector-opgehaalde passages.
Graph RAG blinkt uit bij multi-hop redenervragen zoals "Welk team leidt het project dat het framework gebruikt dat in document X wordt genoemd?" Deze queries vereisen het verbinden van feiten over meerdere documenten, iets waar pure vectorzoekopdrachten mee worstelen omdat geen enkele chunk het volledige antwoord bevat.
Graph RAG verbetert de feitelijke nauwkeurigheid aanzienlijk (tot 40% reductie in hallucinaties bij entiteitsrijke queries) maar vereist een volwassen entity extraction pipeline. Onnauwkeurige extractie produceert een onnauwkeurige graaf, wat de resultaten kan verslechteren tot onder het niveau van naïeve RAG. Let op dat Microsoft's GraphRAG-project in 2026 in onderhoudsmodus is gegaan; het ontvangt bugfixes maar geen nieuwe features.
Microsoft's LazyGraphRAG-variant (uitgebracht juni 2025) vermindert de indexeringskosten drastisch door summarization uit te stellen tot query-tijd, waardoor het geschikt is voor exploratieve analyse of streaming data waar vooraf graaf-opbouw onpraktisch is.
EU AI Act Compliance voor RAG-systemen
De EU AI Act werd breed van toepassing in augustus 2026. De eerste spraakmakende boete onder de wet trof de RAG-chatbot van een Europees bankenconsortium eind mei 2026, en een Frankfurts vermogensbeheersbedrijf ontving in april 2026 een boete van 4,5 miljoen euro voor een klantgericht RAG-systeem dat de dataherkomst niet kon verklaren.
RAG-architecturen voldoen van nature aan verschillende compliance-eisen: brontraceerbaarheid (chunks dragen documentreferenties), antwoordtransparantie (citaties kunnen worden getoond), en controleerbaarheid (retrieval-logs bestaan per constructie). Volledige compliance vereist echter aanvullende maatregelen:
Risicoclassificatie: Een publieke chatbot valt onder beperkt risico (transparantie vereist). Een medisch of juridisch RAG-systeem is hoog risico met strengere documentatie- en toezichtsverplichtingen.
Audit logging: Vastleggen welke vraag welke opgehaalde chunks en welk antwoord heeft getriggerd. Dit log vormt de basis van de vereiste traceerbaarheid.
Menselijk toezicht: Hoog-risicosystemen vereisen menselijke validatie bij gevoelige gevallen, de mogelijkheid om outputs te corrigeren, en mechanismen om geïndexeerde data op verzoek te verwijderen.
Dataresidentie: Indexering hosten in de EU en BYOK (Bring Your Own Key) gebruiken om te verzekeren dat data niet via third-party accounts buiten de jurisdictie transiteert.
Niet-naleving kan 7% van de wereldwijde jaaromzet kosten. Voor sollicitatiegesprekken is het kernpunt dat RAG's inherente citeermogelijkheid een voordeel is, maar de governance-laag niet vervangt.
RAG-systemen evalueren: Metrieken die ertoe doen
RAG-evaluatie splitst zich in retrieval-metrieken en generatiemetrieken. Beide moeten onafhankelijk worden gemeten om storingen te diagnosticeren.
Retrieval-metrieken:
- Recall@k: Verschenen de relevante documenten in de top-k resultaten?
- MRR (Mean Reciprocal Rank): Hoe hoog is het eerste relevante resultaat gerankt?
- NDCG: Komt de rangschikking overeen met de ideale relevantievolgorde?
Generatiemetrieken:
- Faithfulness: Gebruikt het antwoord alleen informatie uit de opgehaalde context? (Meet hallucinaties)
- Answer Relevance: Beantwoordt het antwoord de oorspronkelijke vraag?
- Context Precision: Worden de opgehaalde chunks daadwerkelijk gebruikt in het antwoord?
Frameworks zoals Ragas en DeepEval automatiseren deze evaluaties met LLM-as-judge patronen. De top data science sollicitatievragen bevatten steeds vaker RAG-evaluatieontwerp, dus verwacht uit te leggen hoe te meten of een RAG-systeem correct werkt.
Failure Modes in Productie en Debugging
RAG-systemen falen op voorspelbare manieren. Kennis van deze patronen is essentieel voor zowel sollicitaties als real-world deployment.
Context window vervuiling treedt op wanneer te veel opgehaalde chunks het relevante signaal verdunnen. Het LLM ontvangt 10 chunks maar slechts 2 bevatten nuttige informatie. De oplossing: gebruik een reranker om te filteren en verlaag de top-k van de retriever.
Chunking-artefacten ontstaan wanneer fixed-size splitting zinnen, tabellen of codeblokken midden in een element doorbreekt. De opgehaalde chunk is syntactisch onvolledig en semantisch nutteloos. Semantische chunking of document-aware splitting (met respect voor headers, paragrafen, code fences) lost dit op.
Embedding drift ontstaat wanneer het embedding-model wordt bijgewerkt maar de vectorstore nog embeddings van het oude model bevat. Queries geëncodeerd met het nieuwe model zoeken in een vectorruimte gebouwd door het oude, wat de retrieval-kwaliteit verslechtert. Oplossing: het volledige corpus opnieuw embedden na elke modelwijziging.
Verouderde indexen leveren achterhaalde informatie omdat de ingestie-pipeline achterloopt op documentupdates. In machine learning systemen is dit analoog aan training-serving skew, waar het retrieval-systeem een andere datadistributie ziet dan wat in productie bestaat.
Bronnen
- Turing Post: 20 Advanced RAG Types to Know in 2026 - uitgebreide taxonomie van RAG-patronen
- LangChain and LangGraph 1.0 Milestones - deprecation van AgentExecutor, nieuwe patronen
- Microsoft GraphRAG GitHub - onderhoudsmodus status
- IgnitionRAG EU AI Act Guide - compliance-eisen voor RAG-systemen
- MarkTechPost: Best Vector Databases in 2026 - marktconsolidatie en prijzen
Begin met oefenen!
Test je kennis met onze gespreksimulatoren en technische tests.
Kernpunten voor RAG in Data Science Sollicitaties
- RAG combineert retrieval (vectorzoekopdrachten over een kennisbasis) met LLM-generatie om onderbouwde, feitelijke antwoorden te produceren zonder het model opnieuw te trainen
- De chunkingstrategie heeft de grootste impact op retrieval-kwaliteit; semantische chunking en late chunking presteren beter dan fixed-size splitting in de meeste gevallen
- Hybride retrieval (dense vectoren + sparse BM25) met Reciprocal Rank Fusion is de productiestandaard, die het vocabulary mismatch probleem oplost dat pure vectorzoekopdrachten niet aankunnen
- Cross-encoder rerankers voegen een precisielaag toe na brede retrieval, waarbij slechts een kleine kandidatenset wordt verwerkt om de latency acceptabel te houden
- Adaptieve RAG routeert queries naar gepaste pipeline-complexiteit, wat de kosten met 40% verlaagt bij gemengde workloads
- Speculatieve RAG ruilt verankering voor snelheid, wat de latency met 30 tot 40% vermindert bij high-confidence queries
- Agentic RAG (ophalen, beoordelen, herschrijven, opnieuw proberen) en Graph RAG (entiteitsrelatie-extractie) handelen complexe multi-hop queries af waar naïeve RAG faalt
- EU AI Act compliance (augustus 2026) vereist audit logging, menselijk toezicht en risicoclassificatie voor productie-RAG-systemen
- Evaluatie moet retrieval-metrieken (Recall@k, MRR) scheiden van generatiemetrieken (Faithfulness, Answer Relevance) om te diagnosticeren waar de pipeline faalt
- De meest voorkomende productiestoringen (contextvervuiling, chunking-artefacten, embedding drift, verouderde indexen) hebben allemaal eenvoudige oplossingen zodra ze zijn geïdentificeerd
Zie jij de bug in Data Science & ML?
Een echt codefragment, een verborgen bug, één poging per dag. Zonder account uit te proberen.

Geschreven door
Anthony Fillion-MailletOprichter van SharpSkill
Al meer dan 10 jaar fullstack-ontwikkelaar. Hij leidt SharpSkill en staat in voor alles wat hier verschijnt.
Bijgewerkt op 24 augustus 2026
Tags
Delen
Gerelateerde artikelen
LangChain voor Data Scientists in 2026: LLMs, Agents en Sollicitatievragen
Beheers LangChain 0.3 voor data science: LCEL-chains, RAG-patronen, ReAct-agents en memory-systemen. Inclusief sollicitatievragen en productie-deployment strategieën.
MLOps in 2026: MLflow, Model Registry en technische sollicitatievragen
MLOps-sollicitatievragen over de ML-levenscyclus, MLflow experiment tracking, promotie in de model registry, uitrolpatronen, driftmonitoring en systeemontwerp voor 2026, met Python-code en antwoorden.
Feature Engineering voor Machine Learning: Technieken en Interviewvragen 2026
Leer de belangrijkste feature engineering technieken voor machine learning interviews. Met Python-voorbeelden en veelgestelde data science interviewvragen.