C#ブログの作り方 2026年版:ASP.NET Core と Minimal APIs で技術ブログを構築する
.NET 10 と ASP.NET Core Minimal APIs で C# の技術ブログを構築する手順を解説します。Markdig による Markdown 解析、スレッドセーフなストア、出力キャッシュ、RSS フィード、面接で問われるポイントまで網羅します。
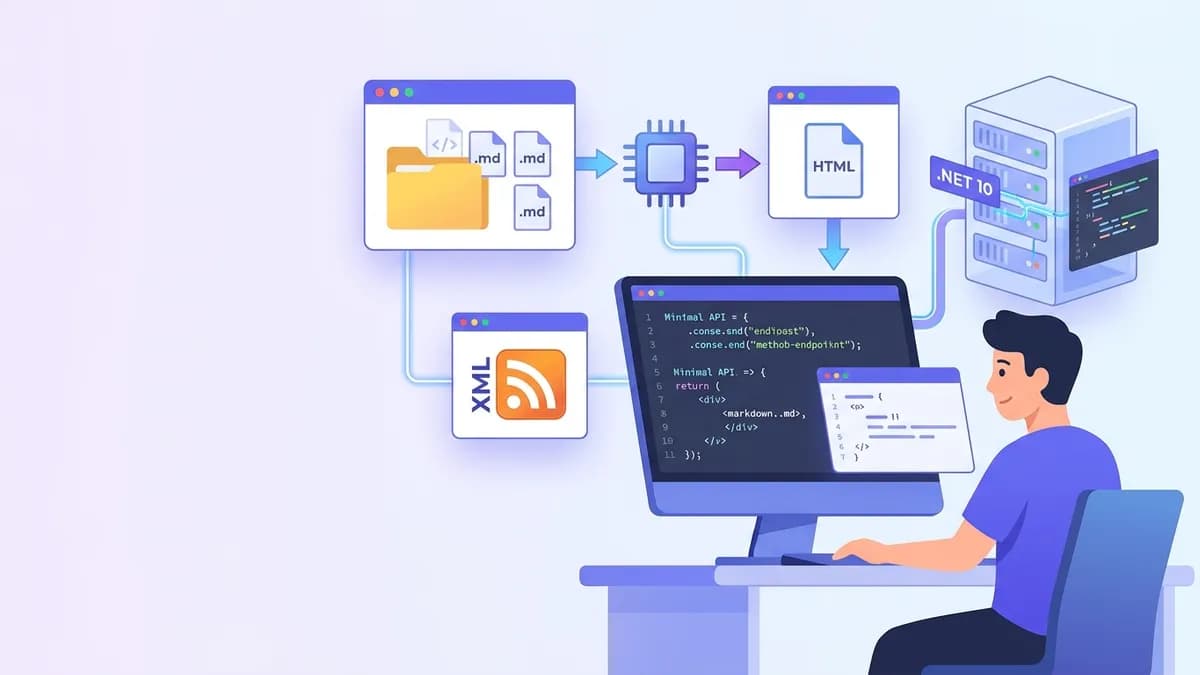
C#でブログを作る場合、ASP.NET Core の Minimal APIs を使えば必要なファイルはごくわずかです。ディスク上の Markdown 記事、それを一度だけ解析して保持するシングルトンのストア、HTML を返す数本のエンドポイント、そして RSS フィードがあれば成立します。2025年11月にリリースされた長期サポート版の .NET 10 では、これらの部品はすべてフレームワーク本体か、保守の行き届いた2つの NuGet パッケージでまかなえます。CMS もデータベースも必要ありません。
.NET 10 の Web プロジェクトに、Markdown から HTML への変換を担う Markdig、フロントマターを読む YamlDotNet、ファイル変更時に再読み込みされるイミュータブルなインメモリストア、RazorComponentResult でページを返す Minimal API エンドポイント、タグによる無効化を備えた出力キャッシュ、System.ServiceModel.Syndication による RSS 2.0 フィードを組み合わせます。エンジン全体は C# で300行に収まります。
静的サイトジェネレーターではなく Minimal API でブログエンジンを書く理由
Hugo や Jekyll のような静的サイトジェネレーターは、ビルド時に HTML ファイルを生成します。高速で運用コストも低い一方、テンプレートの範囲を超える機能、たとえば予約投稿、モバイルアプリ向けの JSON API、タグごとのフィード、アクセス解析との連携などは、すべてプラグインとして実装することになります。そのプラグインの言語は、.NET 開発者が日常的に使うものではありません。
ASP.NET Core 製のブログであれば、コンテンツは Git 管理の素の Markdown ファイルのまま保ち、最初のリクエストでレンダリングし、以降はメモリから返します。前段に出力キャッシュを置けば、1リクエストあたりのコストは静的ファイル配信とほぼ変わりません。しかも実行されるのは普通の C# コードなので、デバッグもテストも拡張も容易です。さらに、依存性注入、リクエストパイプライン、キャッシュ、並行処理という .NET の技術面接で必ず問われるテーマを、コンパクトなプロジェクトの中で一通り扱える点も見逃せません。
| 観点 | 静的サイトジェネレーター | ASP.NET Core Minimal API ブログ |
|---|---|---|
| コンテンツ形式 | Markdown + フロントマター | Markdown + フロントマター |
| レンダリングのタイミング | ビルド時 | 初回リクエスト時、以降はキャッシュ |
| 独自ロジック | プラグイン、テンプレート | 普通の C# エンドポイント |
| ホスティング | 任意の静的ホスティングや CDN | コンテナ、App Service、任意の VPS |
| コンテンツの即時反映 | 再ビルドと再デプロイ | ファイル監視がストアを再読み込み |
.NET 10 で ASP.NET Core ブログプロジェクトを準備する
出発点は空の Web テンプレートです。dotnet new web は Microsoft.NET.Sdk.Web SDK のプロジェクトを作成し、この SDK は追加設定なしで .razor コンポーネントをコンパイルできます。残りは3つのパッケージで足ります。CommonMark の解析には Markdig、フロントマターには YamlDotNet、フィードには System.ServiceModel.Syndication を使います。
# terminal
dotnet new web -n CSharpBlog --framework net10.0
cd CSharpBlog
dotnet add package Markdig
dotnet add package YamlDotNet
dotnet add package System.ServiceModel.Syndication
mkdir posts Posts Endpoints Components
すべての配線は Program.cs で行います。解析済みの記事は全リクエストで共有されるため、ポストストアはシングルトンとして登録します。出力キャッシュはエンドポイントより前のパイプラインに置くので、キャッシュ済みのレスポンスではハンドラーそのものが実行されません。
var builder = WebApplication.CreateBuilder(args);

// Site settings bound from the "Blog" section of appsettings.json
builder.Services.Configure<BlogOptions>(builder.Configuration.GetSection("Blog"));

builder.Services.AddSingleton<PostStore>();   // one parsed snapshot shared by all requests
builder.Services.AddRazorComponents();        // enables RazorComponentResult rendering
builder.Services.AddOpenApi();                // OpenAPI 3.1 document for the JSON API
builder.Services.AddOutputCache(options =>
    options.AddBasePolicy(policy => policy.Expire(TimeSpan.FromHours(1))));

var app = builder.Build();

app.MapStaticAssets();   // CSS and images from wwwroot, fingerprinted since .NET 9
app.UseOutputCache();    // must run before the endpoints it caches
app.MapOpenApi();

app.MapBlogEndpoints();
app.MapFeedEndpoints();

app.Run();

public sealed class BlogOptions
{
    public string Title { get; set; } = "C# Notes";
    public string SiteUrl { get; set; } = "https://localhost:5001/";
}
SiteUrl の設定は後で重要になります。canonical リンクやフィードの URL は、受信した Host ヘッダーからではなく、必ず構成値から組み立てます。
C# でフロントマター付き Markdown 記事を解析する
記事は posts/output-caching-dotnet-10.md のようなファイルとして置きます。ファイル名がそのままスラッグになり、先頭の YAML ブロックにメタデータを記述します。
---
title: Output caching in .NET 10
summary: How tag-based eviction keeps cached pages fresh.
date: 2026-11-10
tags: [aspnet-core, performance]
draft: false
---
Output caching stores the full response on the server...
パーサーは YAML ブロックと本文を切り分け、メタデータを小さなクラスにデシリアライズし、本文を HTML に変換します。最初に改行コードを正規化している点に注意してください。これを省くと、Windows で保存された記事で --- 区切りの検索が失敗します。
using Markdig;
using YamlDotNet.Serialization;
using YamlDotNet.Serialization.NamingConventions;

public sealed record Post(string Slug, string Title, string Summary,
    DateTime PublishedOn, IReadOnlyList<string> Tags, bool Draft, string Html);

public static class PostParser
{
    // Built once and reused by every reload
    private static readonly MarkdownPipeline Pipeline =
        new MarkdownPipelineBuilder().UseAdvancedExtensions().Build();

    private static readonly IDeserializer Yaml = new DeserializerBuilder()
        .WithNamingConvention(CamelCaseNamingConvention.Instance)
        .IgnoreUnmatchedProperties()   // unknown keys do not crash the reload
        .Build();

    public static Post Parse(string slug, string text)
    {
        text = text.ReplaceLineEndings("\n");
        if (!text.StartsWith("---\n"))
            throw new FormatException($"{slug}: missing front matter");

        var end = text.IndexOf("\n---", 4, StringComparison.Ordinal);
        if (end < 0)
            throw new FormatException($"{slug}: unterminated front matter");

        var meta = Yaml.Deserialize<FrontMatter>(text[4..end]);
        var html = Markdown.ToHtml(text[(end + 4)..], Pipeline);

        return new Post(slug, meta.Title, meta.Summary, meta.Date, meta.Tags, meta.Draft, html);
    }

    private sealed class FrontMatter
    {
        public string Title { get; set; } = "";
        public string Summary { get; set; } = "";
        public DateTime Date { get; set; }
        public List<string> Tags { get; set; } = [];
        public bool Draft { get; set; }
    }
}
UseAdvancedExtensions() を呼ぶと、表、脚注、タスクリスト、見出しへの自動 ID 付与など、技術ブログに必要な Markdig の拡張機能がまとめて有効になります。なお Markdig は既定で生の HTML をそのまま出力します。サイト運営者自身が書く記事であれば問題ありませんが、コメントやゲスト投稿などユーザーが入力する Markdown を扱うパイプラインでは、格納型 XSS を防ぐために DisableHtml() を必ず指定します。
ホットリロードに対応したスレッドセーフなシングルトンストア
ストアは起動時にすべてのファイルを読み込み、結果を FrozenDictionary(.NET 8 以降で利用可能)に保持します。これは読み取り中心の検索に最適化されたコレクションです。ファイルが変更されると、ストアは新しいディクショナリを丸ごと構築し、1回の代入で参照を差し替えます。読み取り側はロックを一切取りません。各リクエストが見るのは古いスナップショットか新しいスナップショットのどちらかであり、構築途中のコレクションを目にすることはありません。
using System.Collections.Frozen;
using Microsoft.AspNetCore.OutputCaching;
using Microsoft.Extensions.FileProviders;
using Microsoft.Extensions.Primitives;

public sealed class PostStore
{
    private readonly PhysicalFileProvider _files;
    private readonly IOutputCacheStore _cache;
    private readonly ILogger<PostStore> _logger;
    private volatile FrozenDictionary<string, Post> _bySlug = FrozenDictionary<string, Post>.Empty;

    public PostStore(IWebHostEnvironment env, IOutputCacheStore cache, ILogger<PostStore> logger)
    {
        (_cache, _logger) = (cache, logger);
        _files = new PhysicalFileProvider(Path.Combine(env.ContentRootPath, "posts"));
        Reload();
        ChangeToken.OnChange(() => _files.Watch("*.md"), Reload);   // re-registers after each change
    }

    public Post? Find(string slug) => _bySlug.TryGetValue(slug, out var post) ? post : null;

    public IReadOnlyList<Post> Latest(int count) =>
        _bySlug.Values.OrderByDescending(p => p.PublishedOn).Take(count).ToList();

    private void Reload()
    {
        try
        {
            var snapshot = _files.GetDirectoryContents("")
                .Where(f => !f.IsDirectory && f.Name.EndsWith(".md", StringComparison.Ordinal))
                .Select(f => PostParser.Parse(Path.GetFileNameWithoutExtension(f.Name), File.ReadAllText(f.PhysicalPath!)))
                .Where(p => !p.Draft)
                .ToFrozenDictionary(p => p.Slug);

            _bySlug = snapshot;   // atomic reference swap
            _ = _cache.EvictByTagAsync("posts", CancellationToken.None).AsTask();
            _logger.LogInformation("Loaded {Count} posts", snapshot.Count);
        }
        catch (Exception ex)
        {
            _logger.LogError(ex, "Reload failed, keeping the previous snapshot");   // a typo never takes the site down
        }
    }
}
このコードを本番運用に耐えるものにしているのは3つの工夫です。まず volatile フィールドにより、差し替え後は他のスレッドからも最新の参照が読まれることが保証されます。次に try/catch によって、ある記事の YAML が壊れていても直前の正常なスナップショットが維持されるため、1ファイルのタイプミスでブログが空になることはありません。最後に EvictByTagAsync の呼び出しで posts タグの付いたキャッシュ済みページがすべて破棄され、新しい内容は1時間の有効期限を待たずに次のリクエストから反映されます。
FileSystemWatcher は OS の通知に依存しており、この通知は Docker のバインドマウントやネットワーク共有を確実には越えられません。posts フォルダーをマウントするコンテナでは、環境変数 DOTNET_USE_POLLING_FILE_WATCHER=true を設定するか、PhysicalFileProvider.UsePollingFileWatcher = true を指定します。また、エディターは1回の保存を複数回の書き込みに分けて行うことがあるため、Reload が1回の保存で2、3回走る場合があります。とはいえ毎回同じスナップショットが生成されるだけなので、ここでは実害はありません。
ルートグループと TypedResults による Minimal API エンドポイント
公開ページは MapGroup で /blog 配下にまとめます。こうすることで、出力キャッシュのポリシーとそのタグを1か所で全エンドポイントに適用できます。ハンドラーは .NET 8 から使える RazorComponentResult<T> を返します。これにより、MVC や Razor Pages、Blazor のルーターを使わずに、Razor コンポーネントを HTTP レスポンス全体としてレンダリングできます。
using CSharpBlog.Components;   // namespace of PostPage and PostListPage
using Microsoft.AspNetCore.Http.HttpResults;

public static class BlogEndpoints
{
    public static IEndpointRouteBuilder MapBlogEndpoints(this IEndpointRouteBuilder app)
    {
        var blog = app.MapGroup("/blog").CacheOutput(p => p.Tag("posts"));

        blog.MapGet("/", (PostStore store) =>
            new RazorComponentResult<PostListPage>(new { Posts = store.Latest(20) }));

        blog.MapGet("/{slug:regex(^[a-z0-9-]+$)}", GetPost);   // rejects odd slugs before the handler

        app.MapGet("/api/posts", (PostStore store) =>
                TypedResults.Ok(store.Latest(50).Select(p => new PostSummary(p.Slug, p.Title, p.Summary, p.PublishedOn))))
            .CacheOutput(p => p.Tag("posts"))
            .WithName("ListPosts");

        return app;
    }

    // The union return type documents both outcomes for OpenAPI and for unit tests
    private static Results<RazorComponentResult<PostPage>, NotFound> GetPost(string slug, PostStore store) =>
        store.Find(slug) is { } post
            ? new RazorComponentResult<PostPage>(new { Post = post })
            : TypedResults.NotFound();
}

public sealed record PostSummary(string Slug, string Title, string Summary, DateTime PublishedOn);
TypedResults と旧来の Results ヘルパーを分けるのが、この Results<T1, T2> という戻り値の型です。ハンドラーが宣言した結果以外を返さないことをコンパイラーが検証し、OpenAPI ジェネレーターはシグネチャから2つのステータスコードを読み取り、単体テストではサーバーを起動せずに result.Result is NotFound を検証できます。JSON エンドポイントを /blog グループの外に置いているのは、その URL が記事のスラッグと衝突しないようにするためです。
記事ページは通常の Razor コンポーネントです。MarkupString は Markdig の出力をエンコードせず HTML として出力するよう Razor に指示するもので、canonical URL は BlogOptions から組み立てます。
@* Components/PostPage.razor *@
@using Microsoft.Extensions.Options
@inject IOptions<BlogOptions> Options

<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="utf-8" />
    <title>@Post.Title | @Options.Value.Title</title>
    <meta name="description" content="@Post.Summary" />
    <link rel="canonical" href="@(new Uri(new Uri(Options.Value.SiteUrl), $"blog/{Post.Slug}"))" />
    <link rel="alternate" type="application/rss+xml" title="@Options.Value.Title" href="/feed.xml" />
    <link rel="stylesheet" href="/site.css" />
</head>
<body>
    <article>
        <h1>@Post.Title</h1>
        <time datetime="@(Post.PublishedOn.ToString("yyyy-MM-dd"))">@(Post.PublishedOn.ToString("d MMMM yyyy"))</time>
        @((MarkupString)Post.Html)
    </article>
</body>
</html>

@code {
    [Parameter, EditorRequired] public Post Post { get; set; } = default!;
}
PostListPage.razor も同じ構成で、Posts パラメーターを受け取り、タイトルと概要をループで表示します。RazorComponentResult に渡す匿名オブジェクトのプロパティ名はコンポーネントのパラメーターに対応付けられるため、new { Post = post } の名前は Post パラメーターと完全に一致している必要があります。
.NETの面接対策はできていますか?
インタラクティブなシミュレーター、flashcards、技術テストで練習しましょう。
ASP.NET Core ブログのページに出力キャッシュを適用する
ASP.NET Core 7 で導入された出力キャッシュは、レスポンス全体をサーバー側に保存し、ハンドラーの実行やコンポーネントの再レンダリングなしに再送します。これは旧来のレスポンスキャッシュミドルウェアとは別物です。後者は HTTP の Cache-Control のセマンティクスに従うため、クライアントが no-cache ヘッダーを送ればキャッシュを回避できてしまいます。既定のルールは Microsoft Learn の出力キャッシュに関するドキュメントに詳しく書かれています。キャッシュされるのは 200 を返す GET と HEAD のリクエストだけで、Cookie を設定するレスポンスや認証済みリクエストのレスポンスは対象外です。
出力キャッシュをコンテンツサイトに適したものにしているのがタグです。ブログのすべてのエンドポイントに posts タグが付いており、ストアは再読み込みのたびにこのタグを破棄します。1時間の基本ポリシーはあくまで保険であり、実際にはコンテンツが変わるまでページはキャッシュされ続けます。
複数インスタンスで運用する場合、インメモリのストアはプロセスごとに独立しています。1つのインスタンスで破棄しても、他のインスタンスには古い内容が残ります。ASP.NET Core は Microsoft.AspNetCore.OutputCaching.StackExchangeRedis パッケージと AddStackExchangeRedisOutputCache によって Redis をバックエンドとするストアを提供しており、キャッシュエントリと破棄をインスタンス間で共有できます。小規模なインスタンス1台で運用するなら不要です。
SyndicationFeed で C# から RSS フィードを生成する
技術系の読者はいまもフィードリーダーで購読しており、アグリゲーターもサイトマップではなくフィードから新着記事を拾います。SyndicationFeed と Rss20FeedFormatter を使えば、XML を手書きすることなく RSS 2.0 仕様に準拠したフィードを出力できます。
using System.ServiceModel.Syndication;
using System.Text;
using System.Xml;
using Microsoft.Extensions.Options;

public static class FeedEndpoints
{
    public static IEndpointRouteBuilder MapFeedEndpoints(this IEndpointRouteBuilder app)
    {
        app.MapGet("/feed.xml", (PostStore store, IOptions<BlogOptions> options) =>
        {
            var site = new Uri(options.Value.SiteUrl);   // never built from the Host header
            var items = store.Latest(20).Select(p =>
            {
                var date = new DateTimeOffset(DateTime.SpecifyKind(p.PublishedOn, DateTimeKind.Utc));
                return new SyndicationItem(p.Title, p.Summary, new Uri(site, $"blog/{p.Slug}"), p.Slug, date)
                {
                    PublishDate = date   // RSS pubDate comes from PublishDate, not LastUpdatedTime
                };
            });

            var feed = new SyndicationFeed(options.Value.Title, "Articles on C# and .NET", site, items);

            using var buffer = new MemoryStream();
            using (var writer = XmlWriter.Create(buffer, new XmlWriterSettings { Encoding = new UTF8Encoding(false) }))
                new Rss20FeedFormatter(feed).WriteTo(writer);   // writer flushes on dispose

            return TypedResults.Bytes(buffer.ToArray(), "application/rss+xml; charset=utf-8");
        }).CacheOutput(p => p.Tag("posts"));

        return app;
    }
}
絶対 URL を HttpContext.Request.Host ではなく BlogOptions.SiteUrl から組み立てることで、Host ヘッダーインジェクションを防いでいます。これを怠ると、Host を偽装したリクエストが1回届いただけでその結果がキャッシュされ、別ドメインを指すリンクを含むフィードが全購読者に配信されてしまいます。UTF8Encoding(false) の引数はバイトオーダーマークを取り除くためのもので、BOM 付きのフィードを受け付けないリーダーも存在します。
C# 技術ブログのデプロイと Native AOT の制約
dotnet publish -c Release を実行すると、.NET 10 ランタイムがあればどのホストでも動くフレームワーク依存のビルドが得られます。.NET 8 以降は SDK が Dockerfile なしでコンテナイメージをビルドすることもでき、dotnet publish -c Release /t:PublishContainer で公式の ASP.NET Core ランタイムイメージをベースにしたイメージが作成されます。posts フォルダーはイメージに焼き込む方法(コンテンツ変更には再デプロイが必要)と、ボリュームとしてマウントする方法(変更はファイル監視が拾う)のどちらも選べます。
起動時間とメモリ使用量の面で Native AOT は魅力的ですが、このプロジェクトには向きません。ASP.NET Core の Native AOT 互換性一覧では、Minimal APIs は部分的なサポート、Blazor Server は非サポートとされており、YamlDotNet の既定のデシリアライザーもリフレクションに依存しています。ブログは常駐プロセスからキャッシュ済みページを返すものなので、起動時間はほとんど問題になりません。AOT に切り替えるには Razor コンポーネントを文字列テンプレートに、YAML をソースジェネレーター対応の JSON フロントマターに置き換える必要があり、得られるものに比べて手間が大きすぎます。
このブログプロジェクトで備えられる .NET 面接の質問
エンジンの各部品は、ASP.NET Core の面接で実際に出る質問に対応しています。SharpSkill の .NET 面接対策問題ではこれらを詳しく扱っており、エンドポイント側に焦点を当てたものとしては Minimal APIs モジュールがあります。
「多数のリクエストから同時に読まれるシングルトンサービスは安全か」 状態がイミュータブルであるか、同期されている場合に限り安全です。上のストアはイミュータブルなスナップショットと volatile な参照の差し替えを使っているため、読み取り側はロックを取らず、書き込み側も読み取りをブロックしません。典型的な落とし穴は、再読み込み中に変更される List<T> をシングルトンが持っているケースで、負荷がかかると列挙の途中で InvalidOperationException が発生します。依存性注入モジュールでは、キャプティブ依存の問題も取り上げています。これは DbContext のようなスコープ付きサービスを受け取ったシングルトンが、そのサービスをアプリケーションの存続期間中ずっと保持してしまう問題です。
「出力キャッシュとレスポンスキャッシュの違いは何か」 出力キャッシュはサーバー側で制御され、タグと破棄をサポートし、クライアントのキャッシュヘッダーを無視します。レスポンスキャッシュは HTTP のセマンティクスに従い、主にプロキシやブラウザーへのヒントとして機能します。
「なぜ Results ではなく TypedResults を返すのか」 具体的な結果型を使うと、起こりうる結果がコンパイル時に検証され、OpenAPI のメタデータが自動で付与され、ハンドラーを普通のメソッドとしてテストできます。コントローラーとのより踏み込んだ比較は、Minimal APIs のアーキテクチャとパフォーマンスに関する記事で解説しています。
「このアプリでミドルウェアの順序が効いてくるのはどこか」 UseOutputCache はキャッシュ対象のエンドポイントより前に登録し、CORS を有効にしている場合は UseCors より後に置く必要があります。さらに、既定のポリシーが認証済みリクエストを決してキャッシュしない理由と、それをキャッシュするためにカスタムの IOutputCachePolicy が何を確認すべきかまで説明できれば、順序を暗記しているだけでなくパイプラインを理解していることが伝わります。
ASP.NET Core で C# ブログを作るためのまとめ
- .NET 10 の
dotnet new webから始め、追加するのは Markdig、YamlDotNet、System.ServiceModel.Syndicationだけにとどめます。技術ブログに CMS やデータベースは不要です。 - 記事は一度だけ解析してイミュータブルな
FrozenDictionaryに格納し、再読み込み時はスナップショット全体を差し替えます。これで読み取り側はロック不要になり、壊れたファイルがあってもサイトが空になりません。 - Minimal API のハンドラーから
RazorComponentResult<T>で HTML をレンダリングし、戻り値の型をResults<T1, T2>で宣言して、OpenAPI と単体テストからすべての結果が見えるようにします。 - コンテンツ系のエンドポイントはすべて共通タグ付きの出力キャッシュの後ろに置き、短い有効期限に頼るのではなく、再読み込みのたびに
EvictByTagAsyncを呼び出します。 - canonical とフィードの URL は
Hostヘッダーではなく構成値から組み立て、ユーザー入力の Markdown をレンダリングするパイプラインではDisableHtml()を有効にします。 postsフォルダーをコンテナにマウントする場合はDOTNET_USE_POLLING_FILE_WATCHER=trueを設定します。- このプロジェクトを面接練習の題材として活用し、シングルトンのスレッドセーフ性、キャッシュ方式の選択、ミドルウェアの順序を自分の言葉で説明できるようにしておきます。
今すぐ練習を始めましょう!
面接シミュレーターと技術テストで知識をテストしましょう。
.NET のバグを見つけられますか
実際のコード、隠れたバグ、1日1回。アカウントなしで試せます。
執筆
Anthony Fillion-MailletSharpSkill 創業者
10 年以上フルスタック開発に携わっています。SharpSkill を運営し、ここで公開される内容に責任を負っています。
2026年11月17日 更新
タグ
共有
関連記事
ASP.NET CoreにおけるDbContextのライフタイム管理:非同期操作でのパフォーマンスとスレッドセーフティ
ASP.NET CoreでのDbContextライフタイム管理を解説します。スコープ付きライフタイムとトランジェントの使い分け、非同期操作でのスレッドセーフティ、DbContextプーリングによるパフォーマンス最適化について学びます。
.NET 9 Blazor:Blazor Unitedによるフルスタック開発ガイド 2026年版
.NET 9のBlazor Unitedは、静的SSR・Server・WebAssemblyの3つのレンダリングモードを統合したフルスタックフレームワークである。レンダリングモードの使い分け、ストリーミングレンダリング、コンストラクタインジェクション、本番環境向けパターンを実践的に解説する。
Entity Framework Core:2026年のパフォーマンス最適化とベストプラクティス
EF Core 10のパフォーマンス最適化を解説。AsNoTracking、コンパイル済みクエリ、バッチ操作、スプリットクエリ、LeftJoin演算子など、.NET 10アプリケーション向けの実践的なC#コード例を紹介します。