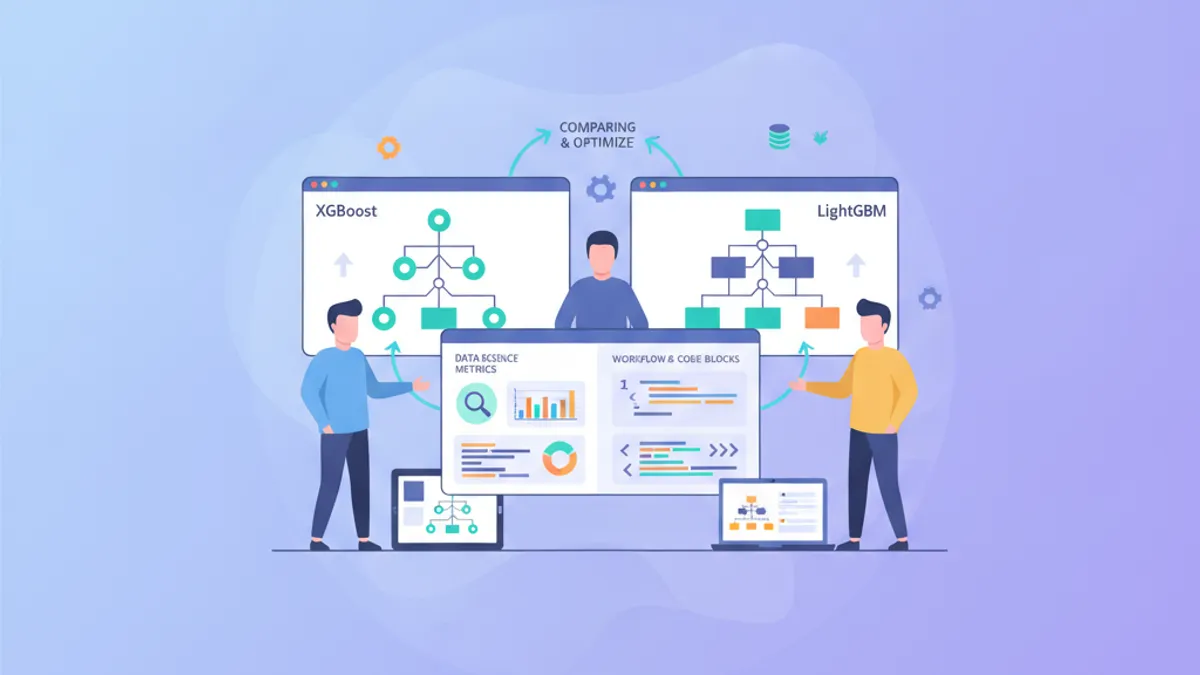
XGBoost vs LightGBM 2026年徹底比較:勾配ブースティングとデータサイエンス面接対策
XGBoostとLightGBMの違いを詳しく解説します。勾配ブースティングのアルゴリズム、ハイパーパラメータチューニング、面接でよく聞かれる質問と回答例を網羅的に紹介します。
Pythonを主要言語としたData Scienceと機械学習の包括的カリキュラムです。PandasとNumPyによるデータ操作から、TensorFlow/KerasによるDeep Learningモデルの実装、Scikit-Learnによるクラシック機械学習まで学びます。Docker、FastAPI、クラウドプラットフォームを使用したモデルの本番デプロイと保守のためのMLOpsスキルも含みます。
オブジェクト指向プログラミングとベストプラクティスを備えたモダンPython
Pandas、NumPy、SQL(BigQuery)によるデータ操作
Matplotlib、Seaborn、Plotlyによる可視化
Statsmodelによる記述統計と推測統計
Scikit-LearnとXGBoostによる機械学習(回帰、分類、クラスタリング)
TensorFlowとKerasによるDeep Learning(CNN、RNN、Transformers)
Hugging Face、LangChain、LLMs(GPT、Gemini)によるNLPとGenAI
MLflow、Docker、FastAPI、StreamlitによるMLOps
開発環境: Jupyter、Google Colab
Google Compute、Cloud Storage、GPUによるクラウドデプロイ
この技術を理解し面接で成功するための最も重要な概念
Python: 型、データ構造、OOP、デコレーター、ジェネレーター、コンテキストマネージャー
NumPy: 配列、broadcasting、indexing、ベクトル演算、線形代数
Pandas: DataFrames、Series、indexing、groupby、merge、pivot、時系列
SQL: SELECT、JOIN、GROUP BY、window functions、CTEs、クエリ最適化
可視化: Matplotlib(figures、axes、subplots)、Seaborn(統計プロット)、Plotly(インタラクティブ)
統計: 分布、仮説検定、信頼区間、回帰
特徴量エンジニアリング: エンコーディング、スケーリング、特徴量選択、特徴量作成
教師あり機械学習: 線形/ロジスティック回帰、決定木、Random Forest、XGBoost、メトリクス
教師なし機械学習: K-Means、階層的クラスタリング、PCA、t-SNE
機械学習パイプライン: train/test split、cross-validation、ハイパーパラメータチューニング、過学習
Deep Learning: パーセプトロン、誤差逆伝播、活性化関数、オプティマイザー、損失関数
CNN: 畳み込み、pooling、アーキテクチャ(ResNet、VGG)、転移学習
RNN/LSTM: シーケンス、勾配消失、アテンションメカニズム、Transformers
NLP: トークナイゼーション、embeddings、word2vec、BERT、LLMファインチューニング
MLOps: バージョニング(MLflow)、コンテナ化(Docker)、API(FastAPI)、モニタリング
Cloud: Google Cloud(Compute、Storage、BigQuery)、GPUトレーニング、Vertex AI
AI倫理: バイアス、説明可能性(SHAP、LIME)、公平性、GDPR
1日1つのコード。バグを見つけるか、バグがないことを示してください。
正社員とフリーランス、国、リモート、公開されていれば給与も。毎日更新、サブスクリプション登録者限定。
Data Science & MLに関する最新の記事とガイドをご覧ください
XGBoostとLightGBMの違いを詳しく解説します。勾配ブースティングのアルゴリズム、ハイパーパラメータチューニング、面接でよく聞かれる質問と回答例を網羅的に紹介します。
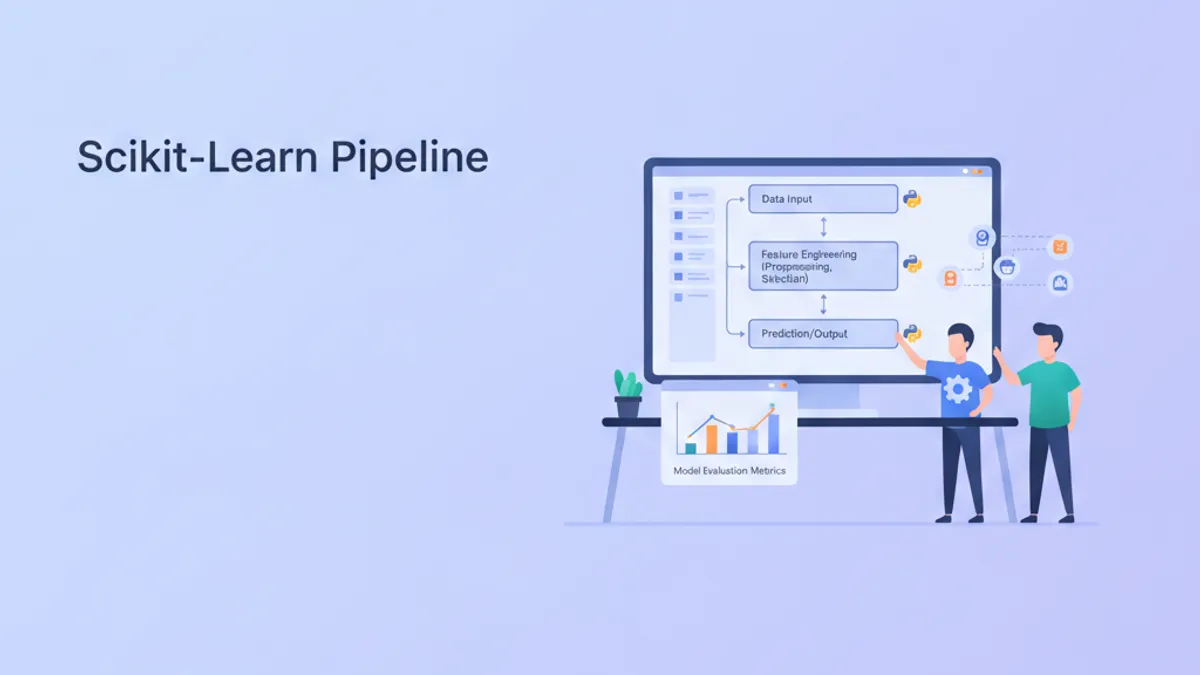
Scikit-Learn Pipelineを使用した特徴量エンジニアリングの実践ガイド。ColumnTransformer、カスタムTransformer、GridSearchCVによるハイパーパラメータチューニング、本番デプロイメントのベストプラクティスを解説します。
データサイエンス面接に必要な統計学を解説。確率分布、仮説検定、p値の解釈、A/Bテスト、そして2026年の技術面接で頻出する質問と回答例を詳しく紹介します。