Spring Boot Micrometer e Prometheus: metriche Actuator in produzione
Integrazione di Spring Boot Micrometer e Prometheus su Spring Boot 4: modello di accesso Actuator, scrape config, metriche HTTP, health probe e regole di alerting.
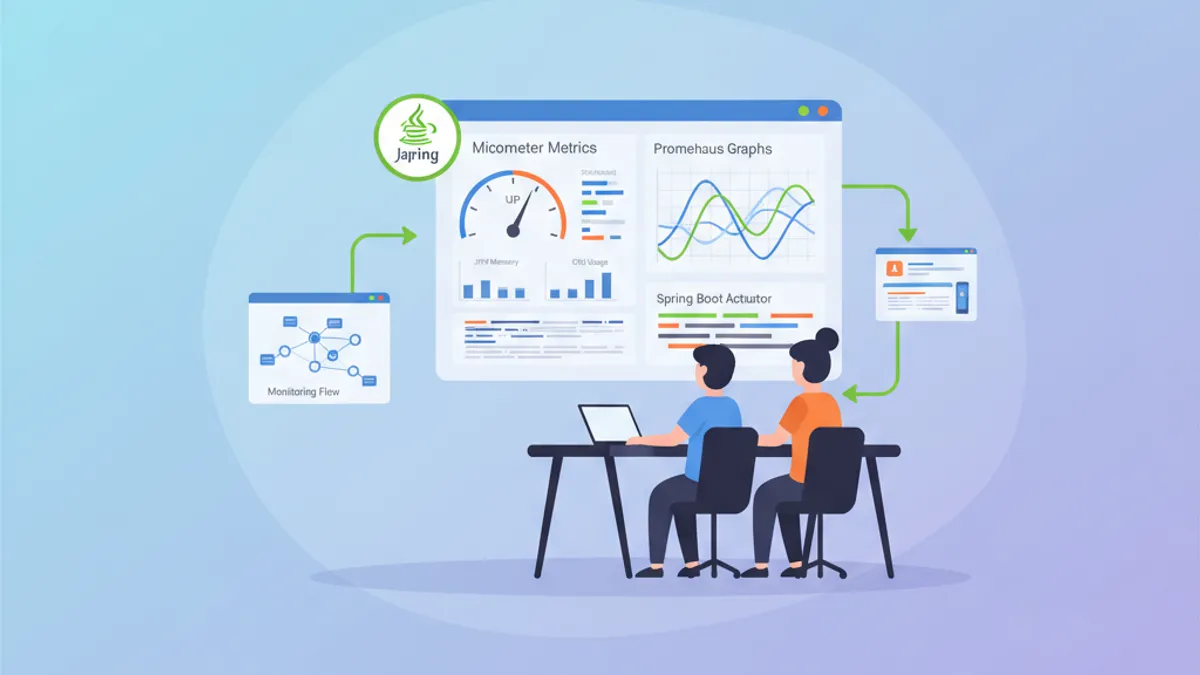
Spring Boot Actuator espone endpoint di salute, metriche e diagnostica, e Micrometer è la facciata per le metriche che sta dietro. Aggiungendo la dipendenza micrometer-registry-prometheus si ottiene un endpoint /actuator/prometheus che Prometheus interroga a intervalli fissi. Gli esempi seguenti si basano su Spring Boot 4.1 (release GA corrente, con la 4.2 in release candidate), Micrometer 1.16 e il client Java di Prometheus 1.x.
L'integrazione di Spring Boot Micrometer con Prometheus richiede tre passaggi: aggiungere spring-boot-starter-actuator e micrometer-registry-prometheus, inserire prometheus in management.endpoints.web.exposure.include, quindi puntare una scrape_config di Prometheus su /actuator/prometheus. Le metriche JVM, HTTP, HikariCP e di sistema vengono pubblicate senza codice aggiuntivo.
Configurare Spring Boot Micrometer: Actuator e il registry Prometheus
Dipendenze Maven Necessarie
Lo starter Actuator abilita gli endpoint e porta con sé Micrometer. Il registry Prometheus formatta ogni meter nel formato di esposizione di Prometheus. Lo starter AspectJ serve solo per le annotazioni @Timed e @Counted.
<!-- pom.xml -->
<!-- Actuator + Micrometer + Prometheus (Spring Boot 4.x) -->
<dependencies>
    <!-- Spring Boot Actuator: monitoring endpoints, includes Micrometer -->
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-actuator</artifactId>
    </dependency>

    <!-- Micrometer Registry Prometheus (Prometheus Java client 1.x) -->
    <!-- Exposes metrics in Prometheus format at /actuator/prometheus -->
    <dependency>
        <groupId>io.micrometer</groupId>
        <artifactId>micrometer-registry-prometheus</artifactId>
    </dependency>

    <!-- AspectJ for @Timed and @Counted -->
    <!-- Spring Boot 4 renamed spring-boot-starter-aop to spring-boot-starter-aspectj -->
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-aspectj</artifactId>
    </dependency>
</dependencies>
Nei tutorial più vecchi compaiono due trappole di versione. Da Micrometer 1.13 (Spring Boot 3.3), micrometer-registry-prometheus è costruito sul client Java di Prometheus 1.x; il vecchio codice 0.x vive nel modulo deprecato micrometer-registry-prometheus-simpleclient, che la documentazione Micrometer su Prometheus presenta solo come soluzione temporanea. E con Spring Boot 4 un pom.xml che dichiara ancora spring-boot-starter-aop non viene più risolto: la guida di migrazione a Spring Boot 4.0 lo rinomina in spring-boot-starter-aspectj.
Configurazione degli Endpoint Actuator
Per impostazione predefinita, solo l'endpoint health è esposto via HTTP. L'endpoint /actuator/prometheus esiste non appena il registry è nel classpath, ma restituisce 404 finché non viene aggiunto alla lista di esposizione.
Spring Boot 3.4 ha sostituito gli interruttori on/off (management.endpoints.enabled-by-default, management.endpoint.<id>.enabled) con un modello di accesso, e le vecchie proprietà sono deprecate. Lo schema opt-in imposta l'accesso predefinito a none e concede read-only endpoint per endpoint:
# application.yml
# Actuator configuration for production (Spring Boot 3.4+ access model)
management:
  endpoints:
    # Every endpoint is inaccessible unless granted below
    access:
      default: none
    web:
      exposure:
        # Endpoints exposed over HTTP
        # health, info, prometheus are the minimum for monitoring
        include: health,info,prometheus,metrics,env,loggers
      base-path: /actuator
  endpoint:
    health:
      access: read-only
      show-details: when-authorized
      show-components: when-authorized
    info:
      access: read-only
    prometheus:
      access: read-only
    metrics:
      access: read-only
    env:
      access: read-only
      # Mask sensitive values for anonymous callers
      show-values: when-authorized
    loggers:
      # unrestricted allows POST to change a log level at runtime
      access: unrestricted
Esposizione e accesso sono due controlli distinti. exposure.include decide se un endpoint viene mappato via HTTP; access decide cosa l'endpoint consente una volta mappato. Un file di proprietà che usa ancora enabled: true continua a funzionare con un avviso di deprecazione, ed è quello il momento di migrare.
L'opzione show-details: when-authorized mostra i dettagli di salute solo agli utenti autenticati con il ruolo appropriato. Gli endpoint stessi vengono protetti con una SecurityFilterChain dedicata:
// Securing Actuator endpoints (Spring Boot 4, Spring Security 7)
package com.example.monitoring.config;

import static org.springframework.security.web.access.IpAddressAuthorizationManager.hasIpAddress;

import org.springframework.boot.security.autoconfigure.actuate.web.servlet.EndpointRequest;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.security.config.annotation.web.builders.HttpSecurity;
import org.springframework.security.web.SecurityFilterChain;

@Configuration(proxyBeanMethods = false)
public class ActuatorSecurityConfig {

    @Bean
    SecurityFilterChain actuatorSecurityFilterChain(HttpSecurity http) throws Exception {
        return http
            .securityMatcher(EndpointRequest.toAnyEndpoint())
            .authorizeHttpRequests(auth -> auth
                // Health and info public for load balancers
                .requestMatchers(EndpointRequest.to("health", "info")).permitAll()
                // Prometheus accessible from the internal network only
                .requestMatchers(EndpointRequest.to("prometheus")).access(hasIpAddress("10.0.0.0/8"))
                // Other endpoints restricted to admins
                .anyRequest().hasRole("ACTUATOR_ADMIN")
            )
            .httpBasic(basic -> {})
            .build();
    }
}
Con Spring Boot 4 EndpointRequest si trova in org.springframework.boot.security.autoconfigure.actuate.web.servlet, come mostra il riferimento degli endpoint Actuator. La DSL Java AuthorizedUrl di authorizeHttpRequests non ha un metodo hasIpAddress: la regola sull'IP passa per IpAddressAuthorizationManager.hasIpAddress, disponibile da Spring Security 6.3.
Metriche Custom con Micrometer
Counter, Gauge e Timer Applicativi
Micrometer offre diversi tipi di metriche adatti a casi d'uso differenti. I counter misurano eventi cumulativi, i gauge misurano valori istantanei e i timer misurano la durata delle operazioni.
// Custom business metrics service
package com.example.monitoring.metrics;

import io.micrometer.core.instrument.Counter;
import io.micrometer.core.instrument.Gauge;
import io.micrometer.core.instrument.MeterRegistry;
import io.micrometer.core.instrument.Timer;
import org.springframework.stereotype.Service;

import java.util.concurrent.atomic.AtomicInteger;
import java.util.function.Supplier;

@Service
public class OrderMetricsService {

    // Counter for orders created
    private final Counter ordersCreatedCounter;
    // Timer to measure processing duration
    private final Timer orderProcessingTimer;
    // Atomic value for pending orders gauge
    private final AtomicInteger pendingOrdersCount = new AtomicInteger(0);

    public OrderMetricsService(MeterRegistry registry) {
        // Exported as orders_created_total: the _total suffix is added by the registry
        this.ordersCreatedCounter = Counter.builder("orders.created")
            .description("Total number of orders created")
            .tag("channel", "web")
            .register(registry);

        // Timer with histogram buckets: percentiles computed server-side in PromQL
        this.orderProcessingTimer = Timer.builder("orders.processing.duration")
            .description("Order processing duration")
            .publishPercentileHistogram()
            .register(registry);

        // Gauge linked to atomic value
        // Read on each scrape
        Gauge.builder("orders.pending.count", pendingOrdersCount, AtomicInteger::get)
            .description("Number of orders pending processing")
            .register(registry);
    }

    public void recordOrderCreated() {
        ordersCreatedCounter.increment();
        pendingOrdersCount.incrementAndGet();
    }

    public void recordOrderProcessed(Runnable processingLogic) {
        // Measures execution duration
        orderProcessingTimer.record(processingLogic);
        pendingOrdersCount.decrementAndGet();
    }

    public <T> T recordOrderProcessedWithResult(Supplier<T> processingLogic) {
        return orderProcessingTimer.record(processingLogic);
    }
}
Con il registry Prometheus contano due dettagli di naming. I nomi dei meter Micrometer usano i punti e vengono convertiti in snake case (orders.processing.duration diventa orders_processing_duration_seconds). I counter ricevono automaticamente il suffisso _total, quindi chiamare un counter orders.created.total aggiunge solo rumore.
publishPercentiles(0.5, 0.95, 0.99) calcola i percentili dentro ogni JVM, e quei valori non si possono aggregare tra istanze. publishPercentileHistogram() pubblica bucket che histogram_quantile() aggrega sull'intera flotta, ed è l'opzione da scegliere dietro Prometheus.
Annotazioni @Timed e @Counted
Per evitare codice ripetitivo, Micrometer fornisce annotazioni che strumentano i metodi tramite AspectJ.
// Automatic instrumentation with annotations
package com.example.monitoring.service;

import io.micrometer.core.annotation.Counted;
import io.micrometer.core.annotation.Timed;
import org.springframework.stereotype.Service;

@Service
public class PaymentService {

    private final PaymentValidator paymentValidator;

    public PaymentService(PaymentValidator paymentValidator) {
        this.paymentValidator = paymentValidator;
    }

    // @Timed creates a Timer
    // Measures each call and publishes count, sum, max and histogram buckets
    @Timed(
        value = "payment.process.duration",
        description = "Payment processing duration",
        histogram = true
    )
    public PaymentResult processPayment(PaymentRequest request) {
        // Call through another bean: the proxy intercepts it
        paymentValidator.validate(request);
        return executePayment(request);
    }

    // @Counted increments a counter on each call
    // Useful for discrete events
    @Counted(
        value = "payment.refunds",
        description = "Total number of refunds"
    )
    public void refundPayment(String transactionId) {
        // Refund logic
    }
}# application.yml
# Enables TimedAspect, CountedAspect and the other Micrometer annotation aspects
management:
observations:
annotations:
enabled: trueDa Spring Boot 3.2 non serve più dichiarare a mano i bean TimedAspect e CountedAspect: impostare management.observations.annotations.enabled=true con spring-boot-starter-aspectj nel classpath li configura automaticamente. La proprietà vale false per default, il che spiega la maggior parte delle segnalazioni del tipo "il mio @Timed non fa nulla".
Le annotazioni @Timed e @Counted funzionano solo sui metodi public dei bean Spring chiamati attraverso il proxy. Una chiamata da un metodo all'altro della stessa classe aggira il proxy e non viene strumentata, e un'annotazione su un metodo private viene ignorata. Annotare un controller Spring MVC già strumentato produce observation duplicate.
Pronto a superare i tuoi colloqui su Spring Boot?
Pratica con i nostri simulatori interattivi, flashcards e test tecnici.
Endpoint di Salute Custom
Health Indicator di Business
Gli Health Indicator verificano lo stato delle dipendenze esterne e dei componenti critici di business. Spring Boot fornisce indicator di default per database, Redis e altri servizi comuni. In Spring Boot 4 l'API di health vive in un modulo dedicato, spring-boot-health, e Health e HealthIndicator sono passati da org.springframework.boot.actuate.health a org.springframework.boot.health.contributor.
// Health indicator for payment gateway (Spring Boot 4 packages)
package com.example.monitoring.health;

import org.springframework.boot.health.contributor.Health;
import org.springframework.boot.health.contributor.HealthIndicator;
import org.springframework.stereotype.Component;
import org.springframework.web.client.RestClient;

import java.time.Duration;
import java.time.Instant;

@Component
public class PaymentGatewayHealthIndicator implements HealthIndicator {

    private final RestClient restClient;
    private final String gatewayHealthUrl;

    public PaymentGatewayHealthIndicator(RestClient.Builder restClientBuilder) {
        this.restClient = restClientBuilder.build();
        this.gatewayHealthUrl = "https://api.payment-gateway.com/health";
    }

    @Override
    public Health health() {
        Instant start = Instant.now();

        try {
            // Call gateway health endpoint
            var response = restClient.get()
                .uri(gatewayHealthUrl)
                .retrieve()
                .toBodilessEntity();

            Duration responseTime = Duration.between(start, Instant.now());

            if (response.getStatusCode().is2xxSuccessful()) {
                return Health.up()
                    .withDetail("responseTime", responseTime.toMillis() + "ms")
                    .withDetail("statusCode", response.getStatusCode().value())
                    .build();
            } else {
                return Health.down()
                    .withDetail("statusCode", response.getStatusCode().value())
                    .withDetail("reason", "Unexpected status code")
                    .build();
            }
        } catch (Exception e) {
            Duration responseTime = Duration.between(start, Instant.now());

            return Health.down()
                .withDetail("error", e.getClass().getSimpleName())
                .withDetail("message", e.getMessage())
                .withDetail("responseTime", responseTime.toMillis() + "ms")
                .build();
        }
    }
}
Questo indicator compare in /actuator/health con il nome paymentGateway: il nome del bean senza il suffisso HealthIndicator.
Health Group per Kubernetes
Spring Boot 4 abilita le probe liveness e readiness per default, su qualsiasi piattaforma e non solo quando rileva Kubernetes. I gruppi /actuator/health/liveness e /actuator/health/readiness esistono senza alcuna configurazione, e dichiarare a mano i bean LivenessStateHealthIndicator o ReadinessStateHealthIndicator è superfluo. La configurazione serve solo per aggiungere componenti a un gruppo o per definire gruppi personalizzati:
# application.yml
# Health groups configuration for Kubernetes
management:
  endpoint:
    health:
      probes:
        # true by default in Spring Boot 4
        enabled: true
        # Also serve the groups at /livez and /readyz on the main server port
        add-additional-paths: true
      group:
        # Readiness: can the application receive traffic?
        readiness:
          include: readinessState,db
        # Custom group for critical dependencies
        critical:
          include: db,paymentGateway
          show-details: when-authorized
Il gruppo liveness dovrebbe restare limitato a livenessState. Aggiungere un database o un gateway esterno alla liveness porta Kubernetes a riavviare ogni pod quando quella dipendenza cade, trasformando un'interruzione parziale in un'interruzione totale. Le dipendenze esterne vanno nella readiness, e solo quando l'applicazione non può servire alcuna richiesta senza di esse.
Le probe Kubernetes puntano poi a endpoint dedicati:
# kubernetes-deployment.yml
# Kubernetes probes configuration
spec:
  containers:
    - name: order-service
      livenessProbe:
        httpGet:
          path: /livez
          port: 8080
        initialDelaySeconds: 30
        periodSeconds: 10
        failureThreshold: 3
      readinessProbe:
        httpGet:
          path: /readyz
          port: 8080
        initialDelaySeconds: 10
        periodSeconds: 5
        failureThreshold: 3
Con add-additional-paths: true le probe restano sulla porta dell'applicazione anche quando Actuator gira su una porta di management separata, così un server principale in errore viene rilevato dalla probe.
Integrazione di Spring Boot con Prometheus e Grafana
Configurazione dello Scraping Prometheus
Prometheus raccoglie le metriche interrogando periodicamente l'endpoint /actuator/prometheus. La configurazione di scraping definisce i target e il percorso delle metriche, dato che Prometheus usa /metrics per default.
# prometheus.yml
# Prometheus configuration for Spring Boot
global:
  scrape_interval: 15s
  evaluation_interval: 15s

scrape_configs:
  - job_name: 'spring-boot-apps'
    metrics_path: '/actuator/prometheus'
    scrape_interval: 10s
    static_configs:
      - targets:
          - 'order-service:9090'
          - 'payment-service:9090'
          - 'inventory-service:9090'
    # Relabeling to strip the port from the instance label
    relabel_configs:
      - source_labels: [__address__]
        target_label: instance
        regex: '([^:]+):\d+'
        replacement: '${1}'

  # Kubernetes service discovery
  - job_name: 'kubernetes-pods'
    kubernetes_sd_configs:
      - role: pod
    relabel_configs:
      # Only scrape pods with annotation
      - source_labels: [__meta_kubernetes_pod_annotation_prometheus_io_scrape]
        action: keep
        regex: true
      - source_labels: [__meta_kubernetes_pod_annotation_prometheus_io_path]
        action: replace
        target_label: __metrics_path__
        regex: (.+)
I target usano la porta 9090 perché la configurazione di produzione più avanti sposta Actuator su una porta di management separata. Senza management.server.port, il target di scraping è la porta dell'applicazione.
Metriche Spring Boot Actuator Pubblicate per Default
Actuator con Micrometer espone metriche JVM, di processo, HikariCP e HTTP senza alcun codice. Queste query PromQL coprono quelle da osservare per prime in produzione:
# PromQL queries for JVM monitoring

# Heap memory usage, summed across heap pools
sum by (instance) (jvm_memory_used_bytes{area="heap"})

# Heap usage percentage
sum by (instance) (jvm_memory_used_bytes{area="heap"})
  / sum by (instance) (jvm_memory_max_bytes{area="heap"}) * 100

# Live threads
jvm_threads_live_threads

# Garbage collection: seconds spent paused per second
rate(jvm_gc_pause_seconds_sum[5m])

# GC pauses per minute
rate(jvm_gc_pause_seconds_count[1m]) * 60

# CPU used by the JVM process
process_cpu_usage

# Active database connections
hikaricp_connections_active

# Connection pool utilization
hikaricp_connections_active / hikaricp_connections_max * 100
jvm_memory_used_bytes{area="heap"} restituisce una serie per ogni pool di memoria (Eden, Survivor, Old Gen con G1). Dividerla per il massimo senza sum by (instance) produce rapporti per pool che in una dashboard sembrano sbagliati.
Un bean MeterBinder aggiunge gauge a livello applicativo che le metriche predefinite non coprono:
// Additional JVM metrics
package com.example.monitoring.metrics;

import io.micrometer.core.instrument.Gauge;
import io.micrometer.core.instrument.MeterRegistry;
import io.micrometer.core.instrument.binder.MeterBinder;
import org.springframework.stereotype.Component;

import java.lang.management.ManagementFactory;
import java.lang.management.OperatingSystemMXBean;

@Component
public class CustomJvmMetrics implements MeterBinder {

    @Override
    public void bindTo(MeterRegistry registry) {
        OperatingSystemMXBean osBean = ManagementFactory.getOperatingSystemMXBean();

        // System load average
        Gauge.builder("system.load.average", osBean, OperatingSystemMXBean::getSystemLoadAverage)
            .description("System load average over 1 minute")
            .register(registry);

        // Available processors count
        Gauge.builder("system.cpu.count", osBean, OperatingSystemMXBean::getAvailableProcessors)
            .description("Number of available processors")
            .register(registry);

        // Application uptime
        Gauge.builder("application.uptime.seconds",
                ManagementFactory.getRuntimeMXBean(),
                bean -> bean.getUptime() / 1000.0)
            .description("Application uptime in seconds")
            .register(registry);
    }
}
system.cpu.count e process.uptime sono già pubblicati dai binder integrati di Micrometer. L'esempio mostra lo schema, e un binder reale dovrebbe registrare solo ciò che manca alle metriche predefinite.
Dashboard Grafana Pronte all'Uso
Grafana offre dashboard della community per Spring Boot che funzionano con le metriche Actuator standard. Una dashboard scritta a mano usa i tipi di pannello timeseries e stat:
{
  "annotations": {
    "list": []
  },
  "panels": [
    {
      "title": "Request Rate",
      "type": "timeseries",
      "targets": [
        {
          "expr": "sum by (method, uri, status) (rate(http_server_requests_seconds_count{application=\"$application\"}[5m]))",
          "legendFormat": "{{method}} {{uri}} - {{status}}"
        }
      ]
    },
    {
      "title": "Response Time P99",
      "type": "timeseries",
      "targets": [
        {
          "expr": "histogram_quantile(0.99, sum by (le, method, uri) (rate(http_server_requests_seconds_bucket{application=\"$application\"}[5m])))",
          "legendFormat": "{{method}} {{uri}}"
        }
      ]
    },
    {
      "title": "Error Rate",
      "type": "stat",
      "targets": [
        {
          "expr": "sum(rate(http_server_requests_seconds_count{application=\"$application\",status=~\"5..\"}[5m])) / sum(rate(http_server_requests_seconds_count{application=\"$application\"}[5m])) * 100"
        }
      ]
    }
  ]
}
Molte dashboard copiate da tutorial più vecchi usano ancora i tipi di pannello graph e singlestat. Singlestat è stato rimosso in Grafana 8, e Grafana 12 ha eliminato del tutto il supporto ad AngularJS, quindi quei pannelli vengono visualizzati solo dopo la migrazione a timeseries e stat.
Per importare una dashboard della community: Grafana > Dashboards > New > Import, poi inserire l'ID 4701 (JVM Micrometer) oppure 12900 (SpringBoot APM). Dopo l'import conviene controllare i tipi di pannello: le revisioni più vecchie delle dashboard della community possono contenere ancora pannelli Angular che Grafana 12 deve migrare.
Alerting con Prometheus
Regole di Alerting Essenziali
Le regole di alerting di Prometheus generano notifiche quando le metriche superano soglie critiche.
# alerting-rules.yml
# Alert rules for Spring Boot applications
groups:
  - name: spring-boot-alerts
    rules:
      # Alert if application is down
      - alert: ApplicationDown
        expr: up{job="spring-boot-apps"} == 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "Application {{ $labels.instance }} is down"
          description: "{{ $labels.instance }} has been down for more than 1 minute"

      # Alert on HTTP error rate
      - alert: HighErrorRate
        expr: |
          sum(rate(http_server_requests_seconds_count{status=~"5.."}[5m])) by (application)
          /
          sum(rate(http_server_requests_seconds_count[5m])) by (application)
          > 0.05
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "High error rate on {{ $labels.application }}"
          description: "Error rate is {{ $value | humanizePercentage }}"

      # Alert on P99 latency, aggregated per application
      - alert: HighLatency
        expr: |
          histogram_quantile(0.99,
            sum by (le, application) (rate(http_server_requests_seconds_bucket[5m]))
          ) > 2
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "High latency on {{ $labels.application }}"
          description: "P99 latency is {{ $value | humanizeDuration }}"

      # Heap memory alert
      - alert: HighHeapUsage
        expr: |
          sum by (instance) (jvm_memory_used_bytes{area="heap"})
          / sum by (instance) (jvm_memory_max_bytes{area="heap"})
          > 0.85
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "High heap memory usage on {{ $labels.instance }}"
          description: "Heap usage is at {{ $value | humanizePercentage }}"

      # Database connection pool exhausted alert
      - alert: DatabaseConnectionPoolExhausted
        expr: |
          hikaricp_connections_active
          / hikaricp_connections_max
          > 0.9
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "Database connection pool nearly exhausted"
          description: "{{ $value | humanizePercentage }} of connections in use"

      # Excessive GC alert
      - alert: HighGCPause
        expr: |
          rate(jvm_gc_pause_seconds_sum[5m])
          / rate(jvm_gc_pause_seconds_count[5m])
          > 0.5
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "High GC pause time"
          description: "Average GC pause is {{ $value | humanizeDuration }}"
Questi alert coprono i problemi di produzione più comuni: disponibilità, performance e risorse. La regola HighLatency richiede sum by (le, ...): senza, histogram_quantile calcola un P99 per ogni serie (per URI, metodo e status), e un solo endpoint lento con tre chiamate fa scattare l'alert.
Metriche HTTP e Metriche Database in Spring Boot
Strumentazione Automatica delle Richieste HTTP
Spring Boot strumenta ogni richiesta Spring MVC e WebFlux in ingresso tramite l'Observation API e pubblica il timer http.server.requests, con i tag method, uri, status, outcome ed exception.
# application.yml
# HTTP metrics configuration
management:
  metrics:
    distribution:
      # Histogram buckets for server-side percentiles
      percentiles-histogram:
        http.server.requests: true
      # SLO buckets: count requests faster than each boundary
      slo:
        http.server.requests: 100ms, 500ms, 1s, 2s
    tags:
      # Common tags added to every meter
      application: ${spring.application.name}
      environment: ${spring.profiles.active:default}
Le interfacce WebMvcTagsContributor e WebMvcTagsProvider presenti in molti esempi sono state rimosse in Spring Boot 3.0. I tag personalizzati si aggiungono ora estendendo DefaultServerRequestObservationConvention, come documenta il riferimento delle metriche Spring Boot:
// Adds custom tags to http.server.requests (Spring Boot 3.0+)
package com.example.monitoring.config;

import io.micrometer.common.KeyValue;
import io.micrometer.common.KeyValues;
import org.springframework.http.server.observation.DefaultServerRequestObservationConvention;
import org.springframework.http.server.observation.ServerRequestObservationContext;
import org.springframework.stereotype.Component;

import jakarta.servlet.http.HttpServletRequest;

@Component
public class TenantObservationConvention extends DefaultServerRequestObservationConvention {

    @Override
    public KeyValues getLowCardinalityKeyValues(ServerRequestObservationContext context) {
        HttpServletRequest request = context.getCarrier();
        String userId = request.getHeader("X-User-Id");
        String tenantId = request.getHeader("X-Tenant-Id");

        // Keep the default tags and add two bounded ones
        return super.getLowCardinalityKeyValues(context).and(
            KeyValue.of("user.type", userId != null ? "authenticated" : "anonymous"),
            KeyValue.of("tenant", tenantId != null ? tenantId : "default")
        );
    }
}
Solo i key-value a bassa cardinalità diventano label Prometheus. Un tag tenant è accettabile con qualche decina di tenant e diventa un problema di cardinalità con migliaia. I valori ad alta cardinalità (ID utente, ID ordine) vanno in getHighCardinalityKeyValues, che alimenta solo le trace. Il lato tracing dell'Observation API è trattato in dettaglio in observability di Spring Boot con OpenTelemetry.
Metriche HikariCP e Query SQL
Le metriche del pool HikariCP sono esposte automaticamente con il prefisso hikaricp, con il nome del pool come tag, accanto ai gauge generici jdbc.connections. Impostare il nome del pool rende il tag leggibile:
# application.yml
# HikariCP pool configuration
spring:
  datasource:
    hikari:
      # Becomes the "pool" tag on hikaricp_* metrics
      pool-name: OrderServicePool
      maximum-pool-size: 20
      minimum-idle: 5
      connection-timeout: 30000
      idle-timeout: 600000
      max-lifetime: 1800000
Spring Boot non misura i tempi delle singole query. Il progetto datasource-micrometer avvolge il DataSource e crea un'observation per connessione, query e result set, ottenendo sia metriche sia span di trace. La linea 2.x è pensata per Spring Boot 4, la 1.x per Spring Boot 3:
<!-- pom.xml -->
<!-- JDBC observations: 2.x for Spring Boot 4, 1.x for Spring Boot 3 -->
<dependency>
    <groupId>net.ttddyy.observation</groupId>
    <artifactId>datasource-micrometer-spring-boot</artifactId>
    <version>2.0.1</version>
</dependency>
Questo sostituisce l'approccio manuale di avvolgere il DataSource in un ProxyDataSourceBuilder con un listener scritto a mano, che aggirava l'autoconfigurazione del DataSource di Spring Boot e andava riallineato a ogni aggiornamento di Boot. Le query lente indicano di solito un pattern N+1, trattato in soluzioni al problema N+1 in Spring Data JPA.
Best Practice per la Produzione
Cardinalità delle Metriche
Una cardinalità eccessiva degrada le performance di Prometheus. Ogni combinazione unica di tag genera una serie temporale distinta.
// AVOID: unbounded cardinality
package com.example.monitoring.antipattern;

@Service
public class AntiPatternHighCardinality {

    private final MeterRegistry registry;

    // BAD: userId creates one series per user
    public void trackUserAction(String userId, String action) {
        Counter.builder("user.actions")
            .tag("userId", userId)  // Millions of possible values
            .tag("action", action)
            .register(registry)
            .increment();
    }
}// Controlled cardinality
package com.example.monitoring.bestpractice;
@Service
public class GoodPracticeCardinality {
private final MeterRegistry registry;
// GOOD: user category instead of ID
public void trackUserAction(User user, String action) {
Counter.builder("user.actions")
.tag("userType", user.getSubscriptionType()) // FREE, PREMIUM, ENTERPRISE
.tag("action", action)
.register(registry)
.increment();
}
// GOOD: let a timer histogram bucket durations
public void trackResponseTime(long responseTimeMs) {
Timer.builder("response.time")
.publishPercentileHistogram()
.register(registry)
.record(Duration.ofMillis(responseTimeMs));
}
}Un Timer con bucket di istogramma risponde alle domande sulla latenza meglio di un counter con un tag bucket costruito a mano: PromQL può calcolare qualsiasi percentile dai bucket, e i limiti dei bucket restano coerenti tra i servizi.
Configurazione Pronta per la Produzione
# application-production.yml
# Production configuration (Spring Boot 4)
management:
  server:
    # Separate port for management endpoints, not exposed publicly
    port: 9090
  endpoints:
    access:
      default: none
    web:
      exposure:
        include: health,info,prometheus
  endpoint:
    health:
      access: read-only
      show-details: when-authorized
      probes:
        add-additional-paths: true
    info:
      access: read-only
    prometheus:
      access: read-only
  observations:
    annotations:
      enabled: true
  metrics:
    distribution:
      percentiles-histogram:
        http.server.requests: true
      minimum-expected-value:
        http.server.requests: 1ms
      maximum-expected-value:
        http.server.requests: 30s
    tags:
      application: ${spring.application.name}
      environment: production
      version: ${app.version:unknown}
Con access.default: none, endpoint come env, beans, configprops e mappings sono inaccessibili senza doverli elencare uno per uno. management.prometheus.metrics.export.enabled vale true per default, e un'impostazione step non ha effetto su Prometheus: è un registry di tipo pull, e l'intervallo di scraping si definisce in prometheus.yml.
Errori Comuni con Actuator e Prometheus
| Sintomo | Causa | Soluzione |
|---|---|---|
/actuator/prometheus restituisce 404 | Endpoint assente dalla lista di esposizione, oppure registry mancante | Aggiungere prometheus a management.endpoints.web.exposure.include e verificare che micrometer-registry-prometheus sia nel classpath |
| Il target Prometheus mostra "server returned HTTP status 401" | Spring Security protegge tutti gli endpoint tranne health | Aprire prometheus alla rete dello scraper o configurare la basic auth nella scrape config |
@Timed non produce alcuna metrica | management.observations.annotations.enabled vale false per default, oppure AspectJ manca | Impostare la proprietà a true e aggiungere spring-boot-starter-aspectj |
spring-boot-starter-aop non trovato dopo l'aggiornamento | Rinominato in Spring Boot 4 | Usare spring-boot-starter-aspectj |
L'import di Health o HealthIndicator fallisce su Boot 4 | Package spostato in org.springframework.boot.health.contributor | Aggiornare gli import |
Avvisi di deprecazione su management.endpoint.*.enabled | Modello on/off sostituito in Spring Boot 3.4 | Usare management.endpoints.access.default e management.endpoint.<id>.access |
| I percentili in dashboard divergono molto dalla realtà | Valori di publishPercentiles mediati tra i pod | Usare publishPercentileHistogram() e histogram_quantile() |
Domande da Colloquio su Spring Boot Micrometer
Actuator emerge nella maggior parte dei colloqui Spring Boot per ruoli mid-level e senior. Le risposte che distinguono un profilo esperto da uno junior:
- Differenza tra liveness e readiness: la liveness dice a Kubernetes di riavviare il pod, la readiness gli dice di smettere di instradare traffico. Un candidato che mette il database nel gruppo liveness non l'ha mai visto attraversare un'interruzione.
- Perché Micrometer e non direttamente il client Prometheus: Micrometer è una facciata. Lo stesso codice con
CountereTimeresporta verso Prometheus, Datadog o OTLP cambiando una dipendenza, e la strumentazione di Spring stesso (HTTP, pool JDBC, cache) è scritta su Micrometer. - Percentili lato client o istogrammi: i percentili lato client non si aggregano tra istanze, gli istogrammi sì. È la domanda trabocchetto più frequente sull'argomento.
- Cosa significa cardinalità e come manda in crisi Prometheus: una serie temporale per ogni combinazione unica di label; un tag con l'ID utente moltiplica l'uso di memoria per il numero di utenti.
- Come proteggere Actuator: limitare l'esposizione, impostare i livelli di accesso, eseguire il management su una porta separata e proteggerlo con una
SecurityFilterChaindedicata.
Altre domande di questo tipo sono raccolte nel modulo domande da colloquio su Spring Boot Actuator.
Fonti
- Spring Boot 4.0 Migration Guide:
spring-boot-starter-aoprinominato inspring-boot-starter-aspectj, probe abilitate per default, nuovo modulospring-boot-health - Spring Boot 3.4 Release Notes:
enabled-by-defaulteendpoint.<id>.enableddeprecati a favore del modello di accesso - Riferimento degli endpoint Spring Boot Actuator: proprietà di accesso, package di
EndpointRequest, health indicator inorg.springframework.boot.health.contributor, gruppi delle probe e percorsi aggiuntivi - Riferimento delle metriche Spring Boot:
DefaultServerRequestObservationConvention, metriche HikariCP ejdbc.connections, deprecazione di simpleclient - Riferimento observability di Spring Boot:
management.observations.annotations.enablede il requisito AspectJ - Documentazione Micrometer su Prometheus: registry basato sul client Java di Prometheus 1.x e modulo legacy simpleclient
- datasource-micrometer su GitHub: 2.x per Spring Boot 4, 1.x per Spring Boot 3
- Grafana: rimozione di AngularJS in Grafana 12: pannelli Graph e Singlestat sostituiti da Time series e Stat
- Release di Spring Boot: 4.1.2 come release GA corrente, 4.2.0-RC1 in pre-release
Cosa Ricordare su Spring Boot Micrometer e Prometheus
- Tre passaggi per uno scraping funzionante: starter Actuator,
micrometer-registry-prometheus,prometheusnella lista di esposizione - Modello di accesso dalla 3.4:
management.endpoints.access.default: nonepiùread-onlyper endpoint sostituisce i flagenableddeprecati - Cambiamenti di Spring Boot 4:
spring-boot-starter-aspectj, API di health inorg.springframework.boot.health.contributor,EndpointRequestinorg.springframework.boot.security.autoconfigure.actuate.web.servlet, probe attive per default - Le annotazioni richiedono un interruttore:
management.observations.annotations.enabled=true, nessun beanTimedAspectmanuale - Tag HTTP tramite l'Observation API: estendere
DefaultServerRequestObservationConvention, mantenere le label a bassa cardinalità - Istogrammi invece dei percentili lato client:
publishPercentileHistogram()esum by (le)in ognihistogram_quantile - La liveness resta locale: le dipendenze esterne vanno nella readiness o in un gruppo personalizzato, mai nella liveness
Con queste impostazioni un servizio Spring Boot 4 produce metriche che si aggregano correttamente tra i pod, endpoint che non espongono nulla alla rete pubblica e alert che scattano su incidenti reali anziché su un singolo URI lento.
Inizia a praticare!
Metti alla prova le tue conoscenze con i nostri simulatori di colloquio e test tecnici.
Sapresti trovare il bug in Spring Boot?
Uno snippet reale, un bug nascosto, un tentativo al giorno. Senza account per provare.

Scritto da
Anthony Fillion-MailletFondatore di SharpSkill
Sviluppatore fullstack da oltre 10 anni. Guida SharpSkill e risponde di tutto ciò che vi viene pubblicato.
Aggiornato il 26 ottobre 2026
Tag
Condividi
Articoli correlati
Logging strutturato in Spring Boot 2026: log JSON per la produzione con Logback e OpenTelemetry
Guida completa al logging strutturato in Spring Boot 4.x. Supporto JSON nativo, OpenTelemetry starter, MDC tracing e integrazione ELK Stack per observability in produzione.
Lavoro freelance Java Spring Boot sviluppatore 2026: dove trovare contratti, tariffe giornaliere e preparazione
Contratti freelance Java Spring Boot sviluppatore 2026: tariffe giornaliere aggiornate (mediana 440 EUR), migliori piattaforme per progetti in Europa, preparazione ai colloqui tecnici.
Lavoro Sviluppatore Java Spring Boot 2026: Dove Cercare, Fasce Salariali, Come Prepararsi
606 posizioni Spring Boot attive a settembre 2026. Questo articolo analizza dati salariali, percentuali di lavoro remoto e preparazione ai colloqui per sviluppatori Java Spring Boot.