Solid Queue e Solid Cache in Rails 8: Guida Completa per Colloqui Tecnici 2026
Analisi approfondita di Solid Queue e Solid Cache, i componenti database-backed predefiniti in Rails 8. Job batch, esecuzione fiber, Active Job Continuations e preparazione ai colloqui tecnici 2026.
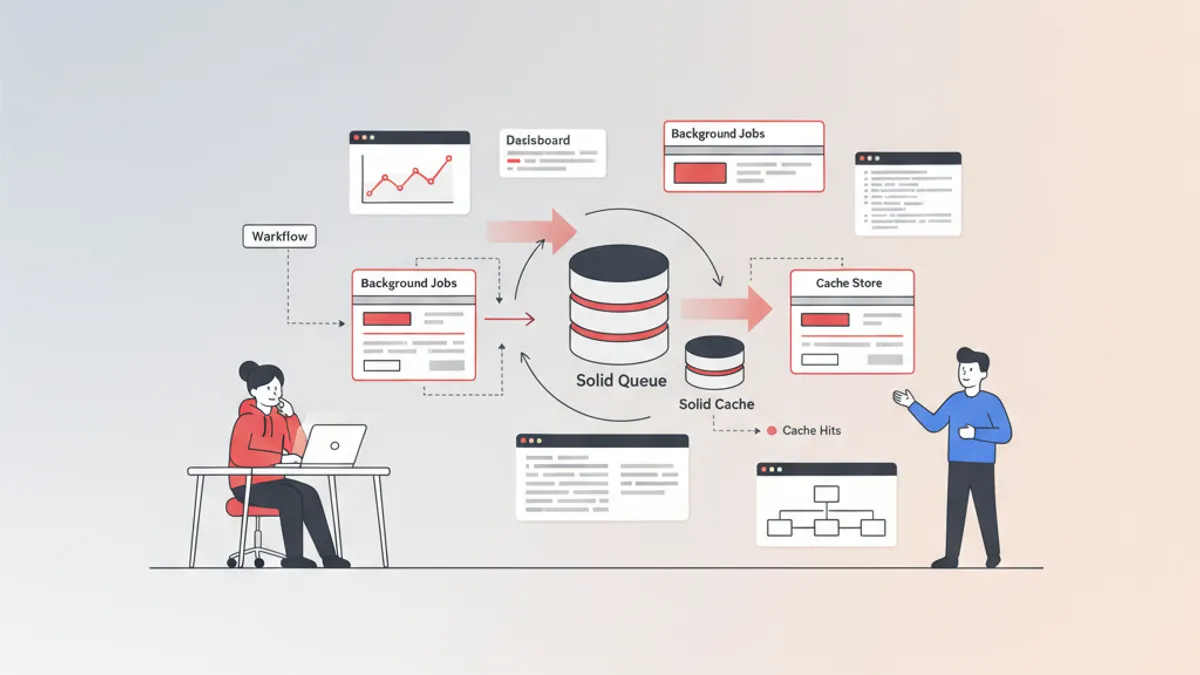
Solid Queue e Solid Cache rappresentano il cambiamento infrastrutturale più significativo nella storia di Rails. Entrambi i componenti sono inclusi come predefiniti in Rails 8, sostituendo Redis per i job in background e il caching con alternative database-backed che eliminano un intero livello di complessità operativa.
Rails 8 adotta tre componenti database-backed come impostazione predefinita: Solid Queue (job in background), Solid Cache (cache store) e Solid Cable (WebSocket). Insieme, eliminano la dipendenza da Redis per la maggior parte delle applicazioni Rails. Si tratta di un argomento ricorrente nei colloqui tecnici su Rails 8.
Come Solid Queue sostituisce i backend job basati su Redis
Solid Queue è un backend Active Job database-backed che memorizza i job direttamente in PostgreSQL, MySQL o SQLite. Il meccanismo chiave è FOR UPDATE SKIP LOCKED, una funzionalità SQL disponibile a partire da PostgreSQL 9.5+ e MySQL 8+ che trasforma una normale tabella del database in una coda di job concorrente senza blocchi.
L'architettura si compone di tre elementi:
- Worker interrogano
solid_queue_ready_executionse acquisiscono i job tramiteSKIP LOCKED - Dispatcher spostano i job pianificati da
solid_queue_scheduled_executionsalla tabella dei job pronti quando il loro orario di esecuzione è raggiunto - Scheduler gestiscono le attività ricorrenti definite nella configurazione
# config/solid_queue.yml
production:
  dispatchers:
    - polling_interval: 1
      batch_size: 500
  workers:
    - queues: "*"
      threads: 5
      polling_interval: 0.1
      processes: 2
Questa configurazione avvia due processi worker con 5 thread ciascuno, che effettuano il polling ogni 100 ms. Il dispatcher verifica i job pianificati ogni secondo in batch da 500.
Accodamento transazionale dei job in Rails 8
Uno degli argomenti più forti a favore di Solid Queue rispetto ai backend basati su Redis è l'accodamento transazionale. Quando un job viene accodato all'interno di una transazione del database, diventa visibile solo dopo il commit della transazione. I backend basati su Redis non possono offrire questa garanzia: un job potrebbe essere eseguito prima che la transazione che lo ha generato sia completata, facendo riferimento a record non ancora esistenti.
# app/jobs/send_welcome_email_job.rb
class SendWelcomeEmailJob < ApplicationJob
  self.enqueue_after_transaction_commit = true

  queue_as :default

  def perform(user_id)
    user = User.find(user_id)
    UserMailer.welcome(user).deliver_now
  end
end

# app/models/user.rb
class User < ApplicationRecord
  after_create do
    SendWelcomeEmailJob.perform_later(id)
    # Il job viene accodato solo dopo il commit della transazione CREATE
    # Nessun rischio che il job venga eseguito prima della creazione del record utente
  end
end
Con enqueue_after_transaction_commit attivato, il job viene differito fino al completamento con successo della transazione che lo contiene. Se la transazione viene annullata con rollback, il job non viene mai accodato. Questo elimina un'intera classe di race condition che affligge le code basate su Redis.
Controlli di concorrenza e code prioritarie
Solid Queue fornisce controlli di concorrenza integrati che Sidekiq offre solo nella versione Enterprise a pagamento. L'opzione concurrency_limit limita il numero di job di un determinato tipo che possono essere eseguiti simultaneamente.
# app/jobs/api_sync_job.rb
class ApiSyncJob < ApplicationJob
  limits_concurrency to: 3, key: ->(account_id) { "api_sync_#{account_id}" }

  def perform(account_id)
    account = Account.find(account_id)
    ExternalApi.sync(account)
  end
end
Questo garantisce che al massimo 3 job di sincronizzazione API vengano eseguiti contemporaneamente per account, prevenendo violazioni dei limiti di frequenza senza coordinamento esterno. I job bloccati vengono memorizzati in solid_queue_blocked_executions e rilasciati automaticamente quando uno slot si libera.
La priorità funziona su due livelli: priorità numerica per job (numero inferiore = priorità superiore) e ordinamento delle code nella configurazione del worker. Entrambi i livelli possono essere combinati per un controllo granulare sull'ordine di esecuzione dei job.
Una domanda frequente nei colloqui su Rails 8 riguarda i compromessi tra Solid Queue e Sidekiq. Il fattore differenziante chiave: Solid Queue offre garanzie transazionali e controlli di concorrenza integrati senza costi aggiuntivi. Sidekiq prevale nel throughput puro per carichi ad alto volume (10.000+ job al minuto) grazie a Redis che opera in memoria. Per il 95% delle applicazioni, Solid Queue fornisce prestazioni sufficienti. Benchmark dettagliati sono disponibili nel confronto tra sistemi di job in background per Rails.
Job batch per operazioni raggruppate
Solid Queue 1.7.0 ha introdotto i job batch, che consentono di raggruppare e tracciare i job come un insieme. Questa funzionalità abilita callback quando tutti i job di un batch sono completati, un pattern che in precedenza richiedeva Sidekiq Pro.
# app/jobs/batch_import_job.rb
class BatchImportJob < ApplicationJob
  def perform(file_id)
    file = ImportFile.find(file_id)

    SolidQueue::Batch.enqueue(
      on_finish: BatchFinishedJob,
      on_success: NotifyUserJob,
      on_failure: AlertOpsJob
    ) do |batch|
      file.rows.each_slice(100) do |rows|
        ProcessRowsJob.perform_later(rows.map(&:id))
      end
    end
  end
end
Il batch traccia tutti i job accodati all'interno del suo blocco. Quando tutti i job sono completati, viene attivato on_finish indipendentemente dal successo o dal fallimento. Se tutti i job hanno successo, viene attivato on_success. Se un job fallisce, viene attivato on_failure. Questo abilita workflow come l'elaborazione di import, dove uno step finale deve attendere il completamento di tutte le parti.
I job creati al di fuori di un batch ma accodati al suo interno si uniscono a quel batch. Un batch che termina senza job si completa immediatamente, attivando i suoi callback subito.
Modalità di esecuzione Fiber per workload I/O-bound
Solid Queue 1.6.0 ha aggiunto l'esecuzione worker basata su fiber utilizzando il gem Async. Questa modalità esegue i job su fiber invece che su thread, il che è vantaggioso per workload I/O-bound come le chiamate API a LLM, dove la maggior parte del tempo viene spesa in attesa di risposte.
# config/solid_queue.yml
production:
  workers:
    - queues: [llm_calls, external_apis]
      fibers: 100
      polling_interval: 0.5
Con 100 fiber, 100 job I/O-bound concorrenti possono essere eseguiti in un singolo processo con un overhead di memoria minimo. Questo è più vantaggioso rispetto a 100 thread, che consumerebbero significativamente più memoria e sarebbero soggetti a contesa sul GVL (Global VM Lock).
La modalità fiber richiede che Rails sia configurato per l'isolamento fiber:
# config/application.rb
config.active_support.isolation_level = :fiber
I job CPU-bound dovrebbero continuare a utilizzare i thread, poiché le fiber non offrono vantaggi quando il lavoro non cede all'I/O.
Active Job Continuations in Rails 8.1
Rails 8.1 ha introdotto Active Job Continuations, che consentono ai job di lunga durata di sospendere e riprendere da checkpoint. Questo risolve il problema dei job che ripartono da zero quando vengono interrotti da deploy o riavvii dei container.
# app/jobs/process_import_job.rb
class ProcessImportJob < ApplicationJob
  include ActiveJob::Continuable

  def perform(import_id)
    @import = Import.find(import_id)

    step :validate do
      @import.validate!
    end

    step :process_records do |step|
      @import.records.find_each(start: step.cursor) do |record|
        record.process
        step.advance!(from: record.id)
      end
    end

    step :finalize do
      @import.mark_complete!
    end
  end
end
Il metodo step definisce fasi discrete. Se il job viene interrotto, riprende dall'ultimo step completato. All'interno di uno step, step.cursor traccia il progresso: step.advance!(from: record.id) salva la posizione del cursore. Alla ripresa, find_each(start: step.cursor) riprende da dove l'elaborazione era stata interrotta.
Le Continuations richiedono che l'adapter della coda implementi stopping?. Solid Queue lo supporta dalla v1.2.0. Delayed Job e Resque non supportano l'interruzione graceful senza lavoro aggiuntivo.
Il cursore può essere qualsiasi valore serializzabile. Per loop annidati, si utilizza un array:
step :process_nested, start: [0, 0] do |step|
  Account.find_each(start: step.cursor[0]) do |account|
    account.records.find_each(start: step.cursor[1]) do |record|
      record.process
      step.set!([account.id, record.id + 1])
    end
    step.set!([account.id + 1, 0])
  end
end
Job ricorrenti senza Cron
Solid Queue sostituisce la pianificazione basata su cron con uno scheduler integrato. Le attività ricorrenti vengono definite in un file di configurazione YAML e gestite dal processo scheduler.
# config/recurring.yml
production:
  cleanup_expired_sessions:
    class: CleanupExpiredSessionsJob
    schedule: every 6 hours
  daily_report:
    class: DailyReportJob
    schedule: every day at 6am
    queue: reports
  weekly_digest:
    class: WeeklyDigestJob
    schedule: every Monday at 9am
Il processo scheduler legge questo file e accoda i job appropriati agli intervalli definiti. A differenza di cron, opera all'interno dello stesso supervisore di processi e condivide la stessa connessione al database. Il supporto per i fusi orari è stato aggiunto in Solid Queue 1.5.0.
Deployment con integrazione Puma
Rails 8 con Kamal offre un deployment a configurazione zero per Solid Queue. L'impostazione SOLID_QUEUE_IN_PUMA=1 indica a Puma di effettuare il fork e supervisionare i processi Solid Queue insieme al web server.
# config/puma.rb (predefinito Rails 8)
plugin :solid_queue if ENV["SOLID_QUEUE_IN_PUMA"]
Questo modello di deployment a processo singolo semplifica l'orchestrazione dei container. Una singola immagine Docker esegue sia il web server che i processori di job, riducendo il carico operativo per applicazioni di piccole e medie dimensioni.
Pronto a superare i tuoi colloqui su Ruby on Rails?
Pratica con i nostri simulatori interattivi, flashcards e test tecnici.
Solid Cache: caching database-backed scalabile
Solid Cache è un ActiveSupport::Cache::Store database-backed che sfrutta le prestazioni degli SSD moderni per sostituire Redis e Memcached come cache store predefinito. La premessa: gli SSD sono solo marginalmente più lenti della RAM per le operazioni di lettura, ma offrono ordini di grandezza in più di spazio di archiviazione a una frazione del costo. Solid Cache è in produzione presso Basecamp gestendo 10 TB con retention di 60 giorni, dimezzando i tempi di render P95.
Solid Cache utilizza una strategia di espulsione FIFO (First In, First Out) anziché LRU (Least Recently Used). Sebbene FIFO sia teoricamente meno efficiente, la capacità di archiviazione enormemente superiore compensa: le voci rimangono nella cache molto più a lungo, riducendo complessivamente i cache miss.
# config/environments/production.rb
config.cache_store = :solid_cache_store

# config/solid_cache.yml
production:
  databases:
    - cache
  store_options:
    max_age: 604800        # 1 settimana in secondi
    max_size: 256           # Dimensione max per voce in KB
    namespace: "app_v1"
    expiry_batch_size: 100  # Voci ripulite per ciclo di scadenza
Architettura della cache e meccanismo di espulsione
Solid Cache traccia le scritture utilizzando un contatore interno. Quando il contatore raggiunge il 50% dell'expiry_batch_size configurato, viene attivata un'attività in background per ripulire le voci scadute. Questo approccio ammortizzato evita le pause stop-the-world che possono verificarsi con l'espulsione LRU in istanze Redis con memoria limitata.
La tabella solid_cache_entries memorizza tutti i dati nella cache:
# db/cache_schema.rb (generato dall'installer)
create_table :solid_cache_entries do |t|
  t.binary :key, null: false, limit: 1024
  t.binary :value, null: false, limit: 262144  # 256 KB predefinito
  t.datetime :created_at, null: false
  t.index :key, unique: true
  t.index :created_at  # Per espulsione FIFO
end
Le operazioni di lettura e scrittura su questa tabella utilizzano lo stesso connection pool del resto dell'applicazione per impostazione predefinita. Per applicazioni ad alto traffico, la configurazione di un database separato per i dati della cache impedisce che le operazioni di cache impattino sulle prestazioni del database primario.
Configurazione di un database separato per la cache
Isolare Solid Cache su un database dedicato è semplice e raccomandato per i carichi di produzione che generano traffico cache significativo.
# config/database.yml
production:
  primary:
    <<: *default
    database: myapp_production
  cache:
    <<: *default
    database: myapp_cache_production
    migrations_paths: db/cache_migrate
Questa separazione garantisce che milioni di operazioni di scrittura nella cache non gonfino il WAL (Write-Ahead Log) del database primario né competano per gli slot del connection pool con le query applicative.
Senza un database separato, le letture e scritture di Solid Cache partecipano a qualsiasi transazione ActiveRecord che le contiene. Questo significa che una transazione di lunga durata mantiene le voci della cache in uno stato non committato. Per le applicazioni in produzione è consigliabile configurare sempre un database cache dedicato.
Sharding e crittografia
Solid Cache supporta lo sharding dei dati nella cache su più database per distribuire il carico. Supporta inoltre gli attributi crittografati, mantenendo i dati nella cache crittografati a riposo, un requisito di conformità per le applicazioni che gestiscono informazioni sensibili.
# config/solid_cache.yml
production:
  databases:
    - cache_shard_1
    - cache_shard_2
    - cache_shard_3
  store_options:
    max_age: 1209600  # 2 settimane
Le voci vengono distribuite tra gli shard utilizzando il consistent hashing sulla chiave della cache. L'aggiunta o la rimozione di shard causa un aumento temporaneo dei cache miss man mano che le voci vengono ridistribuite, ma non si verifica alcuna perdita di dati.
Monitoraggio con Mission Control Jobs
Mission Control Jobs fornisce una dashboard web per ispezionare e gestire i job di Solid Queue. Visualizza worker, code e stati dei job (in corso, completati, bloccati, falliti) attraverso un engine Rails montato.
# config/routes.rb
Rails.application.routes.draw do
  mount MissionControl::Jobs::Engine, at: "/jobs"
end

# Gemfile
gem "mission_control-jobs", ">= 1.0.1"
Mission Control espone anche un'API da console per operazioni di massa sui job falliti:
# Console Rails
ActiveJob.jobs.failed.where(job_class: "ApiSyncJob").retry_all
ActiveJob.jobs.failed.where(job_class: "BrokenJob").discard_all
Questo accesso programmatico è essenziale per gestire guasti di job su larga scala senza dover navigare manualmente in una dashboard.
Fonti
- Rails 8.0 Release Notes - Documentazione ufficiale su Solid Queue e Solid Cache come default
- Solid Queue GitHub Releases - Changelog per batch (v1.7.0), modalità fiber (v1.6.0) e supporto continuations (v1.2.0)
- Active Job Continuations PR - Dettagli implementativi di Rails 8.1
- Introducing Solid Queue (37signals) - Razionale di design e utilizzo in produzione presso HEY
Domande chiave per i colloqui tecnici
I colloqui su Rails 8 si concentrano sempre di più sullo stack Solid. Di seguito le domande più frequenti, con il livello di approfondimento atteso nelle risposte.
D: Come fa Solid Queue a ottenere l'elaborazione concorrente dei job senza Redis?
Solid Queue utilizza FOR UPDATE SKIP LOCKED, una clausola SQL che consente a più worker di interrogare la stessa tabella senza bloccarsi a vicenda. Ogni worker blocca un batch di righe, le elabora e cancella i record di esecuzione. Gli altri worker saltano le righe già bloccate e acquisiscono job diversi.
D: Quale problema risolve l'accodamento transazionale?
Impedisce che i job vengano eseguiti prima che la transazione del database che li ha generati abbia effettuato il commit. Senza questa garanzia, un job potrebbe fare riferimento a un record annullato con rollback, causando errori ActiveRecord::RecordNotFound.
D: Perché Solid Cache utilizza FIFO invece di LRU? FIFO è più semplice da implementare in un database ed evita l'amplificazione delle scritture dovuta all'aggiornamento dei timestamp di accesso a ogni lettura. Il compromesso è compensato dalla capacità degli SSD: le voci sopravvivono più a lungo, quindi il tasso di hit rimane elevato nonostante la strategia di espulsione meno ottimale.
D: Come funzionano i job batch in Solid Queue?
I job accodati all'interno di un blocco SolidQueue::Batch.enqueue vengono tracciati insieme. Il batch attiva on_finish quando tutti i job sono completati, on_success se tutti hanno successo, o on_failure se qualcuno fallisce. Questo abilita workflow come import batch, dove uno step finale dipende dal completamento di tutte le parti.
D: Cosa sono le Active Job Continuations e quando andrebbero utilizzate? Le Continuations consentono ai job di lunga durata di salvare checkpoint del loro progresso e riprendere dopo un'interruzione. Andrebbero utilizzate per job che elaborano grandi dataset, come import o aggiornamenti batch, dove ripartire da zero a ogni deploy sprecherebbe tempo e risorse significativi.
D: Quando un'applicazione dovrebbe ancora utilizzare Redis anziché lo stack Solid? Redis rimane superiore per applicazioni che elaborano più di 10.000 job al minuto, per carichi che richiedono letture dalla cache inferiori al millisecondo, o per applicazioni che già utilizzano Redis per altri scopi (Pub/Sub, rate limiting, gestione delle sessioni). Lo stack Solid punta alla semplicità, non al throughput massimo.
Queste domande e molte altre sono disponibili per la pratica sul modulo ActiveJob e Job in Background di SharpSkill e sul modulo Strategie di Caching.
Pronto a superare i tuoi colloqui su Ruby on Rails?
Pratica con i nostri simulatori interattivi, flashcards e test tecnici.
Cosa ricordare su Solid Queue e Solid Cache in Rails 8
- Solid Queue sostituisce le code di job basate su Redis con una soluzione database-backed che utilizza
FOR UPDATE SKIP LOCKEDper l'elaborazione concorrente - L'accodamento transazionale elimina le race condition tra le scritture nel database e l'esecuzione dei job, una garanzia che Redis non può fornire
- I job batch (v1.7.0) abilitano operazioni raggruppate con callback di completamento, in precedenza una funzionalità di Sidekiq Pro
- La modalità di esecuzione fiber (v1.6.0) migliora il throughput per workload I/O-bound come le chiamate API a LLM
- Le Active Job Continuations (Rails 8.1) consentono ai job di lunga durata di salvare checkpoint e riprendere dopo un'interruzione
- Controlli di concorrenza integrati, job ricorrenti e integrazione con Puma sono inclusi in Solid Queue senza costi aggiuntivi
- Solid Cache utilizza il caching FIFO su SSD con sharding e crittografia opzionali, rimuovendo Memcached e Redis dallo stack infrastrutturale
- La configurazione di un database separato per Solid Cache impedisce che le operazioni di cache impattino sulle prestazioni del database primario
- Mission Control Jobs offre monitoraggio in produzione e gestione massiva dei job tramite dashboard web e API da console
- Per la maggior parte delle applicazioni Rails 8 nel 2026, lo stack Solid è la scelta predefinita raccomandata. Redis resta l'opzione preferita solo per i casi limite ad alto throughput che superano i 10.000 job al minuto
Inizia a praticare!
Metti alla prova le tue conoscenze con i nostri simulatori di colloquio e test tecnici.
Sapresti trovare il bug in Ruby on Rails?
Uno snippet reale, un bug nascosto, un tentativo al giorno. Senza account per provare.

Scritto da
Anthony Fillion-MailletFondatore di SharpSkill
Sviluppatore fullstack da oltre 10 anni. Guida SharpSkill e risponde di tutto ciò che vi viene pubblicato.
Aggiornato il 10 ottobre 2026
Tag
Condividi
Articoli correlati
Ruby on Rails 8: Novità e Guida Completa alla Migrazione 2026
Rails 8 introduce la Solid Trifecta, l'autenticazione nativa, Kamal 2 e Propshaft. Guida completa con esempi di codice e passaggi per la migrazione da Rails 7.
Background Jobs in Rails 2026: Sidekiq vs Good Job con Domande da Colloquio
Confronto completo tra Sidekiq, Good Job e Solid Queue per i background jobs in Rails. Guida alla scelta della soluzione ottimale con domande tecniche per colloqui.
Rails Active Storage nel 2026: Upload di File, Integrazione S3 e Domande per Colloqui
Padroneggiare Rails Active Storage per upload di file con S3 e direct upload. Tutorial completo con esempi di codice e domande frequenti nei colloqui sulla gestione dei file in Ruby on Rails.