RAG e LLM nel 2026: Retrieval-Augmented Generation per Colloqui di Data Science
Retrieval-Augmented Generation (RAG) spiegata per i colloqui di data science nel 2026. Copre vector database, strategie di chunking, modelli di embedding, RAG agentico, Graph RAG e architettura di pipeline production-ready.
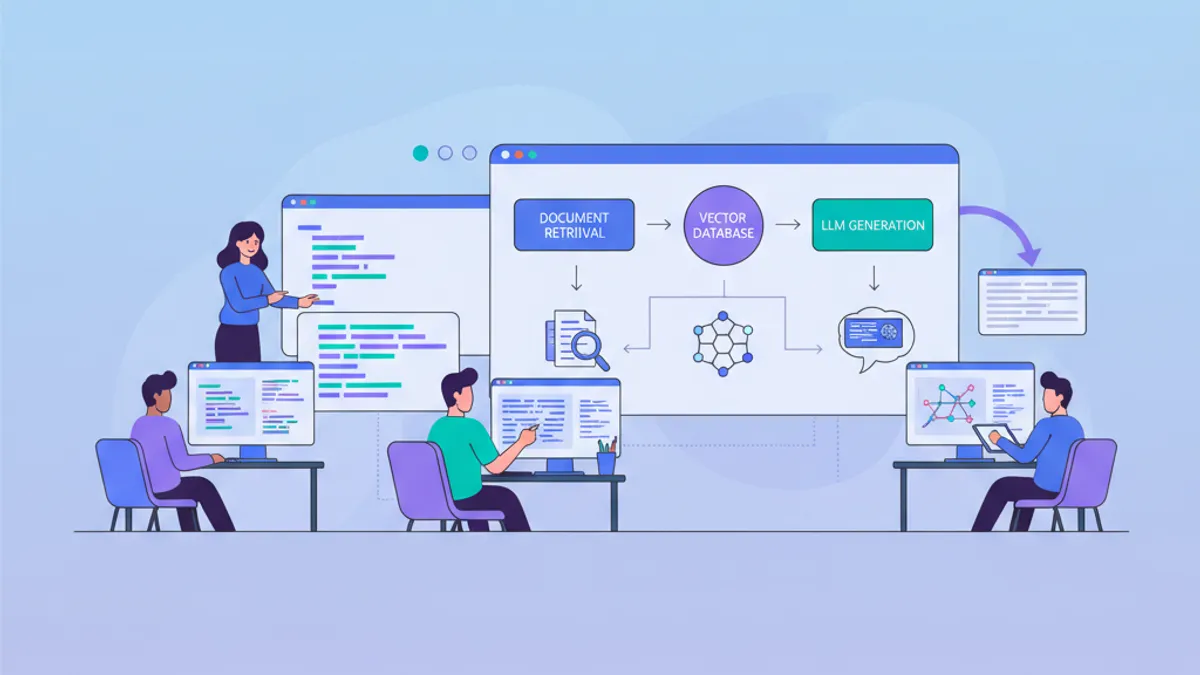
Retrieval-Augmented Generation (RAG) si è affermata come architettura standard per ancorare gli output degli LLM a dati fattuali e aggiornati. Nei colloqui di data science e AI engineering nel 2026, le domande su RAG appaiono ormai insieme ai tradizionali argomenti di machine learning, testando sia il pensiero progettuale sistemico che le competenze di implementazione pratica.
Retrieval-Augmented Generation combina un sistema di retrieval (ricerca vettoriale su una knowledge base) con un generatore LLM, in modo che il modello risponda basandosi su documenti reali invece di affidarsi a dati di addestramento memorizzati.
Come funziona la pipeline RAG End to End
Un sistema RAG opera in due fasi: una fase di ingestione offline che costruisce la knowledge base, e una fase di query online che recupera il contesto rilevante e genera una risposta.
Durante l'ingestione, i documenti grezzi passano attraverso pulizia, chunking ed embedding prima della memorizzazione in un vector database. Durante l'inferenza, la query dell'utente segue lo stesso percorso di embedding, e la ricerca nearest-neighbor recupera i chunk più rilevanti. Questi chunk diventano parte del prompt dell'LLM, ancorando la risposta generata al materiale sorgente.
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
Questa pipeline copre il ciclo RAG fondamentale: chunk, embed, store, retrieve, generate. Il parametro search_type="mmr" garantisce che i chunk recuperati siano sia rilevanti che diversificati, riducendo la ridondanza nella finestra di contesto.
Strategie di Chunking che contano davvero
Il chunking determina la qualità del retrieval più di qualsiasi altro componente. Un chunking inadeguato significa che il retriever restituisce frammenti privi di contesto o che diluiscono il segnale con contenuto irrilevante.
Tre approcci di chunking dominano i sistemi di produzione nel 2026:
Fixed-size chunking suddivide il testo a un conteggio di token prestabilito (tipicamente da 256 a 512 token) con sovrapposizione. Semplice da implementare, ma divide frasi e idee a metà.
Chunking semantico rileva i confini tematici misurando la similarità degli embedding tra frasi consecutive. Quando la similarità scende sotto una soglia, inizia un nuovo chunk. Ogni chunk porta un'idea coerente piuttosto che una porzione arbitraria di testo.
Late chunking applica prima il modello transformer all'intero documento, producendo embedding di token contestuali, quindi suddivide in chunk. Questo preserva le dipendenze a lungo raggio che il chunking tradizionale distrugge.
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
L'aspetto chiave per i colloqui: la dimensione dei chunk è un trade-off precision-recall. Chunk piccoli (100 token) migliorano la precisione del retrieval ma frammentano il contesto. Chunk grandi (1000 token) preservano il contesto ma diluiscono la specificità dell'embedding. La maggior parte dei sistemi in produzione si attesta tra 256 e 512 token con sovrapposizione dal 10 al 20%.
Vector Database ed Embedding in Produzione
Il vector database memorizza gli embedding e supporta ricerche approximate nearest-neighbor (ANN) veloci. La scelta della giusta combinazione di modello di embedding e vector database influenza direttamente la latenza e l'accuratezza del retrieval.
I modelli di embedding nel 2026 si sono consolidati attorno ad alcune opzioni ad alte prestazioni. text-embedding-3-large di OpenAI (3072 dimensioni) e alternative open-source come bge-m3 di BAAI o embed-v4 di Cohere offrono un retrieval multilingue di alto livello. La leaderboard MTEB rimane il benchmark standard per confrontare la qualità degli embedding. text-embedding-3-large supporta il Matryoshka representation learning, consentendo il troncamento delle dimensioni (a 1024 o 256) con perdita di qualità minima, riducendo significativamente i costi di storage.
Il mercato dei vector database si è consolidato nel 2026. Quattro prodotti coprono la stragrande maggioranza dei workload RAG in produzione:
| Database | Indicizzazione | Gestito | Punto di forza |
|---|---|---|---|
| Pinecone | Proprietario | Sì | Zero-ops, inferenza integrata, ricerca ibrida |
| Weaviate | HNSW | Sì/Self | BM25 nativo + fusione densa in una query |
| Qdrant | HNSW | Sì/Self | Performance Rust, filtraggio payload, miglior tier gratuito |
| pgvector | IVF, HNSW | Self | Integrazione PostgreSQL per stack esistenti |
Per le discussioni durante i colloqui, il punto critico è comprendere l'algoritmo HNSW (Hierarchical Navigable Small World): costruisce un grafo multilivello dove ogni nodo è connesso ai suoi vicini più prossimi, consentendo ricerche in O(log n) a fronte di un maggiore utilizzo di memoria.
Il punto di svolta dei costi è tra 60 e 80 milioni di query al mese. Oltre questa soglia, Qdrant o Weaviate self-hosted su infrastruttura a costo fisso battono costantemente Pinecone Serverless gestito di 3-10 volte.
Pronto a superare i tuoi colloqui su Data Science & ML?
Pratica con i nostri simulatori interattivi, flashcards e test tecnici.
Retrieval Ibrido: Combinare Dense e Sparse
La ricerca vettoriale pura fallisce con le corrispondenze esatte di keyword e i termini rari. La ricerca lessicale pura (BM25) non coglie la similarità semantica. Il retrieval ibrido combina entrambi, e nel 2026 rappresenta lo standard per i sistemi RAG in produzione.
Il pattern standard utilizza Reciprocal Rank Fusion (RRF) per unire i risultati classificati da entrambi i retriever:
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
Il retrieval ibrido risolve il problema del "vocabulary mismatch", dove un utente chiede informazioni sulla "cancellazione di un abbonamento" ma il documento rilevante utilizza il termine "procedura di disdetta del servizio". BM25 cattura la sovrapposizione esatta dei termini, mentre la ricerca vettoriale coglie la relazione semantica.
Reranking: Il filtro di seconda fase
Il retrieval restituisce candidati. Il reranking li ordina per rilevanza effettiva. I cross-encoder reranker come Cohere Rerank o bge-reranker-v2.5-gemma2-lightweight valutano ogni coppia query-documento congiuntamente, producendo score di rilevanza molto più accurati rispetto alla similarità bi-encoder.
La pipeline di retrieval a due stadi (ampio recall di prima fase con top 50-100 candidati via vettore + BM25, poi reranking preciso ai top 5-10 per il prompt) è standard nei sistemi di produzione. Questo mantiene la latenza gestibile: la prima fase usa ricerca ANN veloce, mentre il costoso cross-encoder elabora solo un piccolo set di candidati.
I cross-encoder sono più accurati dei bi-encoder perché elaborano query e documento insieme attraverso tutti i layer del transformer. I bi-encoder li incorporano indipendentemente, perdendo segnali di interazione a grana fine. Il compromesso è la velocità: i cross-encoder non possono essere pre-indicizzati.
RAG Adattivo: Routing delle Query alla Pipeline Corretta
Non tutte le query necessitano della stessa complessità di retrieval. Il RAG adattivo addestra un piccolo classificatore per instradare ogni domanda al percorso ottimale:
- Nessun retrieval per query fattuali semplici che il modello già conosce
- Retrieval a singolo passaggio per query moderate
- Retrieval iterativo multi-passaggio per ragionamenti complessi
Questo pattern bilancia costi e accuratezza su workload misti. Un sistema di produzione che gestisce 100.000 query al giorno può ridurre i costi di inferenza del 40% instradando le domande semplici lontano dalle pipeline multi-passaggio costose.
Il classificatore stesso può essere un piccolo modello fine-tuned o un prompt zero-shot che chiede: "Questa domanda richiede conoscenza esterna per essere risposta accuratamente?"
RAG Speculativo: Latenza contro Velocità
Il RAG speculativo esegue il retrieval in parallelo con una generazione draft veloce. Se il draft mostra alta confidenza (misurata tramite logprob), il passaggio di retrieval viene saltato completamente. Se la confidenza è bassa, il contesto recuperato viene unito al draft e avviene la rigenerazione.
Questo approccio riduce la latenza media del 30-40% sulle query ad alta confidenza. Funziona meglio per chatbot in tempo reale, suggerimenti di autocompletamento e sistemi di customer service dove il tempo di risposta conta più di una ricerca esaustiva delle fonti per ogni query.
Il compromesso: il RAG speculativo occasionalmente restituisce risposte senza ancoraggio quando il modello è troppo confidente. I sistemi di produzione lo combinano con calibrazione della confidenza e fallback al retrieval completo quando l'incertezza supera una soglia.
RAG Agentico: Oltre il Retrieval Single-Shot
Il RAG naive recupera una volta e genera. Il RAG agentico tratta l'LLM come un agente di ragionamento che decide quando recuperare, cosa recuperare e se il contesto recuperato è sufficiente.
Nel 2026, il RAG agentico è il pattern dominante per query complesse che richiedono ragionamento multi-step. L'agente può:
- Auto-valutarsi: Verificare se i documenti recuperati rispondono alla domanda
- Riformulare: Riscrivere la query di ricerca se i risultati iniziali sono insufficienti
- Instradare: Scegliere tra diverse fonti di conoscenza (vector DB, database SQL, API)
- Verificare: Incrociare i fatti attraverso più passaggi recuperati
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
Questo pattern (recuperare, valutare, eventualmente riscrivere e riprovare) è noto come Corrective RAG (CRAG). L'AgentExecutor di LangChain è deprecato dal 2026; i nuovi progetti dovrebbero usare create_react_agent() per pattern precostruiti o lo StateGraph di LangGraph per orchestrazione personalizzata. Per una copertura più approfondita dei pattern LangChain per data scientist, consultare l'articolo dedicato.
Graph RAG: Retrieval Strutturato della Conoscenza
Graph RAG estrae entità e relazioni dai documenti in un knowledge graph, quindi interroga sia il grafo che il vector store. Questa architettura riduce le allucinazioni nelle query fattuali ancorando le risposte in relazioni esplicite tra entità anziché nella similarità di testo non strutturato.
La pipeline di ingestione estrae triple (soggetto, predicato, oggetto) da ogni chunk di documento. Al momento della query, il sistema identifica le entità rilevanti nella domanda, attraversa il knowledge graph per fatti connessi e combina il contesto recuperato dal grafo con i passaggi recuperati dal vettore.
Graph RAG eccelle nelle domande di ragionamento multi-hop come "Quale team guida il progetto che utilizza il framework menzionato nel documento X?" Queste query richiedono di collegare fatti attraverso più documenti, cosa che la ricerca vettoriale pura fatica a fare perché nessun singolo chunk contiene la risposta completa.
Graph RAG migliora significativamente l'accuratezza fattuale (fino al 40% di riduzione delle allucinazioni su query con molte entità) ma richiede una pipeline di entity extraction matura. Un'estrazione imprecisa produce un grafo impreciso, che può degradare i risultati al di sotto del RAG naive. Da notare che il progetto GraphRAG di Microsoft è entrato in modalità manutenzione nel 2026; riceverà fix di bug ma nessuna nuova funzionalità.
La variante LazyGraphRAG di Microsoft (rilasciata a giugno 2025) riduce drasticamente i costi di indicizzazione differendo la summarization al momento della query, rendendola adatta per analisi esplorative o dati in streaming dove la costruzione anticipata del grafo è impraticabile.
Compliance EU AI Act per Sistemi RAG
L'EU AI Act è diventato ampiamente applicabile nell'agosto 2026. La prima multa di alto profilo ai sensi della legge ha colpito il chatbot RAG di un consorzio bancario europeo alla fine di maggio 2026, e una società di wealth management di Francoforte ha ricevuto una sanzione di 4,5 milioni di euro in aprile 2026 per un sistema RAG rivolto ai clienti che non riusciva a spiegare la provenienza dei dati.
Le architetture RAG soddisfano naturalmente diversi requisiti di compliance: tracciabilità delle fonti (i chunk portano riferimenti ai documenti), trasparenza delle risposte (le citazioni possono essere mostrate) e verificabilità (i log di retrieval esistono per costruzione). Tuttavia, la compliance completa richiede misure aggiuntive:
Classificazione del rischio: Un chatbot pubblico rientra nel rischio limitato (trasparenza richiesta). Un sistema RAG medico o legale è ad alto rischio con obblighi di documentazione e supervisione più stringenti.
Audit logging: Registrare quale domanda ha attivato quali chunk recuperati e quale risposta è stata generata. Questo log costituisce la base della tracciabilità richiesta.
Supervisione umana: I sistemi ad alto rischio richiedono validazione umana sui casi sensibili, la possibilità di correggere gli output e meccanismi per cancellare i dati indicizzati su richiesta.
Residenza dei dati: Ospitare l'indicizzazione nell'UE e usare BYOK (Bring Your Own Key) per garantire che i dati non transitino attraverso account di terze parti al di fuori della giurisdizione.
La non conformità può costare il 7% del fatturato annuo globale. Per le discussioni nei colloqui, il punto chiave è che la capacità intrinseca di citazione di RAG è un vantaggio, ma non sostituisce il layer di governance.
Valutazione dei Sistemi RAG: Le Metriche che Contano
La valutazione RAG si divide in metriche di retrieval e metriche di generazione. Entrambe devono essere misurate indipendentemente per diagnosticare i guasti.
Metriche di retrieval:
- Recall@k: I documenti rilevanti sono apparsi nei top-k risultati?
- MRR (Mean Reciprocal Rank): Quanto in alto è classificato il primo risultato rilevante?
- NDCG: Il ranking corrisponde all'ordinamento di rilevanza ideale?
Metriche di generazione:
- Faithfulness: La risposta utilizza solo informazioni dal contesto recuperato? (Misura le allucinazioni)
- Answer Relevance: La risposta affronta la domanda originale?
- Context Precision: I chunk recuperati vengono effettivamente utilizzati nella risposta?
Framework come Ragas e DeepEval automatizzano queste valutazioni utilizzando pattern LLM-as-judge. Le principali domande dei colloqui di data science includono sempre più frequentemente la progettazione della valutazione RAG, quindi ci si deve aspettare di spiegare come misurare se un sistema RAG funziona correttamente.
Modalità di Guasto in Produzione e Debugging
I sistemi RAG falliscono in modi prevedibili. Conoscere questi pattern è essenziale sia per i colloqui che per il deployment reale.
Inquinamento della finestra di contesto si verifica quando troppi chunk recuperati diluiscono il segnale rilevante. L'LLM riceve 10 chunk ma solo 2 contengono informazioni utili. La soluzione: utilizzare un reranker per filtrare e ridurre il top-k del retriever.
Artefatti di chunking si verificano quando lo splitting a dimensione fissa spezza frasi, tabelle o blocchi di codice a metà elemento. Il chunk recuperato è sintatticamente incompleto e semanticamente inutile. Il chunking semantico o lo splitting document-aware (rispettando header, paragrafi, code fence) risolve questo problema.
Embedding drift emerge quando il modello di embedding viene aggiornato ma il vector store contiene ancora embedding del vecchio modello. Le query codificate con il nuovo modello cercano in uno spazio vettoriale costruito dal vecchio, degradando la qualità del retrieval. Soluzione: ri-embeddare l'intero corpus dopo ogni cambio di modello.
Indici obsoleti forniscono informazioni datate perché la pipeline di ingestione è rimasta indietro rispetto agli aggiornamenti dei documenti. Nei sistemi di machine learning, questo è analogo al training-serving skew, dove il sistema di retrieval vede una distribuzione di dati diversa da quella esistente in produzione.
Fonti
- Turing Post: 20 Advanced RAG Types to Know in 2026 - tassonomia completa dei pattern RAG
- LangChain and LangGraph 1.0 Milestones - deprecazione di AgentExecutor, nuovi pattern
- Microsoft GraphRAG GitHub - stato modalità manutenzione
- IgnitionRAG EU AI Act Guide - requisiti di compliance per sistemi RAG
- MarkTechPost: Best Vector Databases in 2026 - consolidamento del mercato e prezzi
Inizia a praticare!
Metti alla prova le tue conoscenze con i nostri simulatori di colloquio e test tecnici.
Punti Chiave per RAG nei Colloqui di Data Science
- RAG combina il retrieval (ricerca vettoriale su una knowledge base) con la generazione LLM per produrre risposte fondate e fattuali senza riaddestrare il modello
- La strategia di chunking ha il maggiore impatto sulla qualità del retrieval; il chunking semantico e il late chunking superano lo splitting a dimensione fissa nella maggior parte dei casi
- Il retrieval ibrido (vettori densi + BM25 sparso) con Reciprocal Rank Fusion è lo standard di produzione, risolvendo il problema del vocabulary mismatch che la ricerca vettoriale pura non può gestire
- I reranker cross-encoder aggiungono un livello di precisione dopo il retrieval ampio, elaborando solo un piccolo set di candidati per mantenere la latenza accettabile
- Il RAG adattivo instrada le query alla complessità di pipeline appropriata, riducendo i costi del 40% su workload misti
- Il RAG speculativo scambia ancoraggio per velocità, riducendo la latenza del 30-40% sulle query ad alta confidenza
- Il RAG agentico (recuperare, valutare, riscrivere, riprovare) e il Graph RAG (estrazione di relazioni tra entità) gestiscono query multi-hop complesse dove il RAG naive fallisce
- La compliance EU AI Act (agosto 2026) richiede audit logging, supervisione umana e classificazione del rischio per i sistemi RAG in produzione
- La valutazione deve separare le metriche di retrieval (Recall@k, MRR) dalle metriche di generazione (Faithfulness, Answer Relevance) per diagnosticare dove la pipeline si interrompe
- I guasti di produzione più comuni (inquinamento del contesto, artefatti di chunking, embedding drift, indici obsoleti) hanno tutti soluzioni semplici una volta identificati
Sapresti trovare il bug in Data Science & ML?
Uno snippet reale, un bug nascosto, un tentativo al giorno. Senza account per provare.

Scritto da
Anthony Fillion-MailletFondatore di SharpSkill
Sviluppatore fullstack da oltre 10 anni. Guida SharpSkill e risponde di tutto ciò che vi viene pubblicato.
Aggiornato il 24 agosto 2026
Tag
Condividi
Articoli correlati
LangChain per Data Scientist nel 2026: LLM, Agent e Domande da Colloquio
Padroneggiare LangChain 0.3 per la data science: catene LCEL, pattern RAG, agent ReAct e sistemi di memoria. Include domande da colloquio e strategie di deployment in produzione.
MLOps nel 2026: MLflow, Model Registry e domande da colloquio tecnico
Domande da colloquio su MLOps che coprono il ciclo di vita ML, il tracking degli esperimenti con MLflow, la promozione nel model registry, i pattern di deployment, il monitoraggio del drift e il system design per il 2026, con codice Python e risposte.
Feature Engineering per Machine Learning: Tecniche e Domande da Colloquio 2026
Guida completa al feature engineering per machine learning: tecniche di selezione, trasformazione e domande frequenti nei colloqui data science 2026.