ETL vs ELT nel 2026: Architettura delle Data Pipeline e Domande per Colloqui Tecnici
ETL ed ELT rappresentano due approcci fondamentali all'architettura delle data pipeline. Questo confronto analizza quando utilizzare ciascun pattern, gli strumenti disponibili e le domande che i Data Engineer affrontano nei colloqui tecnici.
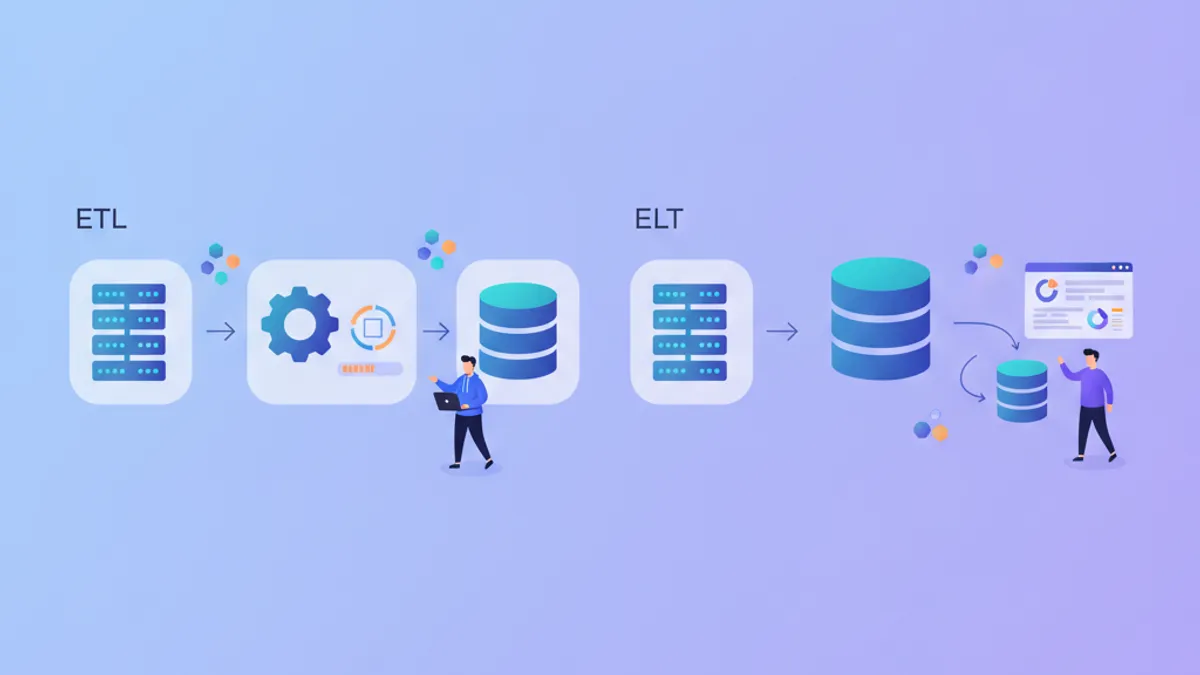
ETL vs ELT definisce come i dati si spostano dai sistemi sorgente agli ambienti di analisi. La scelta tra Extract-Transform-Load (ETL) ed Extract-Load-Transform (ELT) influenza i costi infrastrutturali, la freschezza dei dati e le competenze richieste ai team di engineering.
ETL trasforma i dati prima del caricamento nel sistema di destinazione, richiedendo risorse di calcolo dedicate. ELT carica prima i dati grezzi, poi li trasforma utilizzando la potenza di elaborazione del warehouse di destinazione. La maggior parte degli stack di dati cloud-native nel 2026 preferisce ELT perché la capacità di calcolo scala su richiesta.
Architettura ETL: Trasformazione Prima del Caricamento
L'ETL è nato quando i data warehouse avevano capacità di calcolo limitata e lo storage era costoso. Il pattern aveva senso: filtrare e aggregare i dati fuori dal warehouse, caricare solo ciò che l'analisi richiedeva. Oracle Warehouse Builder, Informatica PowerCenter e Talend hanno costruito strumenti attorno a questo modello.
La fase di trasformazione in ETL viene eseguita su server intermedi. I dati si spostano dalla sorgente a un'area di staging, vengono puliti e ristrutturati, poi caricati nella destinazione. Questo approccio riduce il carico del warehouse ma crea un collo di bottiglia nel layer di trasformazione.
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
L'ETL funziona bene quando la logica di trasformazione rimane stabile e i volumi di dati sono prevedibili. Lo svantaggio emerge quando i requisiti cambiano: modificare le trasformazioni significa rielaborare i dati storici da zero.
Architettura ELT: Prima Caricare, Poi Trasformare nel Warehouse
L'ELT sposta la trasformazione nel data warehouse. Snowflake, BigQuery, Databricks e Redshift forniscono capacità di calcolo quasi illimitata che scala con la complessità delle query. Caricare prima i dati grezzi preserva lo stato della sorgente; le trasformazioni diventano modelli SQL che possono essere versionati e rieseguiti senza ri-estrarre.
Il progetto dbt (data build tool) ha reso popolare l'ELT trattando le trasformazioni SQL come codice. Invece di job ETL black-box, le trasformazioni risiedono nel version control come statement SELECT che referenziano tabelle raw e costruiscono modelli derivati.
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggL'ELT preserva i dati grezzi, permettendo la rielaborazione quando la logica di business cambia. Se un calcolo era sbagliato sei mesi fa, correggere il modello dbt ed eseguire un full refresh corregge i dati storici. Con l'ETL, la stessa correzione richiede la ri-estrazione da sorgenti che potrebbero non avere più i record originali.
Tabella Comparativa: Trade-off ETL vs ELT
| Fattore | ETL | ELT |
|---|---|---|
| Posizione del calcolo | Server di trasformazione dedicato | Warehouse di destinazione |
| Conservazione dati grezzi | Spesso scartati dopo la trasformazione | Preservati nella landing zone |
| Costo di rielaborazione | Ri-estrazione dalla sorgente | Riesecuzione modelli SQL |
| Flessibilità dello schema | Fissato al momento della trasformazione | Schema-on-read possibile |
| Esempi di strumenti | Informatica, Talend, SSIS | dbt, Dataform, SQLMesh |
| Ottimale per | Requisiti stabili, sistemi legacy | Requisiti mutevoli, warehouse cloud |
| Latenza | Maggiore (trasforma prima di caricare) | Minore (carica poi trasforma) |
| Data governance | Più semplice (dati filtrati prima del warehouse) | Richiede controlli a livello warehouse |
Pronto a superare i tuoi colloqui su Data Engineering?
Pratica con i nostri simulatori interattivi, flashcards e test tecnici.
Approcci Ibridi: Quando ETL ed ELT si Combinano
I moderni data stack raramente usano ETL o ELT puro. Apache Airflow orchestra pipeline che combinano entrambi i pattern. I dati sensibili potrebbero essere anonimizzati prima del caricamento (uno step ETL), mentre le aggregazioni vengono eseguite nel warehouse (ELT).
Fivetran e Airbyte estraggono e caricano dati grezzi senza trasformazione, poi dbt trasforma all'interno del warehouse. Ma questi strumenti supportano anche trasformazioni leggere durante l'estrazione: selezione delle colonne, coercizione del tipo di dati, hashing dei campi PII. Questo sfuma il confine ETL/ELT.
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
La pipeline sopra estrae da Salesforce con Airbyte (che può eseguire l'hash degli indirizzi email durante la sincronizzazione), carica su Snowflake, poi esegue modelli dbt per le trasformazioni di business. Né ETL puro né ELT puro, ma pratico.
Domande per Colloqui: ETL vs ELT per Data Engineer
I colloqui tecnici per ruoli di data engineering in aziende che utilizzano moderni data stack verificano la comprensione dell'architettura delle pipeline. Queste domande appaiono frequentemente, basate su pattern dai moduli di preparazione ai colloqui ETL/ELT.
Domanda 1: Quando si Sceglierebbe ETL Rispetto a ELT?
Le risposte forti identificano scenari specifici:
- Requisiti di conformità: GDPR o HIPAA impongono che certi dati non raggiungano mai il warehouse in forma grezza. I PII devono essere anonimizzati o rimossi prima del caricamento.
- Limitazioni del warehouse legacy: Sistemi on-premises come Teradata o configurazioni Redshift più vecchie con calcolo fisso beneficiano di carichi pre-aggregati.
- Costi di rete: Caricare 10TB giornalieri in un warehouse cloud, poi scartare il 90% dopo la trasformazione, spreca larghezza di banda in uscita. Il pre-filtraggio ha senso economico.
Le risposte deboli dicono "ETL è obsoleto" o non forniscono scenari concreti. Gli intervistatori cercano sfumature.
Domanda 2: Come si Gestiscono i Cambiamenti di Schema in una Pipeline ELT?
Questo verifica la comprensione delle landing zone per dati grezzi. Argomenti attesi:
- Colonne JSON o semi-strutturate che assorbono nuovi campi senza migrazione dello schema
- Modelli di staging che selezionano esplicitamente le colonne, isolando i modelli a valle dai cambiamenti della sorgente
- Macro dbt o assertion Dataform che fanno fallire le build quando le colonne attese scompaiono
- Monitoraggio per schema drift con strumenti come Monte Carlo o Great Expectations
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
Domanda 3: Confronto tra Orchestrazione ETL con Airflow ed Esecuzione di dbt per ELT
La domanda verifica la comprensione che questi strumenti risolvono problemi diversi:
- Airflow orchestra task: estrazione, chiamate API, trasferimenti file, training di modelli. Gestisce le dipendenze tra job eterogenei.
- dbt trasforma dati all'interno di un warehouse. Gestisce le dipendenze tra modelli SQL, esegue test, genera documentazione.
Una pipeline completa spesso usa entrambi: Airflow attiva le sincronizzazioni Airbyte, attende il completamento, poi attiva le esecuzioni dbt. Sapere quando usare quale strumento distingue i candidati senior.
Domanda 4: La Pipeline ELT Elabora 500M di Righe al Giorno e gli Analisti Segnalano Query Lente
Questa domanda aperta verifica il pensiero diagnostico:
- Verificare la materializzazione del modello: I modelli pesanti sono ancora viste? Modelli incrementali o tabelle potrebbero aiutare.
- Partizionamento e clustering: Per BigQuery, le tabelle dei fatti sono partizionate per data? Per Snowflake, il clustering è ottimizzato per i pattern di query comuni?
- Query pushdown: Gli analisti interrogano i modelli di staging invece dei mart pre-aggregati?
- Dimensionamento del warehouse: La capacità di calcolo è scalata appropriatamente durante le ore di query?
- Requisiti di freschezza: La trasformazione potrebbe essere eseguita di notte invece che durante l'orario lavorativo?
Non esiste una singola risposta corretta. Gli intervistatori valutano il troubleshooting sistematico.
Panorama degli Strumenti nel 2026
Il mercato dell'integrazione dati si è consolidato attorno ad alcuni pattern:
Estrazione e caricamento: Fivetran, Airbyte, Stitch e Meltano gestiscono la parte EL. Questi strumenti si connettono a centinaia di sorgenti e sincronizzano verso warehouse cloud senza codice personalizzato.
Trasformazione: dbt domina la trasformazione basata su SQL. Le alternative includono Dataform (ora parte di Google Cloud), SQLMesh (open source con ambienti dati virtuali) e Coalesce (modellazione visuale).
Orchestrazione: Airflow rimane lo standard per pipeline complesse. Dagster e Prefect offrono alternative con migliore sviluppo locale e viste asset-centriche.
Qualità: Great Expectations, test dbt, Monte Carlo e Soda forniscono monitoraggio della qualità dei dati. Questi rilevano problemi tra l'estrazione e il consumo a valle.
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
Inizia a praticare!
Metti alla prova le tue conoscenze con i nostri simulatori di colloquio e test tecnici.
Selezionare l'Architettura della Pipeline per Nuovi Progetti
Per la maggior parte dei progetti greenfield nel 2026, ELT è lo standard. Il calcolo del warehouse cloud costa meno che mantenere server di trasformazione. La conservazione dei dati grezzi permette correzioni retroattive. Le trasformazioni basate su SQL sono auditabili e version-controlled.
L'ETL rimane rilevante per:
- Ambienti regolamentati che richiedono minimizzazione dei dati prima dell'ingresso nel warehouse
- Streaming real-time dove la trasformazione deve avvenire al momento dell'ingestione (Kafka Streams, Flink)
- Scenari di edge computing con storage a valle limitato
- Integrazioni legacy dove il sistema sorgente controlla il formato di esportazione
La risposta pronta per il colloquio riconosce entrambi i pattern e spiega i trade-off senza preferenza ideologica.
Conclusioni Chiave sull'Architettura delle Data Pipeline
- ETL trasforma i dati prima del caricamento, riducendo il carico del warehouse ma creando attrito nella rielaborazione quando la logica cambia
- ELT carica prima i dati grezzi, permettendo trasformazioni basate su SQL che possono essere versionate, testate e rieseguite sui dati storici
- I moderni stack tipicamente combinano entrambi: trasformazioni di estrazione leggere (hashing PII, casting dei tipi) con aggregazione basata sul warehouse
- dbt è diventato lo standard per la trasformazione ELT, trattando i modelli SQL come codice testabile e documentato
- Le domande dei colloqui verificano la selezione degli scenari, la gestione dell'evoluzione dello schema e i trade-off degli strumenti piuttosto che definizioni memorizzate
- La conservazione dei dati grezzi nelle pipeline ELT permette correzioni ai calcoli storici senza ri-estrazione dalle sorgenti
Sapresti trovare il bug in Data Engineering?
Uno snippet reale, un bug nascosto, un tentativo al giorno. Senza account per provare.

Scritto da
Anthony Fillion-MailletFondatore di SharpSkill
Sviluppatore fullstack da oltre 10 anni. Guida SharpSkill e risponde di tutto ciò che vi viene pubblicato.
Aggiornato il 14 settembre 2026
Tag
Condividi
Articoli correlati
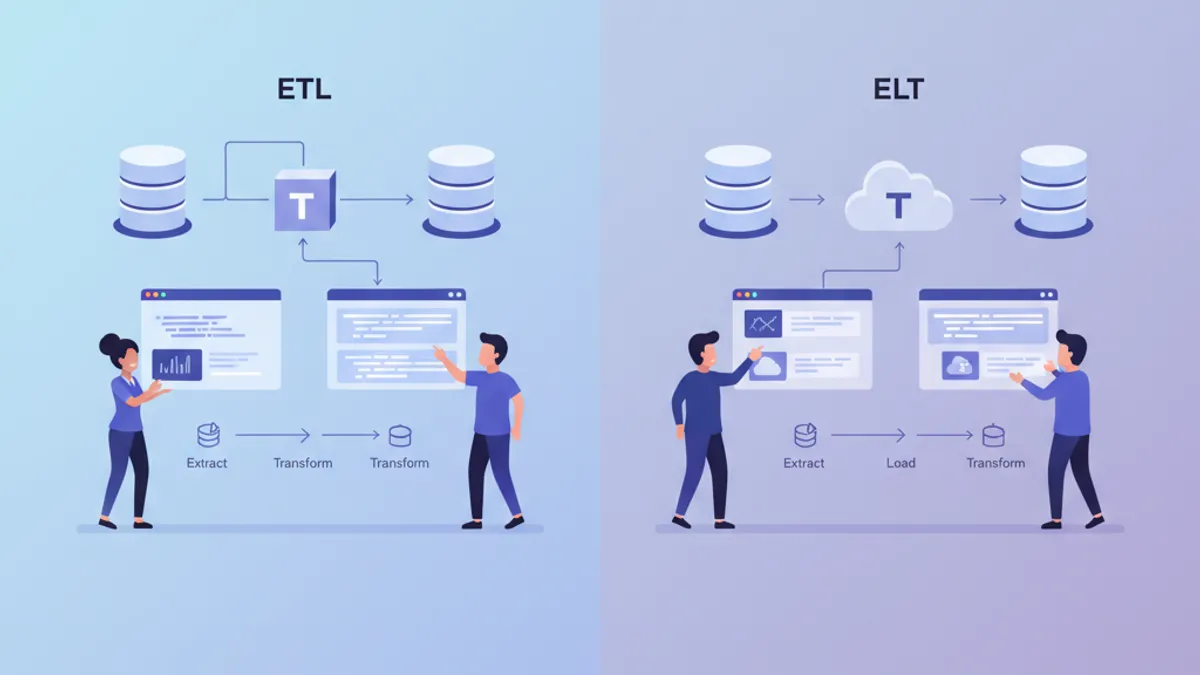
ETL vs ELT nel 2026: Architettura delle Data Pipeline a confronto
Confronto ETL vs ELT per le data pipeline moderne. Differenze architetturali, compromessi su prestazioni e costi, e quando utilizzare ciascun approccio con Snowflake, BigQuery e dbt nel 2026.

Apache Spark 4.2 vs Databricks nel 2026: Architettura, Performance e Domande di Colloquio
Confronto tra Apache Spark 4.2 e Databricks nel 2026. Differenze architetturali, caratteristiche di performance e domande frequenti nei colloqui di data engineering.
Apache Airflow nel 2026: Orchestrazione di Pipeline, DAG e Domande per Colloqui Tecnici
Guida completa ad Apache Airflow 3.2 nel 2026: creazione di DAG con Task SDK, dynamic task mapping, asset partitions, confronto con Prefect e Dagster, e domande frequenti nei colloqui tecnici.