2026'da RAG ve LLM: Veri Bilimi Mülakatları için Retrieval-Augmented Generation
2026'da veri bilimi mülakatları için Retrieval-Augmented Generation (RAG) açıklanıyor. Vektör veritabanları, chunking stratejileri, gömme modelleri, agentic RAG, Graph RAG ve üretime hazır pipeline mimarisi.
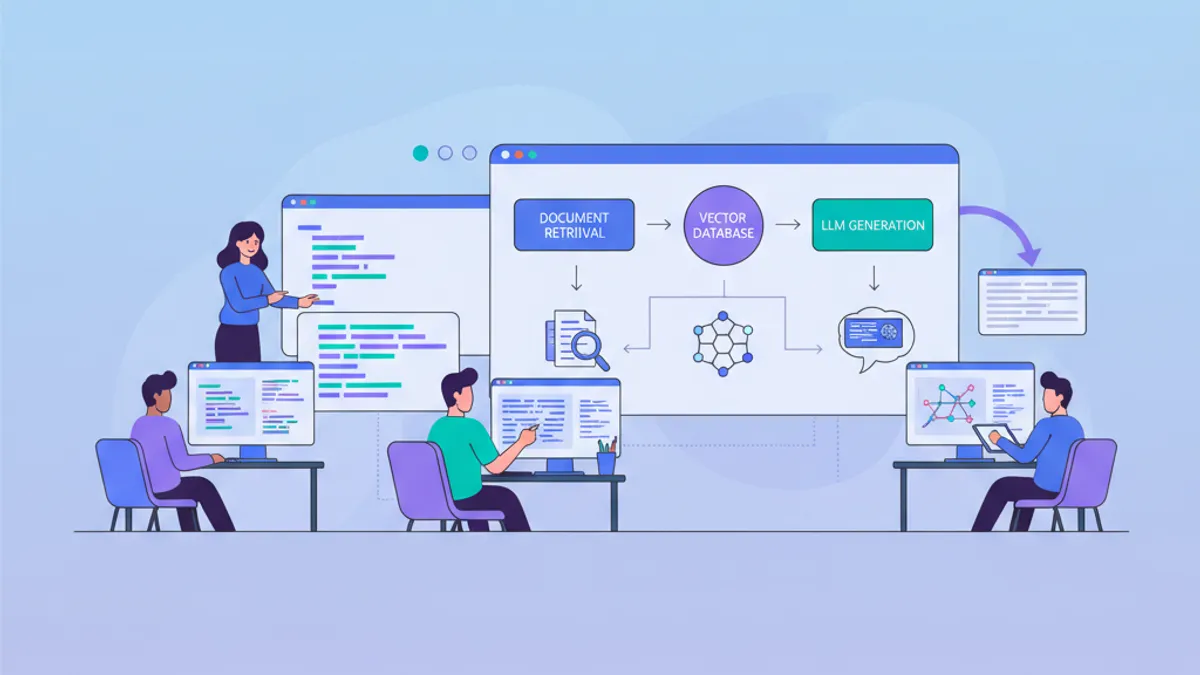
Retrieval-Augmented Generation (RAG), LLM çıktılarını gerçek ve güncel verilere dayandırmak için standart mimari haline geldi. 2026'da veri bilimi ve yapay zeka mühendisliği mülakatlarında RAG soruları artık klasik ML konularının yanında yer alıyor; hem sistem tasarımı düşüncesini hem de uygulamalı geliştirme becerilerini ölçüyor.
Retrieval-Augmented Generation, bir geri getirme sistemini (bilgi tabanı üzerinde vektör araması) bir LLM üreticisiyle birleştirir; böylece model, ezberlenmiş eğitim verilerine güvenmek yerine gerçek belgelere dayanarak yanıt verir.
RAG Pipeline'ı Baştan Sona Nasıl Çalışır
Bir RAG sistemi iki aşamada çalışır: bilgi tabanını oluşturan çevrimdışı alım (ingestion) aşaması ve ilgili bağlamı getirip yanıt üreten çevrimiçi sorgu aşaması.
Alım sırasında ham belgeler, vektör veritabanında depolanmadan önce temizleme, parçalama (chunking) ve gömme (embedding) işlemlerinden geçer. Çıkarım sırasında kullanıcı sorgusu aynı gömme yolunu izler ve en yakın komşu araması en ilgili parçaları getirir. Bu parçalar LLM isteminin (prompt) bir parçası olur ve üretilen yanıtı kaynak materyale dayandırır.
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
Bu pipeline, temel RAG döngüsünü kapsar: parçala, göm, depola, getir, üret. search_type="mmr" parametresi, getirilen parçaların hem ilgili hem de çeşitli olmasını sağlayarak bağlam penceresindeki tekrarı azaltır.
Gerçekten Önemli Olan Chunking Stratejileri
Chunking, geri getirme kalitesini diğer tüm bileşenlerden daha fazla belirler. Kötü chunking, geri getiricinin ya bağlamdan yoksun ya da sinyali alakasız içerikle seyrelten parçalar döndürmesi demektir.
2026'da üretim sistemlerinde üç chunking yaklaşımı baskın:
Sabit boyutlu chunking, metni belirli bir token sayısında (genellikle 256 ile 512 token arasında) örtüşmeyle (overlap) böler. Uygulaması basittir ancak cümleleri ve fikirleri yarıda keser.
Anlamsal (semantic) chunking, ardışık cümleler arasındaki gömme benzerliğini ölçerek konu sınırlarını tespit eder. Benzerlik bir eşiğin altına düştüğünde yeni bir parça başlar. Her parça, metnin keyfi bir diliminden ziyade tutarlı bir fikir taşır.
Geç chunking (late chunking), transformer modelini önce belgenin tamamına uygular ve bağlamsal token gömüleri üretir, ardından parçalara böler. Bu, geleneksel chunking'in yok ettiği uzun menzilli bağımlılıkları korur.
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
Kritik mülakat içgörüsü: parça boyutu bir kesinlik-duyarlılık (precision-recall) ödünleşimidir. Küçük parçalar (100 token) geri getirme kesinliğini artırır ama bağlamı parçalar. Büyük parçalar (1000 token) bağlamı korur ama gömme özgüllüğünü seyreltir. Çoğu üretim sistemi, %10 ile 20 örtüşmeyle 256 ile 512 token aralığına oturur.
Üretimde Vektör Veritabanları ve Gömme Modelleri
Vektör veritabanı gömüleri saklar ve hızlı yaklaşık en yakın komşu (ANN) aramasını destekler. Doğru gömme modeli ile vektör veritabanı kombinasyonunu seçmek, geri getirme gecikmesini ve doğruluğunu doğrudan etkiler.
2026'da gömme modelleri birkaç yüksek performanslı seçenek etrafında birleşti. OpenAI'nin text-embedding-3-large modeli (3072 boyut) ve BAAI'nin bge-m3 ile Cohere'in embed-v4 gibi açık kaynak alternatifleri güçlü çok dilli geri getirme sunar. MTEB lider tablosu, gömme kalitesini karşılaştırmak için standart kıyaslama olmaya devam ediyor. text-embedding-3-large modelinin Matryoshka representation learning desteği ile boyut azaltma (1024 veya 256'ya) minimum kalite kaybıyla mümkün olup depolama maliyetlerini önemli ölçüde düşürür.
Vektör veritabanı pazarı 2026'da konsolide oldu. Dört ürün, üretim RAG iş yüklerinin büyük çoğunluğunu karşılıyor:
| Veritabanı | İndeksleme | Yönetilen | Güçlü yönü |
|---|---|---|---|
| Pinecone | Özel | Evet | Sıfır operasyon, yerleşik çıkarım, hibrit arama |
| Weaviate | HNSW | Evet/Kendin | Tek sorguda yerel BM25 + yoğun füzyon |
| Qdrant | HNSW | Evet/Kendin | Rust performansı, payload filtreleme, en iyi ücretsiz katman |
| pgvector | IVF, HNSW | Kendin | Mevcut yığınlar için PostgreSQL entegrasyonu |
Mülakat tartışmaları için kritik nokta, HNSW (Hierarchical Navigable Small World) algoritmasını anlamaktır: her düğümün en yakın komşularına bağlandığı çok katmanlı bir grafik kurar ve daha yüksek bellek kullanımı pahasına O(log n) arama sağlar.
Maliyet dönüm noktası ayda 60 ile 80 milyon sorgudur. Bu eşiğin üzerinde, sabit maliyetli altyapıda kendi kendine barındırılan Qdrant veya Weaviate, yönetilen Pinecone Serverless'ı sürekli olarak 3x ile 10x arasında geçer.
Data Science & ML mülakatlarında başarılı olmaya hazır mısın?
İnteraktif simülatörler, flashcards ve teknik testlerle pratik yap.
Hibrit Geri Getirme: Yoğun ve Seyrek Aramayı Birleştirmek
Saf vektör araması, tam anahtar kelime eşleşmelerinde ve nadir terimlerde başarısız olur. Saf sözcüksel arama (BM25) anlamsal benzerliği kaçırır. Hibrit geri getirme ikisini birleştirir ve 2026'da üretim RAG sistemleri için varsayılan yaklaşımdır.
Standart kalıp, her iki geri getiriciden gelen sıralanmış sonuçları birleştirmek için Reciprocal Rank Fusion (RRF) kullanır:
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
Hibrit geri getirme, kullanıcının abonelik iptali sorduğu ancak ilgili belgenin hesap fesih politikası ifadesini kullandığı kelime dağarcığı uyumsuzluğu sorununu çözer. BM25 tam terim örtüşmesini yakalarken vektör araması anlamsal ilişkiyi yakalar.
Yeniden Sıralama (Reranking): İkinci Aşama Filtresi
Geri getirme adaylar döndürür. Yeniden sıralama, onları gerçek ilgililiğe göre sıralar. Cohere Rerank veya bge-reranker-v2.5-gemma2-lightweight gibi cross-encoder yeniden sıralayıcılar, her sorgu-belge çiftini birlikte puanlayarak bi-encoder benzerliğinden çok daha doğru ilgililik puanları üretir.
İki aşamalı geri getirme pipeline'ı, geniş ilk aşama geri çağırma (vektör + BM25 ile en iyi 50 ile 100 aday) ardından kesin yeniden sıralama (istem için en iyi 5 ile 10) üretimde standarttır. Bu, gecikmeyi yönetilebilir tutar: ilk aşama hızlı ANN aramasını kullanır, pahalı cross-encoder ise yalnızca küçük bir aday kümesini işler.
Cross-encoder'lar bi-encoder'lardan daha doğrudur çünkü sorgu ve belgeyi tüm transformer katmanları boyunca birlikte işler. Bi-encoder'lar onları bağımsız olarak gömerek ince taneli etkileşim sinyallerini kaybeder. Ödünleşim hızdır: cross-encoder'lar önceden indekslenemez.
Adaptif RAG: Sorguları Doğru Pipeline'a Yönlendirme
Her sorgu aynı geri getirme karmaşıklığına ihtiyaç duymaz. Adaptif RAG, her soruyu optimal yola yönlendiren küçük bir sınıflandırıcı eğitir:
- Geri getirme yok: Modelin zaten bildiği basit gerçeğe dayalı sorgular için
- Tek adımlı geri getirme: Orta düzey sorgular için
- Çok adımlı yinelemeli geri getirme: Karmaşık akıl yürütme için
Bu kalıp, karma iş yüklerinde maliyet ve doğruluğu dengeler. Günde 100.000 sorgu işleyen bir üretim sistemi, basit soruları pahalı çok adımlı pipeline'lardan uzaklaştırarak çıkarım maliyetlerini %40 azaltabilir.
Sınıflandırıcının kendisi küçük bir ince ayarlı model veya şu soruyu soran bir sıfır atış istemi olabilir: Bu soruyu doğru yanıtlamak için harici bilgi gerekiyor mu?
Spekülatif RAG: Hız için Gecikme Takası
Spekülatif RAG, geri getirmeyi hızlı bir taslak üretimle paralel çalıştırır. Taslak yüksek güven gösteriyorsa (logprob ile ölçülen), geri getirme adımı tamamen atlanır. Güven düşükse, getirilen bağlam taslakla birleştirilir ve yeniden üretim gerçekleşir.
Bu yaklaşım, yüksek güvenli sorgularda ortalama gecikmeyi %30 ile 40 arasında azaltır. Gerçek zamanlı sohbet botları, otomatik tamamlama önerileri ve her sorguda kapsamlı kaynak göstermekten çok yanıt süresinin önemli olduğu müşteri hizmetleri sistemleri için en iyi sonucu verir.
Ödünleşim: spekülatif RAG, model aşırı güvenli olduğunda bazen temellendirme olmadan yanıtlar döndürür. Üretim sistemleri bunu güven kalibrasyonu ve belirsizlik bir eşiği aştığında tam geri getirmeye geri dönüşle eşleştirir.
Agentic RAG: Tek Seferlik Geri Getirmenin Ötesi
Naif RAG bir kez getirir ve üretir. Agentic RAG, LLM'yi ne zaman getireceğine, neyi getireceğine ve getirilen bağlamın yeterli olup olmadığına karar veren bir akıl yürütme ajanı olarak ele alır.
2026'da agentic RAG, çok adımlı akıl yürütme gerektiren karmaşık sorgular için baskın kalıptır. Ajan şunları yapabilir:
- Öz değerlendirme: Getirilen belgelerin soruyu yanıtlayıp yanıtlamadığını değerlendirme
- Yeniden sorgulama: İlk sonuçlar yetersizse arama sorgusunu yeniden formüle etme
- Yönlendirme (routing): Farklı bilgi kaynakları arasında seçim yapma (vektör DB, SQL veritabanı, API)
- Doğrulama: Birden çok getirilen pasaj arasında gerçekleri çapraz kontrol etme
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
Bu kalıp (getir, derecelendir, isteğe bağlı olarak yeniden yaz ve yeniden dene) Corrective RAG (CRAG) olarak bilinir. LangChain'in AgentExecutor'ı 2026 itibarıyla kullanımdan kaldırılmıştır; yeni projeler hazır kalıplar için create_react_agent() veya özel orkestrasyon için LangGraph'ın StateGraph'ını kullanmalıdır. Veri bilimciler için LangChain kalıpları hakkında daha fazla bilgi için özel makaleye bakılabilir.
Graph RAG: Yapılandırılmış Bilgi Geri Getirme
Graph RAG, belgelerden varlıkları ve ilişkileri bir bilgi grafiğine çıkarır, ardından hem grafiği hem de vektör deposunu sorgular. Bu mimari, yanıtları yapılandırılmamış metin benzerliği yerine açık varlık ilişkilerine dayandırarak gerçeğe dayalı sorgulardaki halüsinasyonu azaltır.
Alım pipeline'ı her belge parçasından üçlüler (özne, yüklem, nesne) çıkarır. Sorgu zamanında sistem, sorudaki ilgili varlıkları belirler, bağlantılı gerçekler için bilgi grafiğini gezer ve grafikten getirilen bağlamı vektörle getirilen pasajlarla birleştirir.
Graph RAG, X belgesinde bahsedilen framework'ü kullanan projeyi hangi ekip yönetiyor gibi çok adımlı (multi-hop) akıl yürütme gerektiren sorularda, yani birden çok belge arasında gerçekleri birleştirmeyi gerektiren sorgularda mükemmeldir. Saf vektör araması burada zorlanır çünkü tek bir parça tam yanıtı içermez.
Graph RAG, gerçeğe dayalı doğruluğu önemli ölçüde artırır (varlık ağırlıklı sorgularda halüsinasyonda %40'a varan azalma) ancak olgun bir varlık çıkarma pipeline'ı gerektirir. Gürültülü çıkarım gürültülü bir grafik üretir ve sonuçları naif RAG'in altına düşürebilir. Ayrıca Microsoft'un GraphRAG projesi 2026'da bakım moduna girmiştir; hata düzeltmeleri alacak ancak yeni özellikler almayacaktır.
Microsoft'un LazyGraphRAG varyantı (Haziran 2025'te yayınlandı), özetlemeyi sorgu zamanına erteleyerek indeksleme maliyetlerini önemli ölçüde azaltır ve bu da ön grafik oluşturmanın pratik olmadığı keşif amaçlı analiz veya akış verileri için uygun hale getirir.
RAG Sistemleri için AB Yapay Zeka Yasası Uyumluluğu
AB Yapay Zeka Yasası Ağustos 2026'da geniş çapta yürürlüğe girdi. Yasa kapsamındaki ilk yüksek profilli para cezası Mayıs 2026 sonunda bir Avrupa bankacılık konsorsiyumunun RAG sohbet botuna verildi ve Nisan 2026'da Frankfurt merkezli bir varlık yönetim şirketi, veri kökenini açıklamayan müşteriye yönelik bir RAG sistemi için 4,5 milyon euro ceza aldı.
RAG mimarileri doğal olarak birkaç uyumluluk gereksinimini karşılar: kaynak izlenebilirliği (parçalar belge referansları taşır), yanıt şeffaflığı (alıntılar gösterilebilir) ve denetlenebilirlik (geri getirme günlükleri yapısı gereği mevcuttur). Ancak tam uyumluluk ek önlemler gerektirir:
Risk sınıflandırması: Herkese açık bir sohbet botu sınırlı risk kapsamındadır (şeffaflık gerekli). Tıbbi veya hukuki bir RAG sistemi, daha katı belgeleme ve gözetim yükümlülükleriyle yüksek risktir.
Denetim günlükleme: Hangi sorunun hangi getirilen parçaları tetiklediğini ve hangi yanıtın üretildiğini kaydetme. Bu günlük, gerekli izlenebilirliğin temelini oluşturur.
İnsan gözetimi: Yüksek riskli sistemler hassas vakalarda insan doğrulaması, çıktıları düzeltme yeteneği ve talep üzerine indekslenmiş verileri silme mekanizmaları gerektirir.
Veri yerleşimi: AB'de indeksleme barındırma ve verilerin yargı yetkisi dışındaki üçüncü taraf hesaplarından geçmemesini sağlamak için BYOK (Bring Your Own Key) kullanma.
Uyumsuzluk, küresel yıllık gelirin %7'sine mal olabilir. Mülakat tartışmaları için kritik nokta, RAG'ın doğal alıntılama yeteneğinin bir avantaj olduğu ancak yönetişim katmanının yerini almadığıdır.
RAG Sistemlerini Değerlendirme: Önemli Metrikler
RAG değerlendirmesi geri getirme metrikleri ve üretim metrikleri olarak ikiye ayrılır. Hataları teşhis etmek için her ikisi de bağımsız olarak ölçülmelidir.
Geri getirme metrikleri:
- Recall@k: İlgili belgeler en iyi k sonuçta yer aldı mı?
- MRR (Mean Reciprocal Rank): İlk ilgili sonuç ne kadar yüksekte sıralandı?
- NDCG: Sıralama ideal ilgililik düzeniyle eşleşiyor mu?
Üretim metrikleri:
- Sadakat (faithfulness): Yanıt yalnızca getirilen bağlamdaki bilgileri mi kullanıyor? (Halüsinasyonu ölçer)
- Yanıt ilgililiği: Yanıt asıl soruyu ele alıyor mu?
- Bağlam kesinliği: Getirilen parçalar yanıtta gerçekten kullanılıyor mu?
Ragas ve DeepEval gibi framework'ler, LLM-yargıç (LLM-as-judge) kalıplarını kullanarak bu değerlendirmeleri otomatikleştirir. En popüler veri bilimi mülakat soruları giderek RAG değerlendirme tasarımını içeriyor; bir RAG sisteminin doğru çalışıp çalışmadığını nasıl ölçeceğinizi açıklamanız beklenir.
Üretimdeki Hata Modları ve Hata Ayıklama
RAG sistemleri öngörülebilir şekillerde başarısız olur. Bu kalıpları bilmek hem mülakatlar hem de gerçek dünya dağıtımı için gereklidir.
Bağlam penceresi kirliliği, çok fazla getirilen parça ilgili sinyali seyrelttiğinde olur. LLM 10 parça alır ama yalnızca 2'si yararlı bilgi içerir. Çözüm: filtrelemek için bir yeniden sıralayıcı kullanın ve geri getiriciden gelen top-k değerini azaltın.
Chunking artefaktları, sabit boyutlu bölme cümleleri, tabloları veya kod bloklarını öğe ortasında kırdığında oluşur. Getirilen parça sözdizimsel olarak eksik ve anlamsal olarak işe yaramazdır. Anlamsal chunking veya belge farkında bölme (başlıklara, paragraflara, kod çitlerine saygı gösteren) bunu çözer.
Gömme kayması (embedding drift), gömme modeli güncellendiğinde ancak vektör deposu hâlâ eski modelden gelen gömüleri içerdiğinde ortaya çıkar. Yeni modelle kodlanan sorgular, eski modelin oluşturduğu bir vektör uzayında arama yaparak geri getirme kalitesini düşürür. Çözüm: herhangi bir model değişikliğinden sonra tüm külliyatı yeniden gömün.
Bayat indeksler, alım pipeline'ı belge güncellemelerinin gerisinde kaldığı için güncel olmayan bilgiler sunar. Makine öğrenmesi sistemlerinde bu, eğitim-sunum çarpıklığına (training-serving skew) benzer; geri getirme sistemi, üretimde var olandan farklı bir veri dağılımı görür.
Kaynaklar
- Turing Post: 20 Advanced RAG Types to Know in 2026 - RAG kalıplarının kapsamlı taksonomisi
- LangChain and LangGraph 1.0 Milestones - AgentExecutor'ın kullanımdan kaldırılması, yeni kalıplar
- Microsoft GraphRAG GitHub - bakım modu durumu
- IgnitionRAG EU AI Act Guide - RAG sistemleri için uyumluluk gereksinimleri
- MarkTechPost: Best Vector Databases in 2026 - pazar konsolidasyonu ve fiyatlandırma
Pratik yapmaya başla!
Mülakat simülatörleri ve teknik testlerle bilgini test et.
Veri Bilimi Mülakatlarında RAG için Önemli Çıkarımlar
- RAG, modeli yeniden eğitmeden gerçeğe dayalı, temellendirilmiş yanıtlar üretmek için geri getirmeyi (bilgi tabanı üzerinde vektör araması) LLM üretimiyle birleştirir
- Chunking stratejisi, geri getirme kalitesi üzerinde en yüksek etkiye sahiptir; çoğu kullanım durumu için anlamsal chunking ve geç chunking, sabit boyutlu bölmeden daha iyi performans gösterir
- Reciprocal Rank Fusion ile hibrit geri getirme (yoğun vektörler + seyrek BM25), saf vektör aramasının çözemediği kelime dağarcığı uyumsuzluğu sorununu çözen üretim varsayılanıdır
- Cross-encoder yeniden sıralayıcılar, geniş geri getirmeden sonra bir kesinlik katmanı ekler ve gecikmeyi kabul edilebilir tutmak için yalnızca küçük bir aday kümesini işler
- Adaptif RAG sorguları uygun pipeline karmaşıklığına yönlendirir, karma iş yüklerinde maliyetleri %40 azaltır
- Spekülatif RAG temellendirme yerine hız takas eder, yüksek güvenli sorgularda gecikmeyi %30 ile 40 arasında azaltır
- Agentic RAG (getir, derecelendir, yeniden yaz, yeniden dene) ve Graph RAG (varlık-ilişki çıkarımı), naif RAG'in başarısız olduğu karmaşık çok adımlı sorguları ele alır
- AB Yapay Zeka Yasası uyumluluğu (Ağustos 2026), üretim RAG sistemleri için denetim günlükleme, insan gözetimi ve risk sınıflandırması gerektirir
- Değerlendirme, pipeline'ın nerede bozulduğunu teşhis etmek için geri getirme metriklerini (Recall@k, MRR) üretim metriklerinden (sadakat, yanıt ilgililiği) ayırmalıdır
- En yaygın üretim hataları (bağlam kirliliği, chunking artefaktları, gömme kayması, bayat indeksler) belirlendiğinde hepsinin basit çözümleri vardır
Data Science & ML kodundaki hatayı bulabilir misin?
Gerçek bir kod parçası, gizli bir hata, günde bir deneme. Denemek için hesap gerekmez.

Yazan:
Anthony Fillion-MailletSharpSkill kurucusu
10 yılı aşkın süredir fullstack geliştirici. SharpSkill’i yönetiyor ve burada yayımlanan her şeyden sorumlu.
24 Ağustos 2026 tarihinde güncellendi
Etiketler
Paylaş
İlgili makaleler
Makine Öğrenmesi İçin Öznitelik Mühendisliği: Teknikler ve Mülakat Soruları 2026
Makine öğrenmesi öznitelik mühendisliği tekniklerini Python ile uygulamalı olarak öğrenin. Kodlama, ölçekleme, öznitelik seçimi, scikit-learn pipeline yapıları ve veri bilimi mülakat soruları.

XGBoost vs LightGBM 2026: Gradient Boosting ve Data Science Mülakat Soruları
2026 yılında XGBoost ve LightGBM'in kapsamlı karşılaştırması. Mimari farklılıklar, optimizasyon teknikleri ve machine learning mülakat sorularına hazırlık rehberi.

2026'da Scikit-Learn Pipeline: Özellik Mühendisliği ve Mülakat Soruları
Scikit-learn Pipeline ve ColumnTransformer için kapsamlı kılavuz. Özellik mühendisliği, veri sızıntısı önleme ve makine öğrenimi mülakat sorularını kapsar.