2026'da ETL ve ELT: Veri Hattı Mimarisi ve Mülakat Soruları
ETL ve ELT, veri hattı mimarisine iki farklı yaklaşımı temsil eder. Bu karşılaştırma, her bir kalıbın ne zaman kullanılacağını, destekleyen araçları ve veri mühendislerinin hat tasarımı hakkında karşılaştığı mülakat sorularını açıklar.
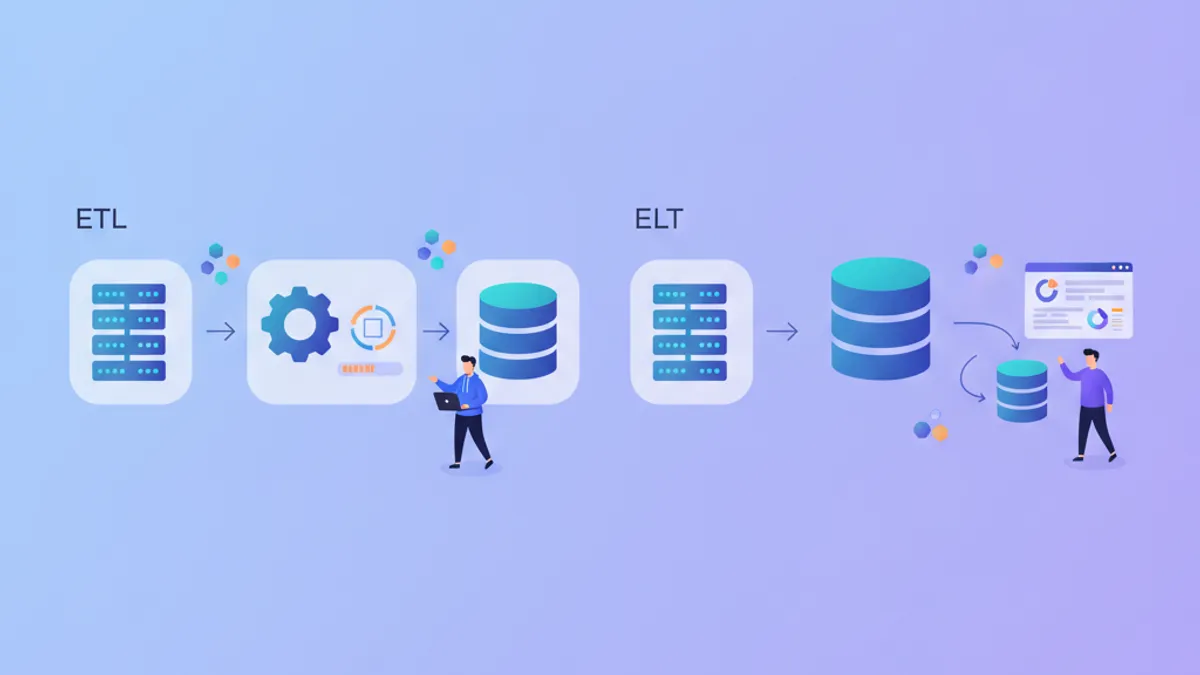
ETL ve ELT, verilerin kaynak sistemlerden analitik ortamlara nasıl taşındığını tanımlar. Çıkartma, dönüştürme ve yükleme (ETL) ile çıkartma, yükleme ve dönüştürme (ELT) arasındaki seçim, altyapı maliyetlerini, veri tazeliğini ve mühendislik ekiplerinden gereken becerileri etkiler.
ETL, verileri hedef sisteme yüklemeden önce dönüştürür ve özel hesaplama kaynakları gerektirir. ELT, önce ham verileri yükler, ardından hedef veri ambarının işlem gücünü kullanarak dönüştürür. 2026'daki bulut yerel veri yığınlarının çoğu, hesaplama gücü talep üzerine ölçeklenebildiği için ELT'yi tercih eder.
ETL Mimarisi: Yüklemeden Önce Dönüştürme
ETL, veri ambarlarının sınırlı hesaplama kapasitesine sahip olduğu ve depolamanın pahalı olduğu dönemlerde ortaya çıktı. Bu kalıp mantıklıydı: verileri ambar dışında filtrelemek ve toplamak, yalnızca analizin gerektirdiği şeyleri yüklemek. Oracle Warehouse Builder, Informatica PowerCenter ve Talend bu model etrafında araçlar geliştirdi.
ETL'deki dönüştürme aşaması ara sunucularda çalışır. Veriler kaynaktan hazırlık alanına taşınır, temizlenir ve yeniden şekillendirilir, ardından hedefe yüklenir. Bu yaklaşım ambar yükünü azaltır ancak dönüştürme katmanında bir darboğaz oluşturur.
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
ETL, dönüştürme mantığı sabit kaldığında ve veri hacimleri öngörülebilir olduğunda iyi çalışır. Dezavantajı, gereksinimler değiştiğinde ortaya çıkar: dönüşümleri değiştirmek, geçmiş verileri sıfırdan yeniden işlemeyi gerektirir.
ELT Mimarisi: Önce Yükle, Ambarda Dönüştür
ELT, dönüştürmeyi veri ambarına taşır. Snowflake, BigQuery, Databricks ve Redshift, sorgu karmaşıklığıyla ölçeklenen neredeyse sınırsız hesaplama gücü sağlar. Ham verileri önce yüklemek kaynak durumunu korur; dönüşümler, sürüm kontrolü yapılabilen ve yeniden çıkarmadan yeniden çalıştırılabilen SQL modelleri haline gelir.
dbt (data build tool) projesi, SQL dönüşümlerini kod olarak ele alarak ELT'yi popülerleştirdi. Kara kutu ETL işleri yerine, dönüşümler ham tablolara başvuran ve türetilmiş modeller oluşturan SELECT ifadeleri olarak sürüm kontrolünde yaşar.
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggELT, ham verileri korur ve bu da iş mantığı değiştiğinde yeniden işlemeyi mümkün kılar. Altı ay önce bir hesaplama yanlışsa, dbt modelini düzeltip tam yenileme çalıştırmak geçmiş verileri düzeltir. ETL ile aynı düzeltme, artık orijinal kayıtlara sahip olmayabilecek kaynaklardan yeniden çıkarmayı gerektirir.
Karşılaştırma Tablosu: ETL ve ELT Takasları
| Faktör | ETL | ELT |
|---|---|---|
| Hesaplama konumu | Özel dönüştürme sunucusu | Hedef veri ambarı |
| Ham veri saklama | Dönüştürmeden sonra genellikle silinir | İniş bölgesinde korunur |
| Yeniden işleme maliyeti | Kaynaktan yeniden çıkart | SQL modellerini yeniden çalıştır |
| Şema esnekliği | Dönüştürme zamanında sabitlenir | Okuma sırasında şema mümkün |
| Araç örnekleri | Informatica, Talend, SSIS | dbt, Dataform, SQLMesh |
| En uygun | Sabit gereksinimler, eski sistemler | Değişen gereksinimler, bulut ambarları |
| Gecikme | Daha yüksek (yüklemeden önce dönüştür) | Daha düşük (yükle sonra dönüştür) |
| Veri yönetimi | Daha kolay (veriler ambardan önce filtrelenir) | Ambar düzeyinde kontroller gerektirir |
Data Engineering mülakatlarında başarılı olmaya hazır mısın?
İnteraktif simülatörler, flashcards ve teknik testlerle pratik yap.
Hibrit Yaklaşımlar: ETL ve ELT Birleştiğinde
Modern veri yığınları nadiren saf ETL veya ELT kullanır. Apache Airflow her iki kalıbı da karıştıran hatları orkestre eder. Hassas veriler yüklemeden önce anonimleştirilebilir (ETL adımı), toplama işlemleri ise ambarda çalışır (ELT).
Fivetran ve Airbyte, ham verileri dönüştürme olmadan çıkartır ve yükler, ardından dbt ambar içinde dönüştürür. Ancak bu araçlar çıkartma sırasında hafif dönüşümleri de destekler: sütun seçimi, veri türü dönüştürme, PII alanlarını hashleme. Bu, ETL/ELT sınırını bulanıklaştırır.
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
Yukarıdaki hat, Airbyte ile Salesforce'tan çıkartır (senkronizasyon sırasında e-posta adreslerini hashleyebilir), Snowflake'e yükler, ardından iş dönüşümleri için dbt modellerini çalıştırır. Ne saf ETL ne de saf ELT, ancak pratik.
Mülakat Soruları: Veri Mühendisleri için ETL ve ELT
Modern veri yığınları kullanan şirketlerdeki veri mühendisliği pozisyonları için teknik mülakatlar, hat mimarisi anlayışını sorgular. Bu sorular, ETL/ELT mülakat hazırlık modüllerinden kalıplara dayalı olarak sıkça karşımıza çıkar.
Soru 1: ETL'yi ELT Yerine Ne Zaman Tercih Edersiniz?
Güçlü cevaplar belirli senaryoları tanımlar:
- Uyumluluk gereksinimleri: GDPR veya HIPAA, belirli verilerin ham formda asla ambara ulaşmamasını zorunlu kılar. PII, yüklemeden önce anonimleştirilmeli veya kaldırılmalıdır.
- Eski ambar kısıtlamaları: Teradata gibi yerinde sistemler veya sabit hesaplama kapasiteli eski Redshift yapılandırmaları, önceden toplanmış yüklemelerden faydalanır.
- Ağ maliyetleri: Bulut ambarına günlük 10TB yükleyip dönüştürmeden sonra %90'ını atmak, çıkış bant genişliğini boşa harcar. Ön filtreleme ekonomik olarak mantıklıdır.
Zayıf cevaplar "ETL eskidir" der veya somut senaryolar vermez. Mülakatçılar nüans arar.
Soru 2: ELT Hattında Şema Değişikliklerini Nasıl Yönetirsiniz?
Bu soru, ham veri iniş bölgeleri anlayışını test eder. Beklenen konular:
- Şema geçişi olmadan yeni alanları absorbe eden JSON veya yarı yapılandırılmış sütunlar
- Sütunları açıkça seçen, downstream modelleri kaynak değişikliklerinden izole eden staging modelleri
- Beklenen sütunlar kaybolduğunda yapıları başarısız kılan dbt makroları veya Dataform assertions
- Monte Carlo veya Great Expectations gibi araçlarla şema kaymasını izleme
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
Soru 3: Airflow ile ETL Orkestrasyonunu, ELT için dbt Çalıştırmayla Karşılaştırın
Bu soru, bu araçların farklı sorunları çözdüğü anlayışını sorgular:
- Airflow görevleri orkestre eder: çıkartma, API çağrıları, dosya transferleri, model eğitimi. Heterojen işler arasındaki bağımlılıkları yönetir.
- dbt verileri ambar içinde dönüştürür. SQL modelleri arasındaki bağımlılıkları yönetir, testler çalıştırır, dokümantasyon oluşturur.
Tam bir hat genellikle ikisini de kullanır: Airflow, Airbyte senkronizasyonlarını tetikler, tamamlanmasını bekler, ardından dbt çalıştırmalarını tetikler. Hangi aracın ne zaman kullanılacağını bilmek, kıdemli adayları ayırt eder.
Soru 4: ELT Hattınız Günde 500M Satır İşliyor ve Analistler Yavaş Sorgular Bildiriyor
Bu açık uçlu soru, teşhis düşüncesini test eder:
- Model materyalizasyonunu kontrol edin: Ağır modeller hâlâ view mi? Artımlı modeller veya tablolar yardımcı olabilir.
- Bölümleme ve kümeleme: BigQuery için, fact tabloları tarihe göre bölümlenmiş mi? Snowflake için, kümeleme yaygın sorgu kalıpları için optimize edilmiş mi?
- Sorgu pushdown: Analistler önceden toplanmış marts yerine staging modellerini mi sorguluyor?
- Ambar boyutlandırma: Sorgu saatlerinde hesaplama uygun şekilde ölçeklendirilmiş mi?
- Tazelik gereksinimleri: Dönüştürme mesai saatleri yerine gece çalışabilir mi?
Tek doğru cevap yoktur. Mülakatçılar sistematik sorun gidermeyi değerlendirir.
2026'da Araç Manzarası
Veri entegrasyon pazarı birkaç kalıp etrafında konsolide oldu:
Çıkartma ve yükleme: Fivetran, Airbyte, Stitch ve Meltano, EL kısmını yönetir. Bu araçlar yüzlerce kaynağa bağlanır ve özel kod olmadan bulut ambarlarına senkronize eder.
Dönüştürme: dbt, SQL tabanlı dönüştürmede hakimdir. Alternatifler arasında Dataform (artık Google Cloud'un parçası), SQLMesh (sanal veri ortamlarıyla açık kaynak) ve Coalesce (görsel modelleme) bulunur.
Orkestrasyon: Airflow, karmaşık hatlar için varsayılan olmaya devam eder. Dagster ve Prefect, daha iyi yerel geliştirme ve varlık merkezli görünümlerle alternatifler sunar.
Kalite: Great Expectations, dbt testleri, Monte Carlo ve Soda veri kalitesi izlemesi sağlar. Bunlar, çıkartma ile downstream tüketim arasındaki sorunları yakalar.
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
Pratik yapmaya başla!
Mülakat simülatörleri ve teknik testlerle bilgini test et.
Yeni Projeler için Hat Mimarisi Seçimi
2026'da çoğu sıfırdan proje için ELT varsayılandır. Bulut ambarı hesaplama gücü, dönüştürme sunucularını sürdürmekten daha az maliyetlidir. Ham veri koruması, geriye dönük düzeltmeleri mümkün kılar. SQL tabanlı dönüşümler denetlenebilir ve sürüm kontrolüne tabidir.
ETL şunlar için geçerliliğini korur:
- Ambar girişinden önce veri minimizasyonu gerektiren düzenleyici ortamlar
- Dönüştürmenin alım anında gerçekleşmesi gereken gerçek zamanlı akış (Kafka Streams, Flink)
- Sınırlı downstream depolamaya sahip uç bilişim senaryoları
- Kaynak sistemin dışa aktarma formatını kontrol ettiği eski entegrasyonlar
Mülakat için hazır cevap, her iki kalıbı da kabul eder ve ideolojik tercih olmadan takasları açıklar.
Veri Hattı Mimarisi için Temel Çıkarımlar
- ETL, verileri yüklemeden önce dönüştürür, ambar yükünü azaltır ancak mantık değiştiğinde yeniden işleme sürtünmesi oluşturur
- ELT, önce ham verileri yükler ve sürüm kontrolüne alınabilen, test edilebilen ve geçmiş verilere karşı yeniden çalıştırılabilen SQL tabanlı dönüşümleri mümkün kılar
- Modern yığınlar genellikle her ikisini de birleştirir: hafif çıkartma dönüşümleri (PII hashleme, tür dönüştürme) ile ambar tabanlı toplama
- dbt, SQL modellerini test edilebilir, belgelenmiş kod olarak ele alarak ELT dönüşümü için standart haline geldi
- Mülakat soruları, ezberlenmiş tanımlar yerine senaryo seçimi, şema evrimi yönetimi ve araç takaslarını araştırır
- ELT hatlarında ham veri koruması, kaynaklardan yeniden çıkarmadan geçmiş hesaplamaların düzeltilmesini sağlar
Data Engineering kodundaki hatayı bulabilir misin?
Gerçek bir kod parçası, gizli bir hata, günde bir deneme. Denemek için hesap gerekmez.

Yazan:
Anthony Fillion-MailletSharpSkill kurucusu
10 yılı aşkın süredir fullstack geliştirici. SharpSkill’i yönetiyor ve burada yayımlanan her şeyden sorumlu.
14 Eylül 2026 tarihinde güncellendi
Etiketler
Paylaş
İlgili makaleler
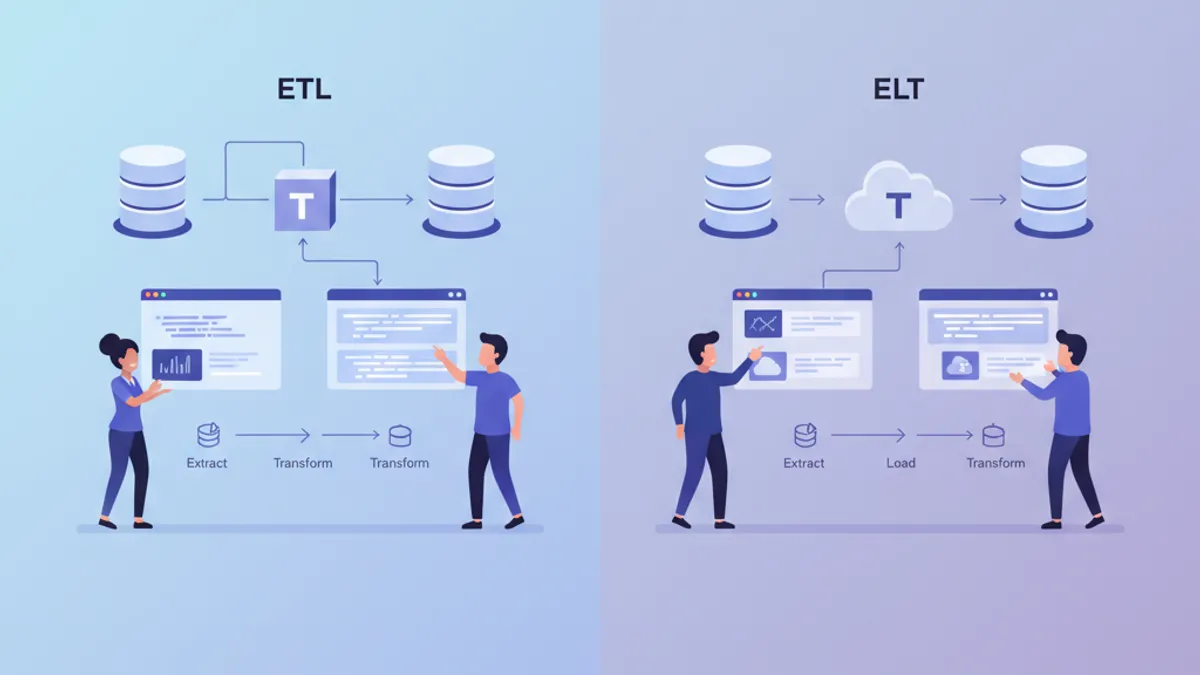
2026'da ETL ve ELT Karşılaştırması: Veri Pipeline Mimarisi Rehberi
Modern veri pipeline'ları için ETL ve ELT karşılaştırması. Mimari farklılıklar, performans dengeleri ve Snowflake, BigQuery, dbt ile uygulama senaryoları.
Apache Airflow 2026: Pipeline Orkestrasyonu, DAG Mimarisi ve Mülakat Soruları
Apache Airflow 3.2 ile Task SDK kullanarak DAG yazımı, dinamik görev eşlemesi, asset partition desteği ve veri mühendisliği mülakatlarında karşılaşılan soruları kapsayan uygulamalı rehber.
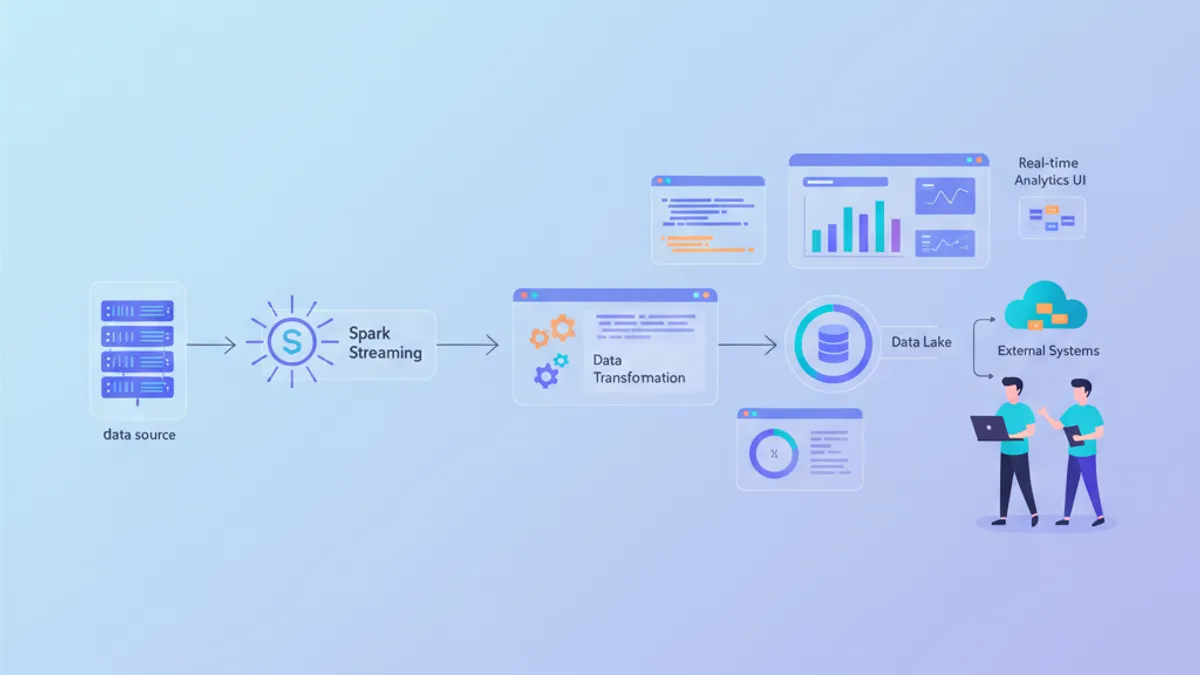
Apache Spark 4: Yeni Ozellikler, Structured Streaming ve Mulakat Sorulari (2026)
Apache Spark 4 hakkinda kapsamli teknik rehber. ANSI SQL modu, VARIANT veri tipi, Real-Time Mode Streaming, Spark Connect ve Data Engineering mulakat sorulari detayli kod ornekleriyle inceleniyor.