2026年のSRE原則:信頼性エンジニアリング、SLOと面接対策
SREの原則を実践レベルで解説。SLIの選び方、SLOとエラーバジェットの計算、Prometheusによるバーンレートアラート、エラーバジェットポリシー、よく出るSRE面接の質問と模範回答までを網羅します。
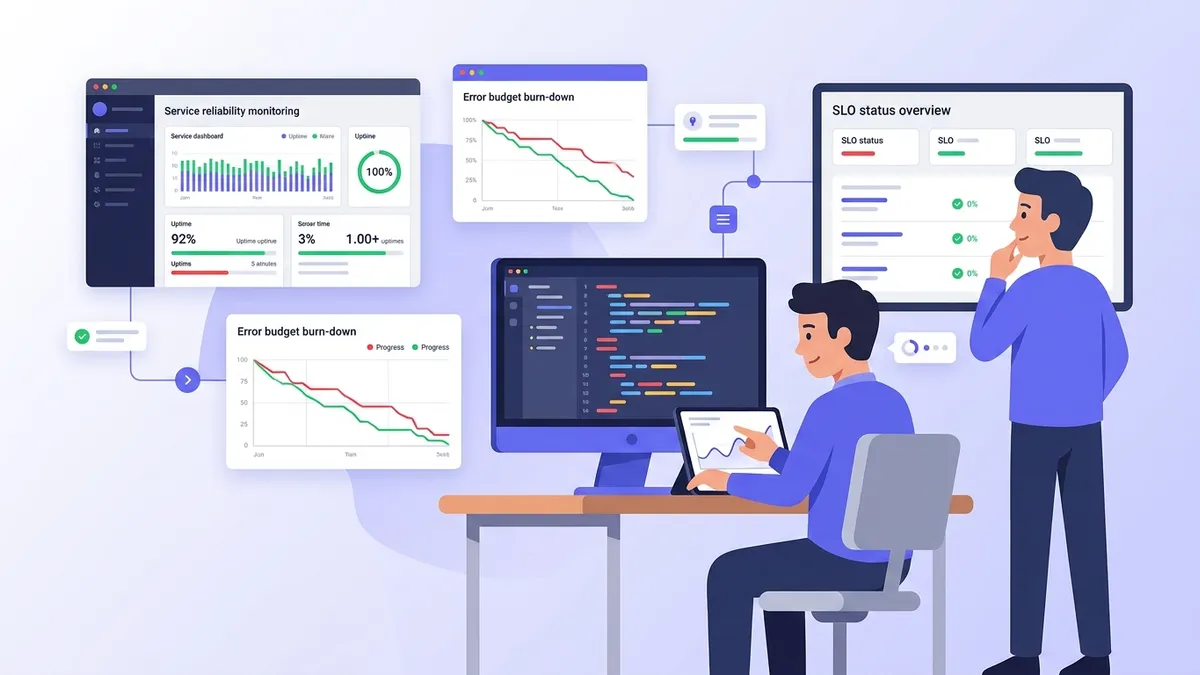
SREの原則は、「信頼性を高める」という曖昧な目標を、開発チームとプロダクトチームが合意できる数値に置き換え、その数値をもとにリリースを進めるか止めるかを判断する仕組みです。Googleが体系化したSite Reliability Engineering(SRE)は、現在では多くのプラットフォームチームで実践されており、その中心にはいくつかの考え方があります。ユーザーが体験する品質を測定する(SLI)、100%未満の目標を設定する(SLO)、目標と100%の差をエラーバジェットとして使う、そしてシステム運用に必要な手作業に上限を設ける、という4点です。2026年のSRE面接でも問われるのはまさにこの部分で、実在するサービスに対してSLOを定義させ、それを守るためのアラートを書かせる形式が一般的です。
SLIは測定値であり、成功したリクエスト数を全リクエスト数で割るように、良いイベントと有効なイベントの比率で表します。SLOはその比率に対する社内目標で、「30日間で99.9%」のように期間とセットで定めます。SLAは顧客との契約上の約束でペナルティを伴い、常にSLOより緩く設定されます。
Site Reliability Engineeringを支えるSREの基本原則
Google SRE本は、信頼性をコストを伴う「機能」の一つとして扱っています。9を一つ増やすたびにエンジニアリングの工数が増え、リリース速度は落ちます。一方でユーザーの手元のネットワークや端末、ISPはそれ以上に不安定なため、99.99%と99.999%の差に気づくことはほとんどありません。目指すべきは最大限の信頼性ではなく、適切な水準の信頼性です。
この前提から、次のような原則が導かれます。
- 信頼性はユーザー側から測定する。 CPU使用率やPodの再起動は原因にすぎません。ユーザーが体験するのは決済の失敗やページ表示の遅さであり、SLIが捉えるべきはそちらです。
- 100%は誤った目標である。 100%のSLOは、あらゆる変更を禁じることと同じです。デプロイには必ずリスクが伴うためです。100%との差がエラーバジェットであり、リリースや実験、移行作業に使うためのものです。
- トイルには上限を設ける。 Googleはトイル削減の章で、運用作業をSREの業務時間の50%未満に抑える指針を示しています。トイルとは、手作業で、繰り返し発生し、自動化可能で、サービスの成長に比例して増える作業を指します。残りの時間は、そのトイルをなくすためのエンジニアリングに充てます。
- ポストモーテムは非難しない(ブレームレス)。 インシデントレビューで問うのは「誰がコマンドを打ったか」ではなく「システムのどこが障害を許したか」です。責められたエンジニアは情報を隠し、責めないレビューは情報を引き出します。
- 監視は症状に対してアラートを出す。 ページ(呼び出し)が発報されるのは、ユーザーが影響を受けている、あるいは受けようとしているときであり、単一ノードの挙動が普段と違うときではありません。
面接で、実務経験のあるSREと本を読んだだけの候補者を分けるのは2つ目の原則です。ジュニアレベルの回答はエラーバジェットを「障害の許容量」として扱います。シニアレベルの回答はそれをリリース管理のツールとして扱います。つまり、プロダクトと信頼性の議論を、意見ではなくデータで行えるようにする仕組みだと説明できるかどうかが評価の分かれ目です。
ユーザー体験を反映するSLIの選び方
良いSLIは0から1の間の比率であり、ユーザーが認識できるイベントから算出されます。SREワークブックは、サービスの種類ごとに次のような候補を挙げています。
| サービスの種類 | 代表的なSLI | 測定箇所 |
|---|---|---|
| リクエスト駆動型API | 可用性、レイテンシ | ロードバランサーやIngressのログ、サーバーメトリクス |
| データパイプライン | 鮮度、正確性、網羅性 | 出力データのタイムスタンプ、検証ジョブ |
| ストレージシステム | 耐久性、読み書きのレイテンシ | ストレージ層、合成監視(プローブ) |
| フロントエンド | ページ読み込み時間、ブラウザで観測されたエラー率 | リアルユーザーモニタリング(RUM) |
ロードバランサーで測定すると、クラッシュしたPodが何も返さないケースのように、アプリケーション自身が認識できない障害も捕捉できます。ブラウザで測定するとCDNやDNSの問題まで拾えますが、モバイル回線の不調によるノイズも混ざります。多くのチームは、データがすでに揃っているロードバランサーまたはIngressから始めます。
Prometheusを使う場合、HTTPサービスの代表的なSLIは可用性の比率とレイテンシの比率の2つです。レイテンシSLIでは閾値より速いリクエストを「良いイベント」として数えるため、パーセンタイルではなく他のSLIと同じ比率として扱えます。
# checkout-sli.promql
# Availability SLI: share of requests that did not fail with a 5xx
sum(rate(http_requests_total{job="checkout-api", code!~"5.."}[5m]))
/
sum(rate(http_requests_total{job="checkout-api"}[5m]))

# Latency SLI: share of requests served in under 300 ms
# Uses the histogram bucket with le="0.3", so 0.3 must be a configured bucket boundary
sum(rate(http_request_duration_seconds_bucket{job="checkout-api", le="0.3"}[5m]))
/
sum(rate(http_request_duration_seconds_count{job="checkout-api"}[5m]))
面接では2つの細かな点がよく問われます。1つ目は、4xxレスポンスは通常「有効かつ良いイベント」として扱うという点です。404やバリデーションエラーはクライアント側の誤りであり、これを失敗に数えると、不正な挙動のクライアント1つでバジェットを使い切ってしまいます。2つ目は、レイテンシの閾値がヒストグラムのバケット境界と一致している必要があるという点です。一致していないと、クエリは何も返さないか、気づかないうちに別のバケットを使ってしまいます。最近のPrometheusはネイティブヒストグラムに対応しており、固定バケットの制約はなくなりますが、スクレイプ側で有効化する必要があります。
SLO目標の設定とエラーバジェットの計算
SLOは、SLI、目標値、期間の3つで構成されます。期間は28日または30日のローリングウィンドウが一般的で、月初にリセットされるのではなく、バジェットが徐々に回復していきます。目標値は過去の実績とユーザーの期待から決めるものであり、資料映えする数字から選ぶものではありません。
次の表は、30日間のウィンドウでそれぞれの目標値が許容する範囲を示しています。計算は単純で、バジェットは (1 - SLO) × 30日 です。
| SLO目標 | エラーバジェット | 30日間で許容される完全停止時間 |
|---|---|---|
| 99% | 1% | 7時間12分 |
| 99.5% | 0.5% | 3時間36分 |
| 99.9% | 0.1% | 43分12秒 |
| 99.95% | 0.05% | 21分36秒 |
| 99.99% | 0.01% | 4分19秒 |
リクエストベースのSLOでは、バジェットを時間ではなくリクエスト数で表します。99.9%でウィンドウ内のリクエストが1,200万件であれば、失敗が許されるのは12,000件です。トラフィックに偏りがあるサービスでは、リクエストベースのほうが公平です。深夜3時の障害は、同じ長さのピーク時の障害よりも消費するバジェットが少なくなるためです。
面接でよく出る課題が、残りのバジェットと消費速度の計算です。コードでの回答を求められた場合、次のようなスクリプトが期待される水準です。
# error_budget.py
from dataclasses import dataclass

@dataclass
class SloWindow:
    objective: float      # 0.999 for a 99.9% SLO
    window_days: int      # rolling window, usually 28 or 30
    total_requests: int   # valid events seen in the window so far
    failed_requests: int  # bad events seen in the window so far

    @property
    def budget_fraction(self) -> float:
        return 1 - self.objective  # 0.001 for 99.9%

    def budget_remaining(self) -> float:
        """1.0 means untouched, 0 means spent, negative means SLO breached."""
        allowed_failures = self.budget_fraction * self.total_requests
        return 1 - self.failed_requests / allowed_failures

    def burn_rate(self, recent_errors: int, recent_total: int) -> float:
        """1.0 means the budget lasts exactly the window; 10 means ten times too fast."""
        return (recent_errors / recent_total) / self.budget_fraction

    def hours_to_exhaustion(self, burn: float) -> float:
        # Remaining share of budget, consumed at `burn` times the sustainable pace
        return self.budget_remaining() * self.window_days * 24 / burn

slo = SloWindow(objective=0.999, window_days=30, total_requests=12_000_000, failed_requests=7_800)
burn = slo.burn_rate(recent_errors=240, recent_total=16_000)
print(f"budget left: {slo.budget_remaining():.0%}")             # 35%
print(f"burn rate: {burn:.1f}")                                 # 15.0
print(f"exhausted in: {slo.hours_to_exhaustion(burn):.1f} h")   # 16.8 h
バーンレート15とは、SLOが0.1%の失敗しか許容していないのに、実際には1.5%のリクエストが失敗している状態を意味します。このペースでは残り35%のバジェットが17時間足らずで尽きるため、深夜でも担当者を呼び出す正当な理由になります。
DevOpsの面接対策はできていますか?
インタラクティブなシミュレーター、flashcards、技術テストで練習しましょう。
複数ウィンドウによるバーンレートアラート
SLIに直接アラートを設定する(「エラー率が0.1%を超えたら通知」)と、短いスパイクのたびにページが飛ぶ一方で、じわじわ進む劣化は見逃します。SREワークブックのSLOアラートの章が推奨するのは、マルチウィンドウ・マルチバーンレートのアラートです。各アラートが答える問いは一つで、「誰かが確認する前にバジェットが尽きてしまうほどの速さで消費されているか」です。
30日ウィンドウの場合の基準値は次のとおりです。
| 重要度 | 長いウィンドウ | 短いウィンドウ | バーンレート | 発報時点で消費されたバジェット |
|---|---|---|---|---|
| ページ | 1時間 | 5分 | 14.4 | 2% |
| ページ | 6時間 | 30分 | 6 | 5% |
| チケット | 3日 | 6時間 | 1 | 10% |
長いウィンドウは有意性を担保し、1分間だけ悪化してもページは飛びません。長いウィンドウの12分の1にあたる短いウィンドウは、インシデント収束後にアラートを素早く解除させる役割を持ち、修正後も1時間ページが鳴り続ける事態を防ぎます。発報には両方の条件が同時に成立している必要があります。
1つ目のブロックでは、アラート式を軽量に保つために各ウィンドウのエラー率をレコーディングルールとして記録します。2つ目のブロックでは、バジェット比率が0.001となる99.9% SLOに対して、2つのページアラートを定義します。
# checkout-slo-recording.rules.yml
groups:
  - name: checkout-slo-recording
    interval: 30s
    rules:
      - record: slo:sli_error:ratio_rate5m
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[5m]))
          / sum(rate(http_requests_total{job="checkout-api"}[5m]))
      - record: slo:sli_error:ratio_rate1h
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[1h]))
          / sum(rate(http_requests_total{job="checkout-api"}[1h]))
# Same pattern for 30m and 6h, omitted for brevity# checkout-slo-alerts.rules.yml
groups:
- name: checkout-slo-alerts
rules:
- alert: CheckoutErrorBudgetFastBurn
# 2% of the monthly budget spent in one hour
expr: |
slo:sli_error:ratio_rate1h > (14.4 * 0.001)
and slo:sli_error:ratio_rate5m > (14.4 * 0.001)
labels:
severity: page
annotations:
summary: "checkout-api burns its error budget 14x too fast"
- alert: CheckoutErrorBudgetSlowBurn
# 5% of the monthly budget spent in six hours
expr: |
slo:sli_error:ratio_rate6h > (6 * 0.001)
and slo:sli_error:ratio_rate30m > (6 * 0.001)
labels:
severity: pageサービスごとにこれらのルールを手書きするのは手間がかかります。オープンソースのSLOジェネレーターであるSlothを使うと、短い仕様ファイルから上記のレコーディングルールとマルチバーンレートアラートが生成されます。{{.window}} プレースホルダーは、Slothが必要とする各ウィンドウに置き換えられます。
# checkout-slo.sloth.yml
version: "prometheus/v1"
service: "checkout-api"
labels:
  owner: "payments-team"
slos:
  - name: "requests-availability"
    objective: 99.9
    description: "Checkout requests that do not fail with a 5xx"
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="checkout-api",code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="checkout-api"}[{{.window}}]))
    alerting:
      name: CheckoutHighErrorRate
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
severity: ticket監視基盤に依存しない形式を求めるチームは、監視バックエンドとは独立してSLOをYAMLで記述できるOpenSLO仕様も検討対象になります。
エラーバジェットポリシーとリリース判断
ポリシーのないエラーバジェットは、誰も行動に移さないダッシュボードにすぎません。SREワークブックのエラーバジェットポリシーの例は、バジェットが尽きたときに何が起きるのか、そして誰が事前に承認したのかを明文化しています。
一般的なポリシーには次の項目が含まれます。
- 発動条件。 ローリングウィンドウ内でサービスがエラーバジェットを超過したこと。
- 結果。 サービスがSLOの範囲内に戻るまで、セキュリティ修正と信頼性向上のための変更を除き、機能リリースを停止すること。
- 例外の扱い。 チームの管理外にある依存サービスの障害による単発のインシデントは、判断を文書化したうえで除外できること。
- エスカレーション。 意見が対立した場合は、声の大きい人ではなく、CTOなどあらかじめ指名された役職が判断すること。
このポリシーは、最初の超過が起きる前にプロダクトとエンジニアリングの双方が署名しておくことに意味があります。そうすることで、リリース凍結はインシデント中の口論ではなく、事前に合意されたルールになります。面接官がよく尋ねるのは、バジェットがいつもほとんど消費されていない場合にどうするかという質問です。期待される回答は、SLOが緩すぎるか、チームが慎重すぎるリリースをしている可能性があり、そのバジェットはリリースの高速化やリスクの高い移行作業に使うべきだ、というものです。
社内SLOを顧客向けSLAと同じ値にすると、余裕がまったくなくなります。SLOを初めて割り込んだ瞬間に、すでに契約上のペナルティが発生しているからです。SLOはSLAより厳しく設定し、契約がまだ守られている段階でアラートが発報され、リリース凍結が始まるようにします。
トイル削減、オンコール、ブレームレスなポストモーテム
SREの業務時間は運用とエンジニアリングに分かれます。運用にはオンコール対応、チケット処理、手動介入が含まれ、エンジニアリングには自動化、キャパシティプランニング、信頼性向上のための機能開発が含まれます。トイルが50%の指針を超えた場合、SREチームは作業を開発チームに戻すか、自動化に投資します。そうしなければ、SREチームは名前を変えただけの運用チームになってしまいます。
オンコールの健全性は、推測ではなく測定によって評価します。有用な指標は、シフトあたりのページ数、対応が必要だったページの割合、確認(Ack)までの時間です。何の対応も必要としないページはアラート設定のバグであり、修正するか削除します。前述のルールのようにSLOのバーンレートに基づく症状ベースのアラートは、CPUやメモリ、個々のPodの再起動に対するアラートと比べて、ページの量を大きく減らします。
インシデントが発生した後のレビューについては、SRE本のポストモーテム文化の章が詳しく説明しています。ポストモーテムには、SLOの観点での影響(どれだけのバジェットを消費したか)、タイムライン、寄与要因、担当者と期限付きのアクションアイテムを記録します。特定の個人を原因として名指しすることは避けます。面接では2つの追加質問がよく出ます。1つは、アクションアイテムを確実に完了させる方法です(機能開発と同じバックログで管理し、定例ミーティングでレビューする)。もう1つは、ポストモーテムが必須となる条件です(バジェットの大きな割合を消費したインシデント、誰かを夜中に起こしたページ、データ損失が発生したケース)。
SRE本で紹介されている4つのゴールデンシグナル、すなわちレイテンシ、トラフィック、エラー、飽和度が監視の全体像を補完します。レイテンシとエラーは通常SLIになり、トラフィックと飽和度はページではなくキャパシティプランニングやダッシュボードに活用されます。
SRE面接でよく出る質問と模範回答
SREやシニアDevOpsの選考で繰り返し出題される質問と、評価される回答の要点をまとめます。SREの原則に関する面接モジュールでは同じテーマを繰り返し練習でき、オンコール側の内容はアラートとインシデント対応のモジュールで扱っています。
Q: SLI、SLO、SLAの違いは何ですか?
SLIは測定された比率、SLOはそれに対する一定期間の社内目標、SLAはペナルティを伴う外部との契約です。損失が発生する前にチームが対応できるよう、SLOはSLAより厳しく設定します。
Q: なぜSLOを100%にしないのですか?
あらゆる変更にはリスクが伴うため、100%の目標はリリースそのものを禁じることになります。また、ユーザーは自分のネットワーク以上の信頼性を知覚できません。100%との差がエラーバジェットであり、それがリリースの原資になります。
Q: 決済APIのSLOを定義してください。
評価の高い回答は、2つのSLI(4xxを除外した可用性と、ロードバランサーで測定した閾値以下のレイテンシ)、30日のローリングウィンドウ、直近四半期のデータに基づく目標値を選び、そこからアラートとエラーバジェットポリシーをどう導くかまで説明します。何を測定するのかを示さずに「稼働率99.99%」とだけ答えるのは、典型的な弱い回答です。
Q: p99レイテンシのパーセンタイルに対するアラートが、SLOアラートとして不適切なのはなぜですか?
短いウィンドウでのp99はノイズが多く、インスタンス間で集約することもできません。レイテンシを「閾値以下のリクエストの比率」に変換すれば加算可能になり、可用性SLIと比較でき、バーンレートアラートにも組み込めます。
Q: バーンレートとは何か、なぜアラートに2つのウィンドウを使うのか説明してください。
バーンレートは、観測されたエラー率をバジェット比率で割った値です。1であれば、バジェットはちょうどウィンドウの期間で尽きます。長いウィンドウは短いスパイクを除外し、短いウィンドウは復旧後にアラートを素早く解除させます。
Q: トイルとは何で、どのように抑制しますか?
手作業で繰り返し発生し、自動化可能で、永続的な価値を生まず、サービスの規模に比例して増える作業です。測定したうえで上限を設け(Googleは50%)、自動化するか、本来の担当チームに作業を戻すことで削減します。
Q: ポストモーテムをブレームレスにする要素は何ですか?
障害を許したシステムの条件に焦点を当て、関係者はその時点で得られた情報のもとで合理的に行動したと仮定し、追跡可能なアクションアイテムを生み出すことです。判断基準は、当事者のエンジニアが不安を感じることなくすべての詳細を共有できるかどうかです。
同じ面接の中で、SLOの質問に続いて監視に関する質問が出ることもよくあります。Prometheusの面接対策ガイドではPromQL、メトリクスの種類、カーディナリティを扱っており、より幅広い準備にはDevOpsのテクノロジーページに掲載されている全モジュールが役立ちます。
SLOとエラーバジェットの実践:押さえておくべきポイント
- 各SLIは良いイベントと有効なイベントの比率として定義し、データが許す限りユーザーに近い位置で測定する。多くのAPIでは4xxを失敗から除外する
- SLOは過去のデータと28日または30日のローリングウィンドウから決め、顧客向けSLAより常に厳しく保つ
- 目標値を時間またはリクエスト数のバジェットに換算し、主要な数値を暗記しておく。30日間で99.9%なら43分
- 生のエラー率やCPUではなく、ペアのウィンドウ(1時間と5分で14.4、6時間と30分で6)を使ったバーンレートでアラートを出す
- SLOを持つサービスが数個を超えたら、Slothなどのツールでルールを生成し、閾値の一貫性を保つ
- 最初の超過が起きる前に、凍結ルールとエスカレーション経路を含むエラーバジェットポリシーを作成し、署名しておく
- トイル、ページ数、ポストモーテムのアクションアイテムを、機能開発と同じ厳密さで追跡する
今すぐ練習を始めましょう!
面接シミュレーターと技術テストで知識をテストしましょう。
DevOps のバグを見つけられますか
実際のコード、隠れたバグ、1日1回。アカウントなしで試せます。

執筆
Anthony Fillion-MailletSharpSkill 創業者
10 年以上フルスタック開発に携わっています。SharpSkill を運営し、ここで公開される内容に責任を負っています。
2026年11月7日 更新
タグ
共有
関連記事

Prometheus面接質問 2026:Prometheus vs Grafana vs Datadogのモニタリング比較
DevOps・SRE職向けのPrometheus面接質問と回答。PromQL、メトリクスタイプ、カーディナリティ、高可用性に加え、Prometheus、Grafana、Datadogのアーキテクチャ、アラート、価格を比較します。
2026年フリーランスDevOpsエンジニアの案件事情:案件獲得方法、単価相場、面談対策
2026年のフリーランスDevOpsエンジニア市場を解説。案件の探し方、日当の相場、必要なスキル、面談準備のポイントまで、契約獲得に必要な情報を網羅。
2026年のDevOpsパイプラインセキュリティ:DevSecOpsのベストプラクティスと面接質問
DevSecOpsの重要な手法、CI/CDパイプラインの保護方法、2026年の技術面接で求められるセキュリティに関する知識を解説します。SAST、SCA、OIDCフェデレーション、コンテナセキュリティまで網羅的に紹介します。