RAGとLLM 2026年版:データサイエンス面接のための検索拡張生成完全ガイド
2026年のデータサイエンス面接向けRAG解説。ベクトルデータベース、チャンキング戦略、エンベディングモデル、エージェンティックRAG、Graph RAG、本番パイプラインアーキテクチャ、EU AI Actコンプライアンスを網羅。
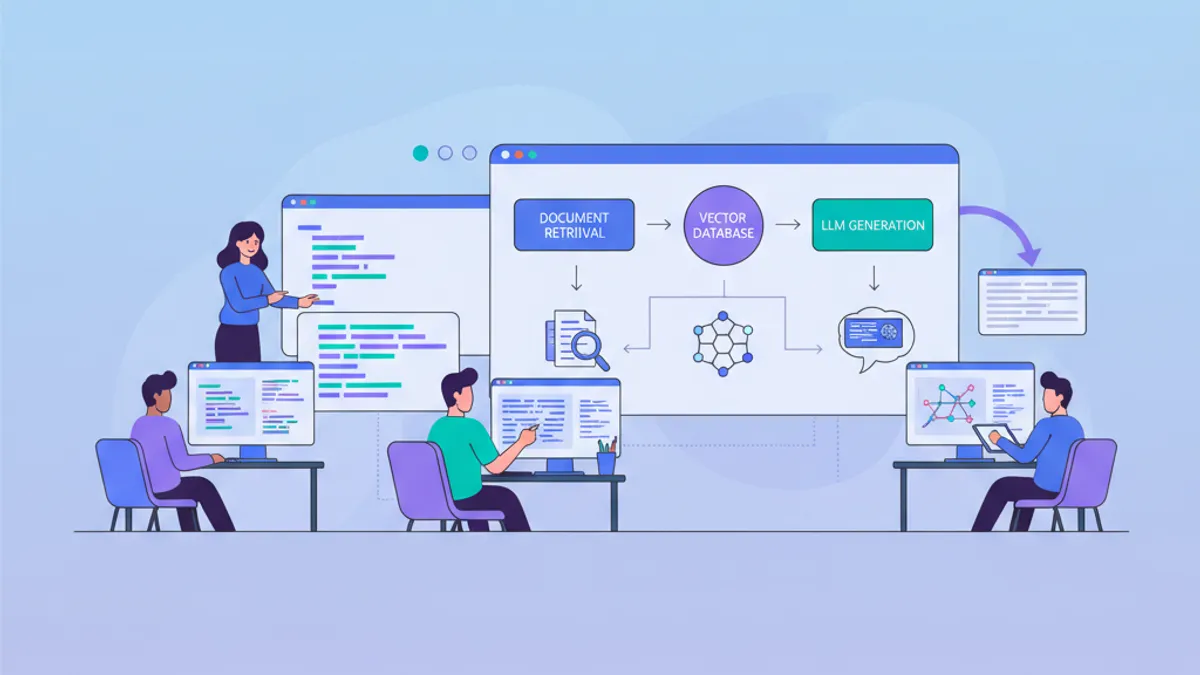
検索拡張生成(RAG: Retrieval-Augmented Generation)は、LLMの出力を事実に基づいた最新のデータで裏付けるための標準的なアーキテクチャとして定着しました。2026年のデータサイエンスおよびAIエンジニアリングの面接では、RAGに関する質問が従来のML(機械学習)トピックと並んで出題されるようになっており、システム設計力と実装スキルの両方が問われます。
検索拡張生成(RAG)は、検索システム(知識ベースに対するベクトル検索)とLLMジェネレーターを組み合わせることで、モデルが学習データの記憶に頼るのではなく、実際のドキュメントに基づいて回答を生成するアーキテクチャです。
RAGパイプラインのエンドツーエンド動作
RAGシステムは2つのフェーズで動作します。知識ベースを構築するオフラインインジェスチョンフェーズと、関連するコンテキストを取得して回答を生成するオンラインクエリフェーズです。
インジェスチョン時には、生のドキュメントがクリーニング、チャンキング、エンベディングの処理を経てベクトルデータベースに格納されます。推論時には、ユーザーのクエリが同じエンベディングパスを通り、最近傍探索によって最も関連性の高いチャンクが取得されます。これらのチャンクがLLMプロンプトの一部となり、生成される回答がソースマテリアルに基づくものとなります。
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
return chain.invoke(question).contentこのパイプラインはRAGの基本ループ(チャンク化、エンベディング、保存、検索、生成)をカバーしています。search_type="mmr"パラメータにより、取得されるチャンクが関連性と多様性の両方を持つことが保証され、コンテキストウィンドウ内の冗長性が削減されます。
検索品質を左右するチャンキング戦略
チャンキングは、他のどのコンポーネントよりも検索品質に大きな影響を与えます。不適切なチャンキングは、コンテキストが不足するフラグメントや、無関係な情報でシグナルが希釈されたフラグメントを検索結果として返す原因となります。
2026年の本番システムでは、3つのチャンキングアプローチが主流です。
固定サイズチャンキングは、設定されたトークン数(通常256〜512トークン)でテキストを分割し、オーバーラップを設けます。実装は単純ですが、文やアイデアの途中で分割してしまう欠点があります。
セマンティックチャンキングは、連続する文間のエンベディング類似度を測定してトピックの境界を検出します。類似度が閾値を下回った時点で新しいチャンクが開始されます。各チャンクはテキストの任意の断片ではなく、一貫したアイデアを保持します。
レイトチャンキングは、まずトランスフォーマーモデルをドキュメント全体に適用してコンテキスト付きトークンエンベディングを生成し、その後チャンクに分割します。これにより、従来のチャンキングが破壊する長距離依存関係が保持されます。
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
面接での重要なポイントは、チャンクサイズが精度と再現率のトレードオフであるという点です。小さなチャンク(100トークン)は検索精度を向上させますが、コンテキストが断片化されます。大きなチャンク(1000トークン)はコンテキストを保持しますが、エンベディングの特異性が希釈されます。多くの本番システムでは、10〜20%のオーバーラップを持つ256〜512トークンに落ち着いています。
本番環境におけるベクトルデータベースとエンベディングモデル
ベクトルデータベースはエンベディングを格納し、高速な近似最近傍(ANN)検索をサポートします。エンベディングモデルとベクトルデータベースの適切な組み合わせを選択することが、検索のレイテンシと精度に直接影響します。
2026年のエンベディングモデルは、いくつかの高性能オプションに集約されています。OpenAIのtext-embedding-3-large(3072次元)や、BAAIのbge-m3、Cohereのembed-v4などのオープンソース代替モデルが、強力な多言語検索性能を提供しています。MTEBリーダーボードは、エンベディング品質を比較するための標準ベンチマークとして引き続き利用されています。text-embedding-3-largeはMatryoshka表現学習をサポートしており、次元数を1024や256に削減しても品質低下が最小限に抑えられるため、ストレージコストを大幅に削減できます。
2026年のベクトルデータベース市場は集約が進んでいます。4つの製品が本番RAGワークロードの大部分を占めています。
| データベース | インデキシング | マネージド | 強み |
|---|---|---|---|
| Pinecone | 独自方式 | あり | ゼロ運用、組み込み推論、ハイブリッド検索 |
| Weaviate | HNSW | あり/セルフ | ネイティブBM25 + 密ベクトル融合を1クエリで実行 |
| Qdrant | HNSW | あり/セルフ | Rustによる高性能、ペイロードフィルタリング、最良の無料枠 |
| pgvector | IVF, HNSW | セルフ | 既存スタックへのPostgreSQL統合 |
面接での議論において重要なのは、HNSW(Hierarchical Navigable Small World)アルゴリズムの理解です。HNSWは多層グラフを構築し、各ノードが最近傍のノードに接続されることで、メモリ使用量の増加と引き換えにO(log n)の検索を実現します。
コストの転換点は月間6,000万〜8,000万クエリです。このしきい値を超えると、固定コストインフラ上でセルフホストするQdrantやWeaviateが、マネージドPinecone Serverlessよりも一貫して3〜10倍のコスト効率を発揮します。
Data Science & MLの面接対策はできていますか?
インタラクティブなシミュレーター、flashcards、技術テストで練習しましょう。
ハイブリッド検索:密ベクトルと疎ベクトルの組み合わせ
純粋なベクトル検索は、完全一致のキーワードマッチや稀なタームの検索に失敗します。一方、純粋なレキシカル検索(BM25)はセマンティックな類似性を見逃します。ハイブリッド検索はこの両方を組み合わせるアプローチであり、2026年の本番RAGシステムではデフォルトとなっています。
標準的なパターンでは、Reciprocal Rank Fusion(RRF)を使用して、両方のリトリーバーからのランキング結果を統合します。
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
ハイブリッド検索は「語彙のミスマッチ」問題を解決します。例えば、ユーザーが「サブスクリプションのキャンセル」について質問しているのに、関連ドキュメントでは「アカウント解約ポリシー」という表現が使われているケースです。BM25が完全一致のタームを捕捉する一方、ベクトル検索がセマンティックな関連性を捉えます。
リランキング:第二段階のフィルター
検索は候補を返し、リランキングはそれらを真の関連性でソートします。Cohere Rerankやbge-reranker-v2.5-gemma2-lightweightなどのクロスエンコーダーリランカーは、各クエリ-ドキュメントペアを同時にスコアリングし、バイエンコーダーの類似度よりもはるかに正確な関連性スコアを生成します。
2段階の検索パイプライン(広範な第1段階のリコールでベクトル + BM25により上位50〜100件の候補を取得、次に精密なリランキングでプロンプト用に上位5〜10件に絞り込み)は本番環境での標準です。第1段階が高速なANN検索を使用し、コストの高いクロスエンコーダーは少数の候補セットのみを処理するため、レイテンシを管理可能な範囲に抑えることができます。
クロスエンコーダーがバイエンコーダーよりも高精度である理由は、クエリとドキュメントをトランスフォーマーの全層で同時に処理するためです。バイエンコーダーはそれぞれを独立にエンベディングするため、細かな相互作用のシグナルが失われます。トレードオフは速度です。クロスエンコーダーは事前にインデックス化することができません。
アダプティブRAG:適切なパイプラインへのクエリルーティング
すべてのクエリが同じ検索の複雑さを必要とするわけではありません。アダプティブRAGは、小規模な分類器を訓練して各質問を最適なパスにルーティングします。
- 検索なし: モデルがすでに知っている単純な事実クエリに対して
- 単発検索: 中程度のクエリに対して
- マルチステップ反復検索: 複雑な推論に対して
このパターンは、混合ワークロード全体でコストと精度のバランスを取ります。1日10万件のクエリを処理する本番システムでは、単純な質問を高コストのマルチステップパイプラインから外すことで、推論コストを40%削減できます。
分類器自体は、小規模なファインチューニングモデルか、「この質問に正確に回答するには外部知識が必要か?」と尋ねるゼロショットプロンプトで実装できます。
投機的RAG:速度のためのレイテンシトレードオフ
投機的RAGは、高速なドラフト生成と並行して検索を実行します。ドラフトが高い確信度を示す場合(logprobで測定)、検索ステップは完全にスキップされます。確信度が低い場合は、取得したコンテキストがドラフトにマージされ、再生成が行われます。
このアプローチは、高確信度のクエリで平均レイテンシを30〜40%削減します。リアルタイムチャットボット、オートコンプリート提案、カスタマーサービスシステムなど、すべてのクエリで網羅的なソーシングよりも応答時間が重要な場面で効果を発揮します。
トレードオフとして、投機的RAGはモデルが過信している場合に、根拠なしに回答を返すことがあります。本番システムでは、確信度キャリブレーションと、不確実性が閾値を超えた場合の完全検索へのフォールバックを組み合わせて使用します。
エージェンティックRAG:単発検索を超えて
ナイーブなRAGは1回検索して生成するだけです。エージェンティックRAGは、LLMをいつ検索するか、何を検索するか、取得したコンテキストが十分かどうかを判断する推論エージェントとして扱います。
2026年では、複数ステップの推論を必要とする複雑なクエリに対して、エージェンティックRAGが支配的なパターンとなっています。エージェントは以下のことが可能です。
- 自己評価: 取得したドキュメントが質問に答えているかを評価
- 再クエリ: 初回の結果が不十分な場合に検索クエリを再構成
- ルーティング: 異なる知識ソース(ベクトルDB、SQLデータベース、API)から選択
- 検証: 複数の取得パッセージ間で事実をクロスチェック
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
このパターン(検索、評価、必要に応じてクエリを書き換えてリトライ)はCorrective RAG(CRAG)として知られています。LangChainのAgentExecutorは2026年時点で非推奨であり、新規プロジェクトでは組み込みパターン用にcreate_react_agent()を、カスタムオーケストレーション用にLangGraphのStateGraphを使用する必要があります。データサイエンティスト向けLangChainパターンについては、専用の記事で詳しく解説しています。
Graph RAG:構造化された知識検索
Graph RAGは、ドキュメントからエンティティと関係性を抽出してナレッジグラフを構築し、グラフとベクトルストアの両方にクエリを実行します。このアーキテクチャは、非構造化テキストの類似性ではなく、明示的なエンティティ間の関係に回答を基づけることで、事実に関するクエリでのハルシネーションを削減します。
インジェスチョンパイプラインは、各ドキュメントチャンクからトリプル(主語、述語、目的語)を抽出します。クエリ時には、質問内の関連エンティティを特定し、ナレッジグラフを走査して関連する事実を取得し、グラフ検索で得られたコンテキストとベクトル検索で得られたパッセージを組み合わせます。
Graph RAGは「ドキュメントXで言及されているフレームワークを使用しているプロジェクトを率いているチームはどれか?」のようなマルチホップ推論クエリに優れています。これは、複数のドキュメントにまたがる事実を結びつける必要があるクエリであり、単一のチャンクに完全な回答が含まれないため、純粋なベクトル検索では対応が困難です。
Graph RAGは事実精度を大幅に向上させますが(エンティティの多いクエリでハルシネーションを最大40%削減)、成熟したエンティティ抽出パイプラインを必要とします。ノイズの多い抽出はノイズの多いグラフを生成し、ナイーブRAGよりも結果が悪化する可能性があります。また、MicrosoftのGraphRAGプロジェクトは2026年にメンテナンスモードに入りました。バグ修正は継続されますが、新機能の追加はありません。
MicrosoftのLazyGraphRAGバリアント(2025年6月リリース)は、要約処理をクエリ時まで延期することでインデキシングコストを大幅に削減しており、事前のグラフ構築が現実的でない探索的分析やストリーミングデータに適しています。
EU AI Act:RAGシステムのコンプライアンス要件
EU AI Actは2026年8月から広く適用されています。同法に基づく初の高額罰金は2026年5月下旬に欧州の銀行コンソーシアムのRAGチャットボットに課され、2026年4月にはフランクフルトの資産運用会社が、データの出所を説明できない顧客向けRAGシステムにより450万ユーロの罰金を科されました。
RAGアーキテクチャは、いくつかのコンプライアンス要件を本質的に満たしています。ソースの追跡可能性(チャンクがドキュメント参照を保持)、回答の透明性(引用を表示可能)、監査可能性(検索ログが構造的に存在)です。ただし、完全なコンプライアンスには追加の対策が必要です。
リスク分類: 公開チャットボットは限定リスク(透明性が必要)に該当します。医療または法務のRAGシステムは、より厳格な文書化と監視義務を伴う高リスクに分類されます。
監査ログ: どの質問がどの検索チャンクをトリガーし、どの回答が生成されたかを記録します。このログが必要な追跡可能性の基盤となります。
人的監視: 高リスクシステムでは、センシティブなケースでの人的検証、出力を修正する機能、および要求に応じてインデックスされたデータを削除するメカニズムが必要です。
データレジデンシー: インデキシングをEU内でホストし、BYOK(Bring Your Own Key)を使用して、データが管轄外のサードパーティアカウントを経由しないようにします。
違反した場合、全世界年間売上高の7%の罰金が科される可能性があります。面接での議論において重要なのは、RAGが本質的に持つ引用機能は利点ですが、それだけではガバナンスレイヤーの代替にはならないという点です。
RAGシステムの評価:重要な指標
RAGの評価は、検索指標と生成指標に分けられます。障害の診断には、両方を独立に測定する必要があります。
検索指標:
- Recall@k: 関連するドキュメントが上位k件の結果に含まれていたか?
- MRR(Mean Reciprocal Rank): 最初の関連結果のランキングはどの程度高いか?
- NDCG: ランキングが理想的な関連性の順序と一致しているか?
生成指標:
- 忠実性(Faithfulness): 回答は取得されたコンテキストの情報のみを使用しているか?(ハルシネーションの測定)
- 回答関連性(Answer relevance): 回答は元の質問に対応しているか?
- コンテキスト精度(Context precision): 取得されたチャンクは実際に回答に使用されているか?
RagasやDeepEvalなどのフレームワークは、LLM-as-judgeパターンを使用してこれらの評価を自動化します。データサイエンス面接の頻出質問では、RAG評価設計がますます多く含まれるようになっており、RAGシステムが正しく機能しているかをどのように測定するかの説明が求められます。
本番環境での障害モードとデバッグ
RAGシステムは予測可能なパターンで障害を起こします。これらのパターンを知ることは、面接と実際のデプロイメントの両方に不可欠です。
コンテキストウィンドウの汚染は、取得されたチャンクが多すぎて関連するシグナルが希釈される場合に発生します。LLMは10個のチャンクを受け取りますが、有用な情報を含むのは2個だけです。解決策:リランカーを使用してフィルタリングし、リトリーバーのtop-kを削減します。
チャンキングアーティファクトは、固定サイズの分割が文、テーブル、コードブロックの途中で要素を分断する場合に発生します。取得されたチャンクは構文的に不完全でセマンティック的に無用です。セマンティックチャンキングまたはドキュメント構造を考慮した分割(ヘッダー、段落、コードフェンスの尊重)で解決できます。
エンベディングドリフトは、エンベディングモデルが更新されたにもかかわらず、ベクトルストアに古いモデルのエンベディングがまだ格納されている場合に発生します。新しいモデルでエンコードされたクエリが、古いモデルで構築されたベクトル空間を検索するため、検索品質が低下します。解決策:モデル変更後にコーパス全体を再エンベディングします。
陳腐化したインデックスは、インジェスチョンパイプラインがドキュメントの更新に遅れたため、古い情報を配信します。機械学習システムでは、これは学習-サービングスキューに類似しています。検索システムが、本番環境に存在するデータ分布とは異なるものを参照しているのです。
Sources
- Turing Post: 20 Advanced RAG Types to Know in 2026 - RAGパターンの包括的な分類
- LangChain and LangGraph 1.0 Milestones - AgentExecutorの非推奨化と新パターン
- Microsoft GraphRAG GitHub - メンテナンスモードのステータス
- IgnitionRAG EU AI Act Guide - RAGシステムのコンプライアンス要件
- MarkTechPost: Best Vector Databases in 2026 - 市場の集約と価格設定
今すぐ練習を始めましょう!
面接シミュレーターと技術テストで知識をテストしましょう。
データサイエンス面接におけるRAGの重要ポイント
- RAGは検索(知識ベースに対するベクトル検索)とLLM生成を組み合わせ、モデルの再学習なしに事実に基づいた回答を生成します
- チャンキング戦略が検索品質に最も大きな影響を与えます。セマンティックチャンキングとレイトチャンキングは、ほとんどのユースケースで固定サイズ分割を上回ります
- ハイブリッド検索(密ベクトル + 疎BM25)とReciprocal Rank Fusionは本番環境のデフォルトであり、純粋なベクトル検索では対処できない語彙のミスマッチ問題を解決します
- クロスエンコーダーリランカーは広範な検索の後に精度の層を追加し、少数の候補セットのみを処理してレイテンシを許容範囲に保ちます
- アダプティブRAGはクエリを適切なパイプライン複雑度にルーティングし、混合ワークロードでコストを40%削減します
- 投機的RAGは根拠のある回答と引き換えに速度を優先し、高確信度のクエリでレイテンシを30〜40%削減します
- エージェンティックRAG(検索、評価、書き換え、リトライ)とGraph RAG(エンティティ-関係性抽出)は、ナイーブRAGが失敗する複雑なマルチホップクエリを処理します
- EU AI Actコンプライアンス(2026年8月)により、本番RAGシステムには監査ログ、人的監視、リスク分類が必要です
- 評価は検索指標(Recall@k、MRR)と生成指標(忠実性、回答関連性)を分離して、パイプラインのどこで障害が発生しているかを診断する必要があります
- 最も一般的な本番環境の障害(コンテキスト汚染、チャンキングアーティファクト、エンベディングドリフト、陳腐化したインデックス)は、特定されれば全て簡単に修正できます
Data Science & ML のバグを見つけられますか
実際のコード、隠れたバグ、1日1回。アカウントなしで試せます。

執筆
Anthony Fillion-MailletSharpSkill 創業者
10 年以上フルスタック開発に携わっています。SharpSkill を運営し、ここで公開される内容に責任を負っています。
2026年8月24日 更新
タグ
共有
関連記事
2026年のMLOps: MLflow、モデルレジストリ、技術面接の質問
MLライフサイクル、MLflowによる実験追跡、モデルレジストリの昇格、デプロイパターン、ドリフト監視、システム設計を扱う2026年向けのMLOps面接質問。Pythonコードと回答例付きです。
機械学習アルゴリズム徹底解説:技術面接を突破するための完全ガイド
技術面接に必要な機械学習アルゴリズムを網羅的に解説。線形モデル、決定木、アンサンブル手法、クラスタリング、評価指標、正則化をscikit-learnのコード例とともに紹介します。
2026年版 データサイエンス面接の頻出質問25選
統計学、機械学習、特徴量エンジニアリング、ディープラーニング、システム設計に関するデータサイエンス面接の重要質問25問をPythonコード付きで詳しく解説。