Great Expectations 2026年版:データ品質検証とインタビュー対策
Great Expectations(GX)を使用したデータ品質検証の実践的なガイド。本番パイプラインでの実装方法からデータエンジニア面接での頻出質問まで、2026年の最新情報を網羅します。
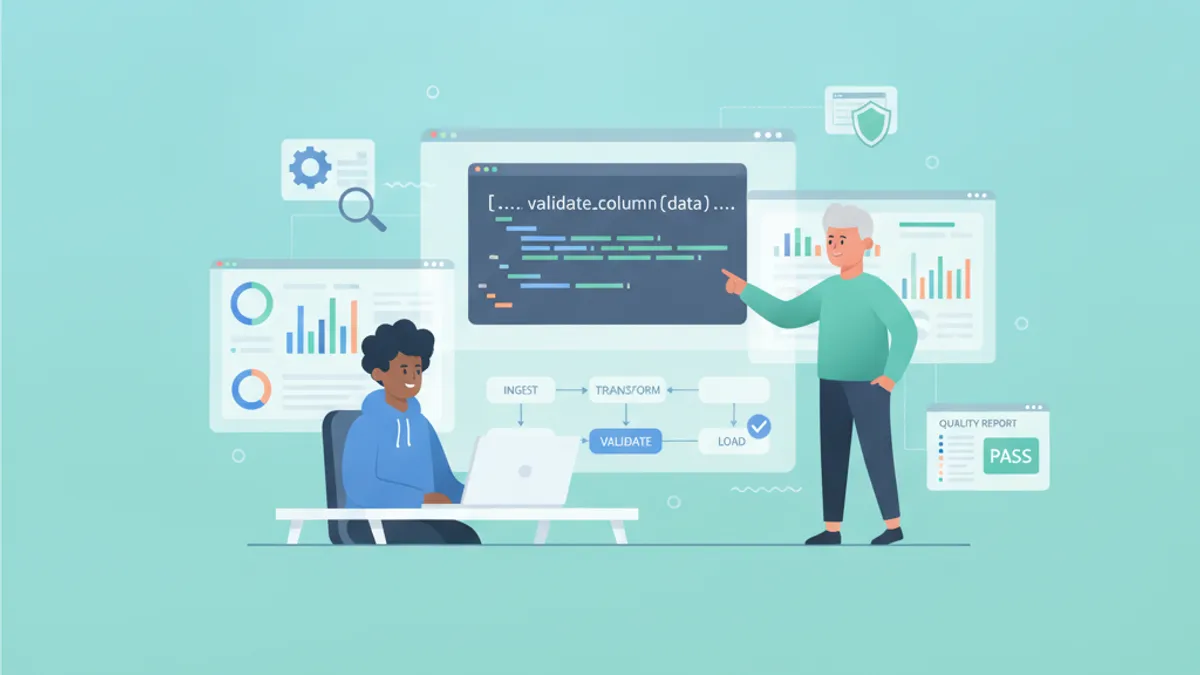
Great Expectations(GX)は、Pythonベースのデータパイプラインにおけるデータ品質検証の標準的なオープンソースフレームワークです。2026年8月にリリースされたバージョン1.22では、GX 1.0で導入されたAPIの変更が安定化し、実験的なPython 3.14サポートが追加されました。本番環境のパイプラインを構築するデータエンジニアにとって、不可欠なツールとなっています。
GX Coreは、GitHubで11,400以上のスターを獲得しているオープンソースライブラリ(Apache 2.0ライセンス)です。GX Cloudは、その上に構築されたマネージドSaaSプラットフォームで、コラボレーションツールとリアルタイム監視ダッシュボードを提供しています。本記事では、GX Coreに焦点を当てます。
Great Expectationsがデータパイプラインで解決する問題
データパイプラインは、多くの場合サイレントに障害を起こします。上流でのスキーマ変更、存在してはならないnull値、ISOからUnixタイムスタンプへの日付フォーマットの変更など、これらの問題は誰かが気づく前にダッシュボードやMLモデルに到達することがあります。Great Expectationsは、データをコードと同様に扱い、パイプラインのチェックポイントで自動的に実行されるアサーション(Expectationsと呼ばれる)を適用します。
このフレームワークは、Apache Airflow、Databricks、Snowflake、AWS S3やAzure Blob Storageなどのクラウドストレージサービスと統合できます。各検証では、非技術者のステークホルダーでも読めるHTMLレポートであるData Docsが生成されます。
コアコンセプト:Data Context、Data Sources、Expectations
GX 1.22は、Data Context、Data Sources、Data Assets、Expectation Suitesの4つのコンポーネントを中心に検証を構成しています。
Data Contextは、中央の設定オブジェクトです。Data Sources、Expectation Suites、Checkpoints、過去のValidation Resultsのメタデータを保存します。ほとんどのプロジェクトでは、単一のgx/ディレクトリにYAML設定ファイルと生成されたData Docsが格納されます。
Data Sourceは、データベース、データウェアハウス、またはファイルシステムへの接続を表します。Data Assetは、そのソース内のレコードの論理的なコレクションで、テーブルやクエリの結果セットに相当します。
# gx_setup.py
import great_expectations as gx

# 既存のData Contextを初期化またはロード
context = gx.get_context()

# ローカルファイル用のPandas Data Sourceを追加
data_source = context.data_sources.add_pandas("local_files")

# 特定のCSVパターンを指すData Assetを定義
data_asset = data_source.add_csv_asset(
    name="user_events",
    filepath_or_buffer="data/user_events_*.csv"  # Globパターン
)この設定により、GXはdata/ディレクトリ内のuser_events_*.csvに一致する任意のCSVを検証できます。
カラム検証用のExpectation Suiteの構築
Expectation Suiteは、Data Assetに対するアサーションのコレクションです。各Expectationは、データが満たすべき条件を宣言します。例えば、「カラムuser_idはnullであってはならない」や「カラムageは0から120の間の値を含むべき」などです。
# build_suite.py
import great_expectations as gx

context = gx.get_context()

# Expectation Suiteを作成または取得
suite = context.suites.add(
    gx.ExpectationSuite(name="user_events_suite")
)

# Suiteにexpectationsを追加
suite.add_expectation(
    gx.expectations.ExpectColumnToExist(column="user_id")
)
suite.add_expectation(
    gx.expectations.ExpectColumnValuesToNotBeNull(column="user_id")
)
suite.add_expectation(
    gx.expectations.ExpectColumnValuesToBeBetween(
        column="age",
        min_value=0,
        max_value=120
    )
)
suite.add_expectation(
    gx.expectations.ExpectColumnValuesToMatchRegex(
        column="email",
        regex=r"^[\w.-]+@[\w.-]+\.\w+$"
    )
)

# SuiteをData Contextに保存
context.suites.save(suite)
GX 1.0以降では、ExpectationsにクラスベースのAPIが使用されています。古い辞書ベースの構文(expect_column_to_exist)も引き続き使用可能ですが、クラスベースのアプローチは、より優れたIDEの自動補完と型安全性を提供します。
Checkpointsによる検証の実行
Checkpointは、Data Asset、Expectation Suite、および検証が成功または失敗したときにトリガーされるオプションのActionsを結び付けます。Checkpointsは、本番環境での自動検証の主要なエントリーポイントです。
# run_checkpoint.py
import great_expectations as gx

context = gx.get_context()

# Checkpointを作成
checkpoint = context.checkpoints.add(
    gx.Checkpoint(
        name="user_events_checkpoint",
        validation_definitions=[
            gx.ValidationDefinition(
                name="validate_user_events",
                data=context.data_sources.get("local_files")
                    .get_asset("user_events")
                    .build_batch_request(),
                suite=context.suites.get("user_events_suite")
            )
        ],
        actions=[
            gx.checkpoint.UpdateDataDocsAction(name="update_docs"),
        ]
    )
)

# Checkpointを実行
result = checkpoint.run()

# 全体の成功を確認
if result.success:
    print("すべての検証に成功しました")
else:
    print("検証の失敗が検出されました")
    for validation_result in result.run_results.values():
        for expectation_result in validation_result.results:
            if not expectation_result.success:
                print(f"  失敗: {expectation_result.expectation_config}")
Checkpointが実行されると、GXはバッチをロードし、各Expectationを適用し、Data Docsを更新します。検証が失敗した場合、設定されたActionsに応じて、Slack通知、PagerDutyアラート、またはパイプラインの終了をトリガーできます。
Data Engineeringの面接対策はできていますか?
インタラクティブなシミュレーター、flashcards、技術テストで練習しましょう。
Apache Airflow DAGsへのGXの統合
ほとんどの本番データパイプラインは、Apache Airflowのようなオーケストレーターを使用しています。GXは、Checkpoint実行をオペレーターでラップする公式のAirflow統合を提供しています。
# dags/user_events_pipeline.py
from airflow import DAG
from airflow.operators.python import PythonOperator
from datetime import datetime
import great_expectations as gx

def validate_user_events():
    """ユーザーイベントデータに対してGX Checkpointを実行します。"""
    context = gx.get_context(context_root_dir="/opt/airflow/gx")
    checkpoint = context.checkpoints.get("user_events_checkpoint")
    result = checkpoint.run()

    if not result.success:
        # Airflowタスクを失敗させるために例外を発生させる
        raise ValueError("データ検証に失敗しました。詳細はData Docsを確認してください。")

with DAG(
    dag_id="user_events_pipeline",
    start_date=datetime(2026, 1, 1),
    schedule_interval="@daily",
    catchup=False
) as dag:

    validate_task = PythonOperator(
        task_id="validate_user_events",
        python_callable=validate_user_events
    )

    # 下流のタスクは検証の成功に依存する
    # transform_task >> load_task
変換タスクの前に検証を配置することで、不正なデータが下流に伝播するのを防ぎます。このパターンは「シフトレフトテスティング」と呼ばれることもあり、高コストな計算ジョブが完了した後ではなく、取り込み時に問題を検出します。
Great Expectationsに関する面接の頻出質問
2026年のデータエンジニアリング面接では、データ品質ツールに関する質問が頻繁に含まれます。以下は、技術スクリーニングで出題される質問と、経験豊富な候補者とジュニアを区別する回答です。
「本番パイプラインでデータ品質チェックをどのように実装しますか?」
優れた回答は、検証を別のダッシュボードとしてではなく、パイプラインステージとして組み込むことに言及します。具体的には:
- 取り込み時のスキーマ検証により、構造的な問題(例えば、整数が期待される場所に文字列が表示される)を即座に検出します
- ビジネスロジック検証では、正の価格や日付範囲などのドメイン制約をチェックします
- 自動アラートにより、検証が失敗したときにオンコールエンジニアに通知し、サイレントなデータ破損を防止します
- dbtテストは変換レイヤーのチェックを処理し、GXは取り込みと出力の検証を処理します
「Expectation SuiteとCheckpointの違いは何ですか?」
Expectation Suiteには、アサーション自体が含まれています:存在すべきカラム、許容される値の範囲、一致すべき正規表現パターンなど。何をチェックするかを定義します。
Checkpointは、これらのチェックをいつ、どのように実行するかを定義します。特定のData Asset(検証するデータ)、Expectation Suite(適用するルール)、およびActions(検証後に何が起こるか)を接続します。
「環境によって異なるExpectationsをどのように処理しますか?」
本番データは、ステージングデータとは異なる特性を持つことがよくあります。2つのアプローチがあります:
-
パラメータ化されたExpectations:環境変数またはランタイムパラメータを使用してしきい値を調整します。例えば、
min_value=int(os.getenv("AGE_MIN", 0))。 -
複数のSuites:ステージングと本番用に別々のSuitesを維持します。ステージングでは、不完全なデータフローのテストのために、オプションフィールドでnullを許可する場合があります。
「スケジュールされたパイプラインでCheckpointが失敗した場合、何が起こりますか?」
Checkpointは、success=FalseのCheckpointResultを返します。パイプラインの動作は、オーケストレーターが失敗をどのように処理するかによって異なります:
- Airflowでは、例外を発生させるとタスクが失敗としてマークされ、下流のタスクがブロックされます
- Databricksでは、ノートブックはエラーステータスで終了できます
- Checkpointにアタッチされたアクションは、Slackメッセージの送信、Jiraチケットの作成、またはロールバック手順のトリガーが可能です
ドメイン固有の検証用カスタムExpectations
GXには300以上の組み込みExpectationsが含まれていますが、ドメイン固有のルールには、多くの場合カスタム実装が必要です。カスタムExpectationは基底クラスを拡張し、検証ロジックを実装します。
# custom_expectations/expect_valid_iso_country_code.py
from great_expectations.expectations import Expectation
from great_expectations.core import ExpectationConfiguration
import pycountry

class ExpectValidISOCountryCode(Expectation):
    """有効なISO 3166-1 alpha-2国コードを検証します。"""

    column: str

    def _validate(
        self,
        metrics: dict,
        runtime_configuration: dict = None,
        execution_engine = None
    ):
        column_values = metrics.get("column_values.value_set")

        invalid_codes = []
        for code in column_values:
            if code is not None:
                try:
                    pycountry.countries.get(alpha_2=code.upper())
                except KeyError:
                    invalid_codes.append(code)

        success = len(invalid_codes) == 0
        return {
            "success": success,
            "result": {
                "observed_value": f"{len(invalid_codes)} invalid codes",
                "invalid_codes": invalid_codes[:10]  # 最初の10件を表示
            }
        }
カスタムExpectationsは、Data Contextに登録して組み込みのExpectationsと同様に使用できます。これにより、金融取引ID形式や医療記録識別子などのビジネス固有の検証が可能になります。
データウェアハウスへの接続:Snowflakeの例
GXは、様々なSQLデータウェアハウスに直接接続できます。以下は、Snowflakeを使用した例です。
# snowflake_validation.py
import great_expectations as gx

context = gx.get_context()

# Snowflake Data Sourceを追加
snowflake_source = context.data_sources.add_snowflake(
    "snowflake_warehouse",
    connection_string=(
        "snowflake://user:password@account/"
        "database/schema?warehouse=compute_wh"
    )
)

# クエリベースのData Assetを追加
orders_asset = snowflake_source.add_query_asset(
    name="recent_orders",
    query="SELECT * FROM orders WHERE order_date >= CURRENT_DATE - 7"
)

# このアセットに対してExpectationを適用
suite = context.suites.get("orders_suite")
validation_definition = gx.ValidationDefinition(
    name="validate_recent_orders",
    data=orders_asset.build_batch_request(),
    suite=suite
)

result = validation_definition.run()
クエリベースのData Assetsにより、テーブル全体ではなく関連するデータのみを検証できます。これは、大規模なファクトテーブルでの検証コストを削減するために重要です。
テスト環境でのGXのセットアップ
CI/CDパイプラインでGX検証を実行するには、テスト環境の適切な設定が必要です。
# .github/workflows/data-validation.yml
name: Data Validation

on:
  push:
    branches: [main]
  schedule:
    - cron: '0 */6 * * *'  # 6時間ごと

jobs:
  validate:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - name: Set up Python
        uses: actions/setup-python@v5
        with:
          python-version: '3.12'

      - name: Install dependencies
        run: |
          pip install great-expectations[snowflake]==1.22.0

      - name: Run GX Checkpoints
        env:
          SNOWFLAKE_PASSWORD: ${{ secrets.SNOWFLAKE_PASSWORD }}
        run: |
          python scripts/run_all_checkpoints.py

      - name: Upload Data Docs
        uses: actions/upload-artifact@v4
        with:
          name: data-docs
          path: gx/uncommitted/data_docs/
まとめ
Great Expectationsは、データパイプラインに品質検証を組み込むための成熟したフレームワークです。2026年においても、その重要性は変わりません。Expectation Suites、Checkpoints、Data Contextの概念を理解し、Airflowなどのオーケストレーターとの統合方法を習得することで、データエンジニアリング面接での優位性を確保できます。
面接では、検証を独立したプロセスとしてではなく、パイプラインの一部として組み込むことの重要性を強調することが重要です。シフトレフトテスティングのアプローチにより、下流でのデータ品質問題を最小限に抑え、信頼性の高いデータ基盤を構築できます。
Data Engineering のバグを見つけられますか
実際のコード、隠れたバグ、1日1回。アカウントなしで試せます。

執筆
Anthony Fillion-MailletSharpSkill 創業者
10 年以上フルスタック開発に携わっています。SharpSkill を運営し、ここで公開される内容に責任を負っています。
2026年9月13日 更新
タグ
共有
関連記事
2026年版 Delta Lake vs Apache Iceberg:レイクハウスアーキテクチャと面接対策
Delta LakeとApache Icebergの技術的差異を詳細に解説します。パーティション進化、ACID トランザクション、クエリエンジン互換性などのレイクハウス面接頻出トピックを網羅的にカバーします。

dbt 2026年版ガイド:データ変換、テスト戦略、面接対策の完全解説
dbtを使ったデータ変換の基礎から実践まで、レイヤードモデリング、インクリメンタル戦略、テスト手法、そして2026年のデータエンジニアリング面接で頻出する質問をコード例とともに解説する。
Apache Spark 4 完全ガイド 2026年版:新機能、Structured Streaming、面接対策
Apache Spark 4の主要な新機能を詳しく解説します。ANSI SQLモード、VARIANT型、リアルタイムストリーミング、Spark Connectなど、データエンジニアリング面接で頻出のトピックを網羅的にカバーしています。