ETL vs ELT 2026年版:データパイプラインアーキテクチャの徹底解説と面接対策
ETLとELTの違い、アーキテクチャ、ユースケース、最新ツール、データエンジニア面接での頻出質問について解説します。
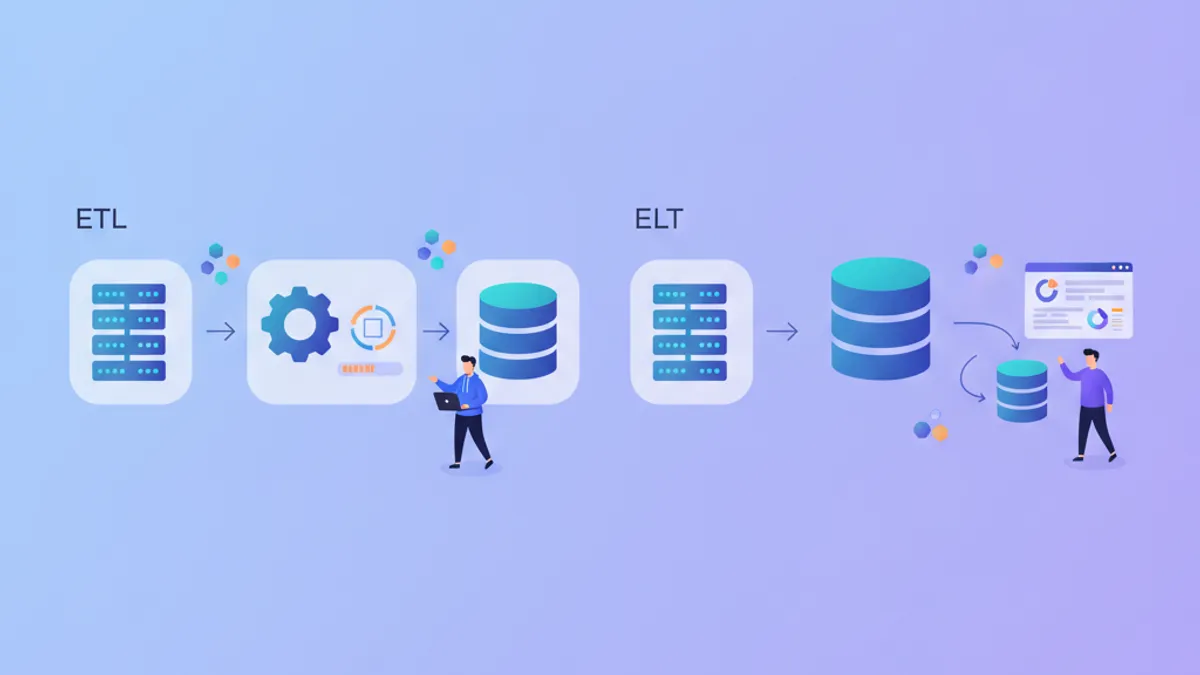
ETL vs ELTは、ソースシステムから分析環境へデータを移動する方法を定義します。抽出・変換・ロード(ETL)と抽出・ロード・変換(ELT)のどちらを選択するかは、インフラコスト、データの鮮度、エンジニアリングチームに求められるスキルに影響を与えます。
ETLはターゲットシステムにロードする前にデータを変換するため、専用のコンピュートリソースが必要です。ELTは生データを先にロードし、その後、宛先ウェアハウスの処理能力を使用して変換を行います。2026年においてクラウドネイティブなデータスタックの多くがELTを採用する理由は、コンピュートがオンデマンドでスケールするためです。
ETLアーキテクチャ:ロード前に変換する
ETLは、データウェアハウスのコンピュート容量が限られており、ストレージが高価だった時代に登場しました。このパターンは理にかなっていました。ウェアハウスの外部でデータをフィルタリングおよび集計し、分析に必要なものだけをロードするという考え方です。Oracle Warehouse Builder、Informatica PowerCenter、Talendがこのモデルに基づいたツールを構築しました。
ETLの変換ステージは中間サーバー上で実行されます。データはソースからステージングエリアに移動し、クレンジングと整形が行われた後、宛先にロードされます。このアプローチはウェアハウスの負荷を軽減しますが、変換レイヤーにボトルネックを生み出します。
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
ETLは、変換ロジックが安定しており、データ量が予測可能な場合にうまく機能します。欠点は要件が変更されたときに現れます。変換を修正するということは、履歴データを最初から再処理することを意味します。
ELTアーキテクチャ:先にロードし、ウェアハウス内で変換する
ELTは変換をデータウェアハウス内に移行します。Snowflake、BigQuery、Databricks、Redshiftは、クエリの複雑さに応じてスケールするほぼ無制限のコンピュートを提供します。生データを先にロードすることでソースの状態が保持され、変換はバージョン管理され、再抽出なしで再実行可能なSQLモデルになります。
dbt(data build tool)プロジェクトは、SQL変換をコードとして扱うことでELTを普及させました。ブラックボックスのETLジョブの代わりに、変換は生のテーブルを参照し、派生モデルを構築するSELECT文としてバージョン管理されます。
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggELTは生データを保持するため、ビジネスロジックが変更された場合の再処理が可能になります。6か月前の計算が間違っていた場合、dbtモデルを修正してフルリフレッシュを実行することで履歴データを修正できます。ETLの場合、同じ修正を行うには、元のレコードがもう存在しない可能性のあるソースから再抽出する必要があります。
比較表:ETL vs ELTのトレードオフ
| 要素 | ETL | ELT |
|---|---|---|
| コンピュート場所 | 専用変換サーバー | 宛先ウェアハウス |
| 生データ保持 | 変換後に破棄されることが多い | ランディングゾーンに保持 |
| 再処理コスト | ソースから再抽出 | SQLモデルを再実行 |
| スキーマ柔軟性 | 変換時に固定 | スキーマオンリードが可能 |
| ツール例 | Informatica、Talend、SSIS | dbt、Dataform、SQLMesh |
| 適した場面 | 安定した要件、レガシーシステム | 変化する要件、クラウドウェアハウス |
| レイテンシ | 高い(ロード前に変換) | 低い(ロード後に変換) |
| データガバナンス | 容易(ウェアハウス前にフィルタリング) | ウェアハウスレベルの制御が必要 |
Data Engineeringの面接対策はできていますか?
インタラクティブなシミュレーター、flashcards、技術テストで練習しましょう。
ハイブリッドアプローチ:ETLとELTの組み合わせ
現代のデータスタックは純粋なETLまたはELTを使用することは稀です。Apache Airflowは両方のパターンを組み合わせたパイプラインをオーケストレーションします。機密データはロード前に匿名化(ETLステップ)され、集計はウェアハウス内で実行(ELT)されることがあります。
FivetranやAirbyteは変換なしで生データを抽出してロードし、その後dbtがウェアハウス内で変換を行います。しかし、これらのツールは抽出時に軽量な変換もサポートしています:カラム選択、データ型の変換、PIIフィールドのハッシュ化などです。これがETL/ELTの境界を曖昧にしています。
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
上記のパイプラインはAirbyteでSalesforceから抽出し(同期中にメールアドレスをハッシュ化可能)、Snowflakeにロードし、その後ビジネス変換のためにdbtモデルを実行します。純粋なETLでも純粋なELTでもありませんが、実用的なアプローチです。
面接質問:データエンジニア向けETL vs ELT
現代のデータスタックを使用する企業のデータエンジニアリング職の技術面接では、パイプラインアーキテクチャの理解を探ります。ETL/ELT面接対策モジュールのパターンに基づき、これらの質問が頻繁に出題されます。
質問1:ELTよりETLを選択するのはどのような場合ですか?
優れた回答は具体的なシナリオを特定します:
- コンプライアンス要件:GDPRやHIPAAにより、特定のデータは生の形式でウェアハウスに到達してはならないと義務付けられています。PIIはロード前に匿名化または削除する必要があります。
- レガシーウェアハウスの制約:固定コンピュートを持つTeradataや古いRedshift構成などのオンプレミスシステムは、事前集計されたロードの恩恵を受けます。
- ネットワークコスト:毎日10TBをクラウドウェアハウスにロードし、変換後に90%を破棄するのは、エグレス帯域幅の無駄です。事前フィルタリングは経済的に合理的です。
弱い回答は「ETLは時代遅れ」と言ったり、具体的なシナリオを提示できなかったりします。面接官はニュアンスを求めています。
質問2:ELTパイプラインでスキーマ変更をどのように処理しますか?
これは生データランディングゾーンの理解をテストします。期待されるトピック:
- スキーママイグレーションなしで新しいフィールドを吸収するJSONまたは半構造化カラム
- カラムを明示的に選択し、下流モデルをソース変更から分離するステージングモデル
- 期待されるカラムが消失した場合にビルドを失敗させるdbtマクロまたはDataformアサーション
- Monte CarloやGreat Expectationsなどのツールを使用したスキーマドリフトの監視
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
質問3:AirflowでのETLオーケストレーションとdbtでのELT実行を比較してください
この質問は、これらのツールが異なる問題を解決することの理解を探ります:
- Airflowはタスクをオーケストレーションします:抽出、API呼び出し、ファイル転送、モデル訓練。異種ジョブ間の依存関係を管理します。
- dbtはウェアハウス内でデータを変換します。SQLモデル間の依存関係を管理し、テストを実行し、ドキュメントを生成します。
完全なパイプラインは両方を使用することが多いです:AirflowがAirbyte同期をトリガーし、完了を待ち、その後dbt実行をトリガーします。どのツールをいつ使用するかを知っていることが、シニア候補者を区別します。
質問4:ELTパイプラインが毎日5億行を処理し、アナリストがクエリの遅延を報告しています
このオープンエンドの質問は診断的思考をテストします:
- モデルのマテリアライゼーションを確認:重いモデルがまだビューですか?インクリメンタルモデルやテーブルが役立つかもしれません。
- パーティションとクラスタ:BigQueryの場合、ファクトテーブルは日付でパーティション化されていますか?Snowflakeの場合、一般的なクエリパターンに最適化されたクラスタリングですか?
- クエリプッシュダウン:アナリストは事前集計されたマートではなくステージングモデルをクエリしていますか?
- ウェアハウスサイズ:クエリ時間中にコンピュートは適切にスケールされていますか?
- 鮮度要件:変換を営業時間中ではなく夜間に実行できますか?
単一の正解はありません。面接官は体系的なトラブルシューティングを評価します。
2026年のツールランドスケープ
データ統合市場はいくつかのパターンに集約されています:
抽出とロード:Fivetran、Airbyte、Stitch、Meltanoは EL部分を処理します。これらのツールは数百のソースに接続し、カスタムコードなしでクラウドウェアハウスに同期します。
変換:dbtがSQLベースの変換を支配しています。代替としてDataform(現在Google Cloudの一部)、SQLMesh(仮想データ環境を持つオープンソース)、Coalesce(ビジュアルモデリング)があります。
オーケストレーション:Airflowは複雑なパイプラインのデフォルトとして残っています。DagsterとPrefectは、より良いローカル開発とアセット中心のビューを提供する代替手段です。
品質:Great Expectations、dbtテスト、Monte Carlo、Sodaがデータ品質監視を提供します。これらは抽出から下流消費までの間の問題を検出します。
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
今すぐ練習を始めましょう!
面接シミュレーターと技術テストで知識をテストしましょう。
新規プロジェクトのパイプラインアーキテクチャ選択
2026年のほとんどのグリーンフィールドプロジェクトでは、ELTがデフォルトです。クラウドウェアハウスのコンピュートは変換サーバーの維持よりも低コストです。生データの保持により遡及的な修正が可能になります。SQLベースの変換は監査可能でバージョン管理されています。
ETLが依然として有効な場面:
- ウェアハウス入力前のデータ最小化を要求する規制環境
- 取り込み時に変換が必要なリアルタイムストリーミング(Kafka Streams、Flink)
- 下流ストレージが限られたエッジコンピューティングシナリオ
- ソースシステムがエクスポート形式を制御するレガシー統合
面接に対応できる回答は、両方のパターンを認識し、イデオロギー的な偏りなしにトレードオフを説明します。
データパイプラインアーキテクチャの重要ポイント
- ETLはロード前にデータを変換し、ウェアハウスの負荷を軽減しますが、ロジック変更時に再処理の摩擦を生み出します
- ELTは生データを先にロードし、履歴データに対してバージョン管理、テスト、再実行可能なSQLベースの変換を可能にします
- 現代のスタックは通常、両方を組み合わせます:軽量な抽出変換(PIIハッシュ化、型変換)とウェアハウスベースの集計
- dbtはELT変換の標準となり、SQLモデルをテスト可能でドキュメント化されたコードとして扱います
- 面接質問は、定型的な定義ではなく、シナリオ選択、スキーマ進化処理、ツールのトレードオフを探ります
- ELTパイプラインでの生データ保持により、ソースから再抽出することなく履歴計算を修正できます
Data Engineering のバグを見つけられますか
実際のコード、隠れたバグ、1日1回。アカウントなしで試せます。
執筆
Anthony Fillion-MailletSharpSkill 創業者
10 年以上フルスタック開発に携わっています。SharpSkill を運営し、ここで公開される内容に責任を負っています。
2026年9月14日 更新
タグ
共有
関連記事
2026年ETL vs ELT徹底比較:データパイプラインアーキテクチャの選び方
ETL vs ELTの違いを2026年最新情報で解説。Snowflake、BigQuery、dbtを活用した現代的なデータパイプライン設計のベストプラクティスと選定基準を詳しく紹介します。
Apache Flink 2026完全ガイド:ストリーム処理、イベント時間、面接対策
Apache Flink 2.3のストリーム処理アーキテクチャ、イベント時間セマンティクス、ウィンドウ処理、状態管理を解説。データエンジニアリング面接で頻出する質問と回答も網羅。

dbt 2026年版ガイド:データ変換、テスト戦略、面接対策の完全解説
dbtを使ったデータ変換の基礎から実践まで、レイヤードモデリング、インクリメンタル戦略、テスト手法、そして2026年のデータエンジニアリング面接で頻出する質問をコード例とともに解説する。