2026年版Excel Power Queryガイド:データアナリストのためのETL手法と面接対策
Excel Power Queryを使用したETLワークフローの完全ガイド。M言語の基礎、データ変換テクニック、クエリ折りたたみ、データアナリスト面接でよく出題される質問を解説します。
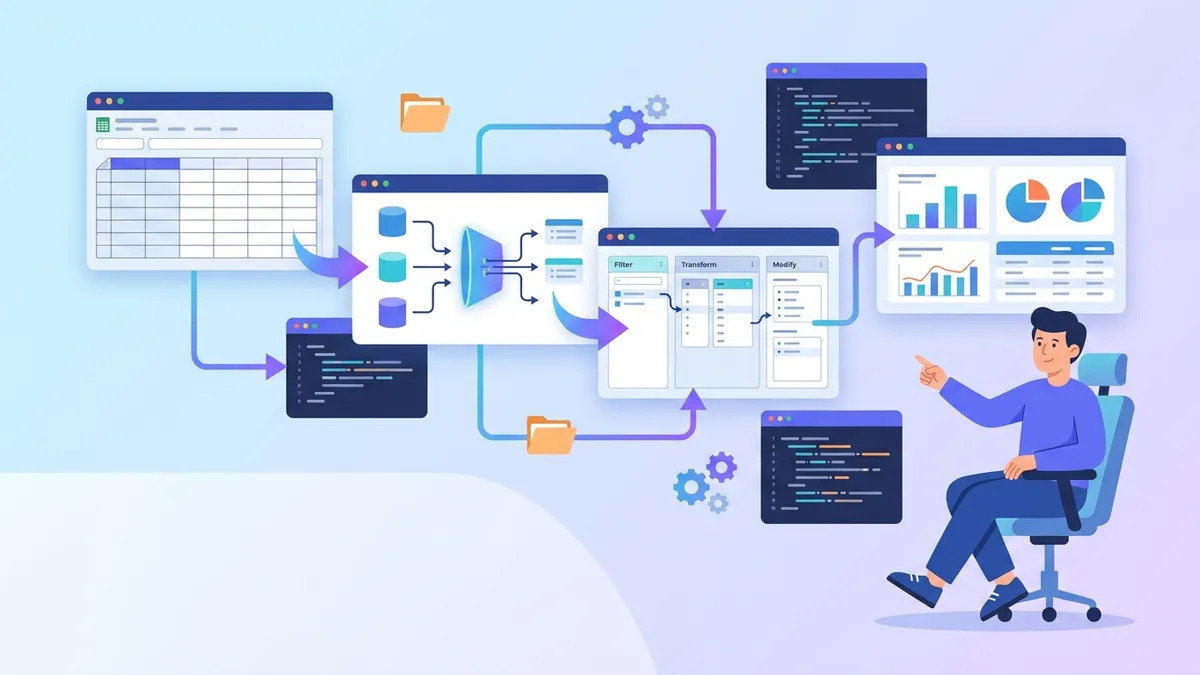
Excel Power Queryは、データアナリストがExcel内で直接ETL(Extract、Transform、Load)ワークフローを実行する方法を根本的に変革します。手動でのコピー&ペーストや複雑なVBAマクロとは異なり、Power QueryはM言語に基づいたビジュアルインターフェースを提供し、ワンクリックで更新可能な繰り返し可能なデータ変換を実現します。
Power QueryはExcel 365、Excel 2021、Excel 2019、Excel 2016に標準搭載されています。それ以前のバージョンでは、「Power Query for Excel」という無料アドインとして提供されていました。同じエンジンがPower BI Desktopのデータフローにも使用されています。
Power Queryがデータアナリストの課題を解決する理由
データアナリストは、データ準備に多大な時間を費やします。異なるソースからのファイル結合、一貫性のない形式のクリーニング、不要な行のフィルタリング、分析用のテーブル再構成などです。Power Queryは、各変換ステップを記録するクエリエディターを通じてこれらのタスクに対応します。ソースデータが変更されると、パイプライン全体が自動的に再実行されます。
ワークフローは3つの段階に分かれます:データソースへの接続、変換の適用、Excelテーブルまたはデータモデルへの結果の読み込みです。各ステップはM言語構文を使用した数式バーに記録され、高度なシナリオでは直接編集が可能です。
このアプローチは従来のExcel数式とは異なります。数式がセルを再計算するのに対し、Power Queryはワークシートに到達する前のテーブル全体に対して操作を行います。50個のCSVファイルを統合し、重複を削除し、列をアンピボットするクエリは一度実行され、クリーンなテーブルを生成します。ワークブックを遅くするような複雑なネストされた数式を構築する必要はありません。
データの取得によるデータソースへの接続
Power Queryは、ファイル(CSV、Excel、JSON、XML)、データベース(SQL Server、MySQL、PostgreSQL、Oracle)、クラウドサービス(SharePoint、Azure、Salesforce)、Webページへの接続をサポートします。接続タイプによって、表示される認証とインポートのオプションが決まります。
// Power Queryの主なデータソース
データ > データの取得 > ファイルから > CSVから
データ > データの取得 > データベースから > SQL Serverデータベースから
データ > データの取得 > その他のソースから > Webから
データ > データの取得 > フォルダーから(複数ファイル)
「フォルダーから」オプションは、複数ファイルの統合に特に便利です。各ファイルを個別にインポートする代わりに、Power Queryがフォルダーをスキャンし、一致するすべてのファイルをリストアップして、単一のクエリに結合します。フォルダーに新しいファイルを追加すると、次回の更新時に自動的に含まれます。
SQLデータベースに接続する場合、Power Queryはクエリ折りたたみを通じて変換ロジックをサーバーにプッシュできます。フィルターと列の選択はSQLのWHERE句とSELECT句に変換され、Excelに転送されるデータ量が削減されます。折りたたみがアクティブな場合、数式バーに「ネイティブクエリを表示」オプションが表示されます。
クエリエディターでのコア変換
クエリエディターは一般的な操作のためのリボンコマンドを提供しますが、カスタマイズが必要な場合は基礎となるMコードの理解が役立ちます。各変換は「適用したステップ」ペインにステップを追加し、監査可能なシーケンスを作成します。
行のフィルタリングと並べ替え
フィルタリングは条件を満たさない行を削除します。列ヘッダーのドロップダウンでクイックフィルターが提供され、「行のフィルター」ダイアログではAND/ORロジックを使用した複雑な条件がサポートされます。
// M言語でのFilteredRowsステップ
let
    Source = Excel.CurrentWorkbook(){[Name="SalesData"]}[Content],
    FilteredRows = Table.SelectRows(Source, each [Region] = "EMEA" and [Amount] > 1000)
in
FilteredRowsTable.SelectRows関数はテーブルと条件を受け取ります。eachキーワードは関数を作成し、_が現在の行を表し、フィールドアクセスはブラケット記法[Region]を使用します。複数の条件はandまたはor演算子で結合されます。
列の削除と名前変更
データソースには分析に不要な列が含まれていることがよくあります。早期に削除することでメモリ使用量を削減し、後続のステップを簡素化できます。
// 列を削除し、残りの列の名前を変更
let
    Source = Excel.CurrentWorkbook(){[Name="RawData"]}[Content],
    RemovedColumns = Table.RemoveColumns(Source, {"TempID", "InternalNotes", "Debug"}),
    RenamedColumns = Table.RenameColumns(RemovedColumns, {{"Cust_Name", "CustomerName"}, {"Amt", "Amount"}})
in
RenamedColumns列リストは複数のアイテムに対して波括弧{}を使用します。名前変更はペアのリストを取り、各ペアには古い名前と新しい名前が含まれます。クエリ間で一貫した命名規則を使用すると、データセットの結合が容易になります。
列の分割と結合
テキスト列は頻繁に解析が必要です。「FullName」列を名と姓に分割する必要があったり、別々の日付と時刻の列を結合する必要があったりします。
// 区切り文字でFullNameを2つの列に分割
let
    Source = Excel.CurrentWorkbook(){[Name="Contacts"]}[Content],
    SplitColumn = Table.SplitColumn(Source, "FullName", Splitter.SplitTextByDelimiter(" ", QuoteStyle.Csv), {"FirstName", "LastName"})
in
SplitColumnSplitter.SplitTextByDelimiter関数が解析ロジックを処理します。より複雑なパターンには、Splitter.SplitTextByEachDelimiterやSplitter.SplitTextByPositionsが追加の制御を提供します。結果の列数が変動する場合、Power Queryは動的に列を作成します。
型変換とデータ品質
Power Queryはインポート時に列の型を推測しますが、明示的な型割り当てによりエラーを早期に検出できます。先頭ゼロが重要な場合、数値IDを含むテキスト列はテキストのままにする必要があります。テキストとしてインポートされた日付列はソートの問題を引き起こします。
// 明示的な型割り当て
let
    Source = Csv.Document(File.Contents("C:\Data\transactions.csv")),
    TypedColumns = Table.TransformColumnTypes(Source, {
        {"TransactionID", type text},
        {"Date", type date},
        {"Amount", type number},
        {"IsProcessed", type logical}
    })
in
TypedColumnstypeキーワードがターゲット型を指定します。利用可能な型にはtext、number、date、datetime、datetimezone、time、duration、logical、binaryがあります。型エラーはセル内で「Error」値として表示され、分析前にデータ品質の問題が可視化されます。
Null値の処理には明示的なロジックが必要です。Table.ReplaceValue関数はnullをデフォルト値に置換し、Table.SelectRowsで[Column] <> nullを使用するとnullをフィルタリングできます。
グループ化と集計
カテゴリ別のデータ集計は頻繁に求められる要件です。「グループ化」変換は、同じキー値を共有する行を折りたたみ、集計関数を適用します。
// 地域と年ごとに売上をグループ化し、合計とカウントを計算
let
    Source = Excel.CurrentWorkbook(){[Name="Sales"]}[Content],
    Grouped = Table.Group(Source, {"Region", "Year"}, {
        {"TotalSales", each List.Sum([Amount]), type number},
        {"OrderCount", each Table.RowCount(_), Int64.Type},
        {"AvgOrderValue", each List.Average([Amount]), type number}
    })
in
Groupedグループ化列が最初に表示され、その後に集計定義が続きます。各集計は新しい列名、集計関数、およびオプションの結果型を指定します。eachキーワードは各グループのサブテーブルを表し、任意のテーブルまたはリスト関数を使用できます。
ネストされた集計により、後続のステップで行の値とグループの集計の両方を参照することで、「グループ合計に対する割合」などの計算が可能になります。
Data Analyticsの面接対策はできていますか?
インタラクティブなシミュレーター、flashcards、技術テストで練習しましょう。
ピボットとアンピボットによるデータ再構成
ピボットは行の値を列に変換し、クロスタブレイアウトを作成します。アンピボットはその逆を行い、正規化された構造のために列を行に変換します。
// 月の列を行にアンピボット
let
    Source = Excel.CurrentWorkbook(){[Name="MonthlySales"]}[Content],
    // 元の構造: Product, Jan, Feb, Mar, Apr 列
    Unpivoted = Table.UnpivotOtherColumns(Source, {"Product"}, "Month", "Sales")
    // 結果: Product, Month, Sales 列
in
UnpivotedTable.UnpivotOtherColumns関数は指定された列を固定し、残りをアンピボットします。これはすべての列を列挙してアンピボットするよりも安全です。新しい月の列を追加すると自動的に含まれるからです。末尾の2つのパラメータは属性列("Month")と値列("Sales")の名前を指定します。
ピボットは、同じ行列の組み合わせに複数の値が存在する場合に集計関数を使用したTable.Pivotを使用します:
// 地域別に売上をピボット
let
    Source = Excel.CurrentWorkbook(){[Name="DetailedSales"]}[Content],
    Pivoted = Table.Pivot(Source, List.Distinct(Source[Region]), "Region", "Amount", List.Sum)
in
    Pivoted
クエリのマージとアペンド
複数ソースからのデータ結合は、Power Queryが手動作業を削減する場面です。マージは一致する列に基づいて2つのテーブル間で結合を実行します。アペンドはテーブルを垂直にスタックします。
// 左外部結合: OrdersとCustomerの詳細
let
    Orders = Excel.CurrentWorkbook(){[Name="Orders"]}[Content],
    Customers = Excel.CurrentWorkbook(){[Name="Customers"]}[Content],
    Merged = Table.NestedJoin(Orders, {"CustomerID"}, Customers, {"ID"}, "CustomerDetails", JoinKind.LeftOuter),
    Expanded = Table.ExpandTableColumn(Merged, "CustomerDetails", {"Name", "Email"})
in
ExpandedTable.NestedJoin関数は、一致する行を含むネストされたテーブル列を作成します。Table.ExpandTableColumn関数がネストされた構造を通常の列にフラット化します。結合の種類にはInner、LeftOuter、RightOuter、FullOuter、LeftAnti、RightAntiがあります。
Table.Combineでのアペンドには一致する列名が必要です。スキーマが異なる場合、結合前に各ソースでTable.SelectColumnsを使用して一貫性を確保します:
// 一貫した列で2つの売上テーブルをアペンド
let
    Sales2024 = Table.SelectColumns(Source2024, {"Date", "Product", "Amount"}),
    Sales2025 = Table.SelectColumns(Source2025, {"Date", "Product", "Amount"}),
    Combined = Table.Combine({Sales2024, Sales2025})
in
    Combined
カスタム列と条件ロジック
「列の追加 > カスタム列」機能により、M式を使用した計算フィールドが可能になります。条件ロジックはif-then-else構文を使用します。
// 条件ロジックで計算列を追加
let
    Source = Excel.CurrentWorkbook(){[Name="Orders"]}[Content],
    AddedColumn = Table.AddColumn(Source, "OrderCategory", each
        if [Amount] >= 10000 then "Enterprise"
        else if [Amount] >= 1000 then "Business"
        else "Consumer",
        type text
    )
in
AddedColumnif式にはthenとelseの両方のブランチを含める必要があります。ネストされた条件はelse ifでチェーンします。最後のパラメータは列の型を指定し、パフォーマンスを向上させ、型推論の問題を防ぎます。
複雑な変換では、letブロックで定義されたヘルパー関数によりコードが読みやすくなります:
let
    // 会計四半期用のヘルパー関数
    GetFiscalQuarter = (date as date) as text =>
        let
            month = Date.Month(date),
            fiscalQ = if month >= 4 and month <= 6 then "Q1"
                     else if month >= 7 and month <= 9 then "Q2"
                     else if month >= 10 and month <= 12 then "Q3"
                     else "Q4"
        in
            fiscalQ,

    Source = Excel.CurrentWorkbook(){[Name="Transactions"]}[Content],
    AddedQuarter = Table.AddColumn(Source, "FiscalQuarter", each GetFiscalQuarter([Date]), type text)
in
    AddedQuarter
Power Queryでのエラー処理
変換エラーは、クエリ全体を失敗させるのではなく、セル内で「Error」値として表示されます。try-otherwise構文はエラーを適切に処理します:
// 除算エラーの可能性を処理
let
    Source = Excel.CurrentWorkbook(){[Name="Metrics"]}[Content],
    AddedRatio = Table.AddColumn(Source, "Ratio", each
        try [Value1] / [Value2] otherwise null,
        type number
    )
in
AddedRatiotryキーワードは式を試行し、HasErrorとValueフィールドを持つレコードを返します。otherwise句はHasErrorがtrueの場合にフォールバックを提供します。より詳細な制御には、try Expressionでエラーの詳細にアクセスできます:
// エラーの詳細をキャプチャ
let
    result = try SomeRiskyFunction(),
    output = if result[HasError] then "Error: " & result[Error][Message] else result[Value]
in
    output
データアナリスト向けPower Query面接質問
面接官は、実践的なスキルとPower Queryがワークフローに適合する場面の理解の両方を評価します。以下の質問がデータアナリストの面接でよく出題されます。
クエリ折りたたみとは何か、なぜ重要なのか?
クエリ折りたたみは、Power Queryの変換をデータソースのネイティブクエリに変換します。SQL Serverに接続している場合、フィルターステップはサーバーで実行されるWHERE句になり、ネットワーク転送が削減されます。すべての変換が折りたたまれるわけではありません:カスタムM関数、特定の日付操作、および折りたたみ不可能なステップの後の操作はチェーンを中断します。ステップを右クリックして「ネイティブクエリを表示」を探すことで折りたたみ状態を確認できます。
Power Queryはデータ変換においてExcel数式とどう異なるか?
Excel数式はワークシート内でセルごとに操作し、すべての変更で再計算されます。Power Queryはワークシートに到達する前にテーブルに対して操作し、更新中にデータを一括処理します。アンピボット、重複排除、ファイルのマージなどの変換では、Power Queryはネストされたindex-matchやヘルパー列よりも直接的にロジックを表現します。
ETLにPower BIではなくPower Queryを選択するのはいつか?
Excel内のPower Queryは、アナリストがアドホック分析、ピボットテーブル、またはPower BIにアクセスできないユーザーとの共有のためにスプレッドシート形式で変換されたデータを必要とするシナリオに適しています。Power BIはより豊富な視覚化、より大きなデータ容量、およびエンタープライズ共有機能を提供します。同じMコードが両方のツールで動作するため、Excelで開発されたクエリは書き直しなしにPower BI Desktopに移行できます。
テーブルをアペンドする際のデータ型の不一致をどのように処理するか?
Table.Combineで結合する前に、各ソーステーブルに明示的な型を設定します。列が一方のソースでテキスト、もう一方で数値の場合、アペンドは失敗するかエラーを生成します。両方のソースでTable.TransformColumnTypesを使用して一貫した型を強制します。try-otherwiseパターンは、特定の値で変換が失敗するエッジケースを処理します。
Power QueryのMergeとAppendの違いを説明してください。
Mergeは、一致するキー列に基づいて水平結合を実行します。SQL JOINに似ています。Appendは複数のテーブルから行の垂直結合を実行します。SQL UNION ALLに似ています。Mergeにはマッチングのために少なくとも1つの共通列が必要です。Appendでは、列名が同じである必要があり、正しく整列します。
Power Queryスキルを補完するSQL概念についてさらに深く準備するには、SQLウィンドウ関数モジュールでランキングと集計パターンを、SQLサブクエリとCTEモジュールでクエリ構造化テクニックを確認できます。
読み込みオプションと更新戦略
変換後、「閉じて読み込む」ボタンは読み込みの選択肢を提供します:ワークシートテーブルへの読み込み、データモデル(Power Pivot)のみへの読み込み、または接続専用クエリの作成です。接続専用クエリは、ワークシートのスペースを消費せずに他のクエリのステージングステップとして機能します。
更新動作は読み込み先によって異なります。ワークシートテーブルは「すべて更新」ボタンで更新するか、ファイルを開いたときに更新するように設定できます。データモデルテーブルはワークブックのデータモデル更新サイクルに参加します。外部データベースに接続されたクエリでは、保存された資格情報がない限り、更新時に資格情報のプロンプトが表示される場合があります。
バックグラウンド更新により、データ読み込み中もワークブックが使用可能になりますが、下流の数式が更新されたデータに依存している場合は複雑さが生じます。クエリプロパティの「バックグラウンド更新を有効にする」オプションがこの動作を制御します。重要なレポートでは、バックグラウンド更新を無効にすることで順次実行が保証されます。
大規模データセットのパフォーマンス考慮事項
Power Queryは数百万行を処理できますが、ワークブックの応答性はデータの読み込み方法によって異なります。ワークシートテーブルではなくデータモデルに読み込むことで、Excelの行制限を回避し、ピボットテーブルのパフォーマンスが向上します。不要な列を早期に削除することでメモリフットプリントが削減されます。
数分かかるクエリの場合、クエリエディターの「データプレビュー」はサンプルのみを表示します。変換は更新中に完全なデータセットに適用されます。プレビューで表示されるエラーは問題を示しますが、一部のエラーは完全なデータでのみ表示されます。サブセットでテスト更新を実行することで、すべてを処理する前にクエリを検証できます。
多くのファイルを統合する場合、Power Queryのバイナリ結合機能はファイルを並列処理します。1つのファイルを変換する関数を定義し、ファイルリストの各行に対してそれを呼び出すことで、デフォルトの結合アプローチよりも多くの制御が可能になります。
MicrosoftのPower Queryベストプラクティスドキュメントでは、クエリ依存関係構造やバッファ使用法を含む最適化テクニックについて詳しく説明されています。
繰り返し可能なETLパイプラインのためのPower Query
Power Queryで記録されたステップは、変換ロジックのドキュメントを作成します。要件が変更された場合、ステップを変更するとすべての下流ステップが自動的に更新されます。これは、ソースデータが変更されたときに最初から再作成する必要があるアドホックなExcel操作とは対照的です。
チームは接続をエクスポートするか、クエリのMコードをバージョン管理に保存することでクエリを共有できます。詳細エディター(表示 > 詳細エディター)は完全なMスクリプトを表示し、別のワークブックにコピー&ペーストできます。エンタープライズシナリオでは、Power BIデータフローとFabricが集中管理されたクエリ管理を提供します。
- Power Queryは記録された繰り返し可能な変換ステップを使用してExcel内でETLを処理します
- ビジュアルインターフェースの基礎となるM言語はリボンコマンドを超えたカスタマイズを可能にします
- クエリ折りたたみはフィルターとプロジェクションをソースデータベースにプッシュしてパフォーマンスを向上させます
- Mergeはテーブル間の結合を実行し、Appendはテーブルを垂直にスタックします
- 型の割り当てとエラー処理により、サイレントなデータ品質の問題を防ぎます
- 接続専用クエリはワークシート出力なしで再利用可能なステージングステップを作成します
- 面接質問はクエリ折りたたみ、数式の比較、MergeとAppendの区別に焦点を当てます
今すぐ練習を始めましょう!
面接シミュレーターと技術テストで知識をテストしましょう。
Data Analytics のバグを見つけられますか
実際のコード、隠れたバグ、1日1回。アカウントなしで試せます。
執筆
Anthony Fillion-MailletSharpSkill 創業者
10 年以上フルスタック開発に携わっています。SharpSkill を運営し、ここで公開される内容に責任を負っています。
2026年9月20日 更新
共有
関連記事
データアナリスト面接対策2026年版:SQL・Python・分析スキル完全ガイド
2026年のデータアナリスト面接で頻出するSQL、Python、統計分析の質問と模範解答を徹底解説。実践的なコード例と解答のポイントで内定獲得を目指す。
2026年イタリアのデータアナリスト面接対策:SQL、Python、ケーススタディの実践ガイド
2026年イタリア企業のデータアナリスト面接で問われるSQL・Python・ケーススタディの質問と対策を解説。ミラノ・ローマの採用プロセスと給与相場も紹介。
Polars vs Pandas 2026年比較:パフォーマンス、構文、データアナリスト面接対策
2026年におけるPolarsとPandasの詳細比較。ベンチマーク結果、構文の違い、メモリ効率、そしてデータアナリスト面接で頻出する質問と回答例を解説します。