2026'da SRE İlkeleri: Güvenilirlik Mühendisliği, SLO'lar ve Mülakat Soruları
2026 için SRE ilkeleri: SLI seçimi, SLO belirleme, hata bütçesi hesaplama, Prometheus'ta çoklu pencereli burn rate alarmları yazma ve her mülakat sürecinde karşılaşılan SRE sorularını yanıtlama.
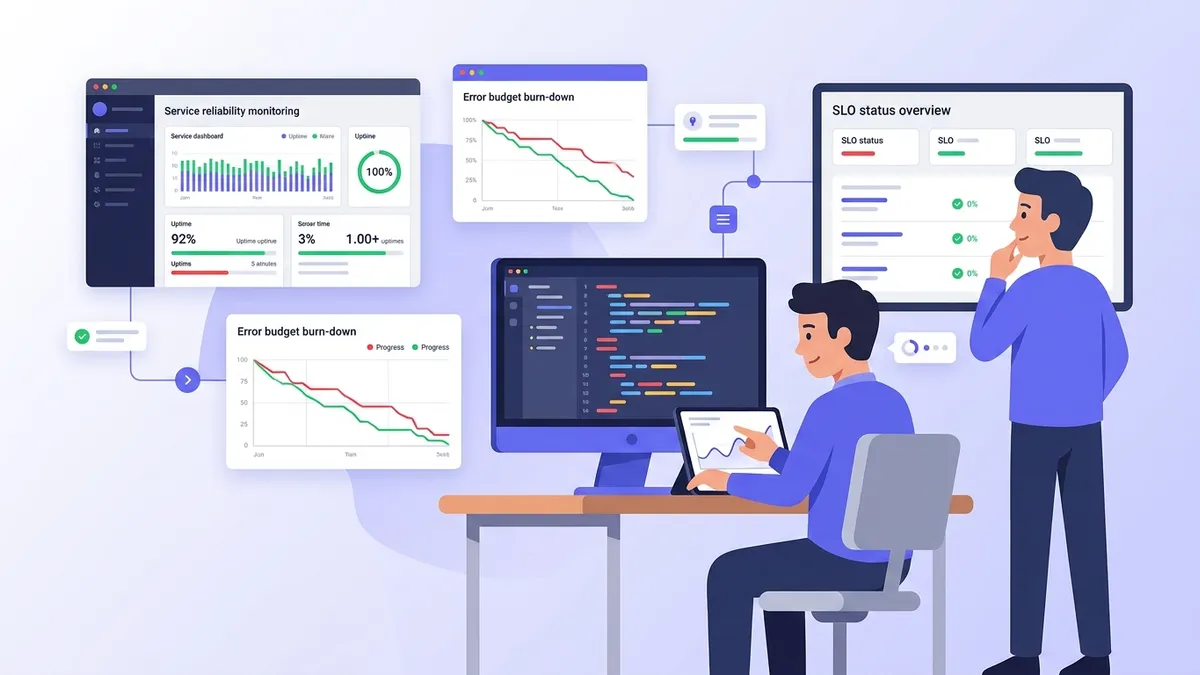
SRE ilkeleri, güvenilirliği belirsiz bir hedef olmaktan çıkarıp mühendislik ve ürün ekiplerinin üzerinde uzlaştığı somut bir sayıya dönüştürür. Bu sayı daha sonra ne zaman yeni sürüm çıkarılacağına ve ne zaman durulacağına karar vermek için kullanılır. Google tarafından tanımlanan ve bugün platform ekiplerinin büyük çoğunluğunda uygulanan site reliability engineering birkaç temel fikre dayanır: kullanıcının deneyimlediği şeyi ölçmek (SLI), hedefi %100'ün altında belirlemek (SLO), aradaki farkı hata bütçesi (error budget) olarak harcamak ve sistemleri ayakta tutan manuel işi sınırlamak. 2026 yılındaki SRE mülakat soruları tam olarak bu fikirleri sınar ve çoğu zaman adaydan gerçek bir servis için SLO tanımlamasını ve onu koruyan alarmı yazmasını ister.
SLI bir ölçümdür: başarılı isteklerin tüm isteklere oranı gibi, iyi olayların geçerli olaylara oranıdır. SLO, bu oran için belirli bir zaman penceresindeki iç hedeftir; örneğin 30 günde %99,9. SLA ise müşteriye verilen, cezai yaptırımları olan sözleşmesel taahhüttür ve her zaman SLO'dan daha gevşektir.
Site reliability engineering'in temel SRE ilkeleri
Google SRE kitabı güvenilirliği maliyeti olan bir ürün özelliği olarak ele alır. Eklenen her "dokuz" daha fazla mühendislik zamanına mal olur ve sürümleri yavaşlatır. Buna karşın kullanıcılar %99,99 ile %99,999 arasındaki farkı nadiren fark eder, çünkü kendi ağları, cihazları ve internet sağlayıcıları bu seviyeden daha az güvenilirdir. Amaç azami güvenilirlik değil, doğru güvenilirlik seviyesidir.
Bu başlangıç noktasından birkaç ilke doğar:
- Güvenilirlik kullanıcı tarafından ölçülür. CPU kullanımı ve pod yeniden başlatmaları nedendir. Başarısız ödemeler ve yavaş yüklenen sayfalar ise kullanıcının yaşadığı sonuçtur ve SLI'ın yakaladığı şey de budur.
- %100 yanlış bir hedeftir. %100'lük bir SLO her türlü değişikliği yasaklar, çünkü her dağıtım risk taşır. %100'ün altındaki boşluk hata bütçesidir ve sürümlere, deneylere ve geçişlere harcanmak için vardır.
- Toil sınırlandırılır. Google'ın toil'i ortadan kaldırma bölümündeki yönergesi, operasyonel işi bir SRE'nin zamanının %50'sinin altında tutar. Toil; manuel, tekrarlayan, otomatikleştirilebilir ve servisle doğrusal olarak büyüyen iştir. Kalan zaman, toil'i ortadan kaldıran mühendislik çalışmalarına ayrılır.
- Postmortem'ler suçlamasızdır. Bir olay incelemesi, komutu kimin yazdığını değil, sistemde neyin bu arızaya izin verdiğini sorar. Suçlanan bir mühendis bilgiyi saklar; suçlamasız bir inceleme ise bilgiyi açığa çıkarır.
- İzleme belirtiler üzerinden alarm üretir. Nöbetçiye çağrı (page), tek bir düğüm olağan dışı göründüğünde değil, kullanıcılar zarar gördüğünde ya da görmek üzereyken gider.
Mülakatta deneyimli bir SRE'yi yalnızca kitabı okumuş birinden ayıran nokta genellikle ikinci maddedir. Junior seviyedeki bir yanıt hata bütçesini arızaya karşı bir tolerans olarak görür. Senior seviyedeki bir yanıt ise onu sürüm yönetimi aracı olarak ele alır: ürün ve güvenilirlik ekiplerinin görüşlerle değil, verilerle tartışmasını sağlayan mekanizmadır.
Kullanıcı deneyimini yansıtan SLI'ların seçimi
İyi bir SLI, 0 ile 1 arasında bir orandır ve kullanıcının tanıyabileceği olaylardan hesaplanır. SRE workbook servis türüne göre kısa bir liste önerir:
| Servis türü | Tipik SLI'lar | Nerede ölçülür |
|---|---|---|
| İstek tabanlı API | Erişilebilirlik, gecikme | Load balancer veya ingress logları, sunucu metrikleri |
| Veri hattı (pipeline) | Tazelik, doğruluk, kapsam | Pipeline çıktı zaman damgaları, doğrulama işleri |
| Depolama sistemi | Dayanıklılık, okuma ve yazma gecikmesi | Depolama katmanı, sentetik problar |
| Frontend | Sayfa yükleme süresi, tarayıcının gördüğü hata oranı | Real user monitoring |
Load balancer seviyesinde ölçüm yapmak, uygulamanın hiç görmediği arızaları yakalar; örneğin çöken ve hiçbir yanıt döndürmeyen bir pod. Tarayıcıda ölçüm yapmak CDN ve DNS sorunlarını yakalar, ancak zayıf mobil bağlantılardan kaynaklanan gürültü ekler. Ekiplerin çoğu, veri zaten orada bulunduğu için load balancer veya ingress ile başlar.
Prometheus ile bir HTTP servisi için iki klasik SLI vardır: erişilebilirlik oranı ve gecikme oranı. Gecikme SLI'ı, belirli bir eşikten hızlı yanıtlanan istekleri iyi olarak sayar; böylece bir yüzdelik (percentile) değil, diğerleri gibi bir oran olur.
# checkout-sli.promql
# Availability SLI: share of requests that did not fail with a 5xx
sum(rate(http_requests_total{job="checkout-api", code!~"5.."}[5m]))
/
sum(rate(http_requests_total{job="checkout-api"}[5m]))

# Latency SLI: share of requests served in under 300 ms
# Uses the histogram bucket with le="0.3", so 0.3 must be a configured bucket boundary
sum(rate(http_request_duration_seconds_bucket{job="checkout-api", le="0.3"}[5m]))
/
sum(rate(http_request_duration_seconds_count{job="checkout-api"}[5m]))
Mülakatlarda iki ayrıntı sıkça gündeme gelir. Birincisi, 4xx yanıtları genellikle geçerli ama iyi olarak sayılır, çünkü 404 veya bir doğrulama hatası istemcinin hatasıdır; bunları arıza olarak saymak, hatalı davranan bir istemcinin bütçeyi tüketmesine yol açar. İkincisi, gecikme eşiği bir histogram bucket sınırıyla eşleşmelidir; aksi halde sorgu hiçbir şey döndürmez ya da sessizce yanlış bucket'ı kullanır. 5 Kasım 2026'da yayınlanan Prometheus 3.16, sabit bucket kısıtını kaldıran native histogram'ları destekler, ancak bunların scrape tarafında etkinleştirilmesi gerekir.
SLO hedeflerinin belirlenmesi ve hata bütçesinin hesaplanması
Bir SLO; bir SLI'ı, bir hedefi ve bir zaman penceresini birleştirir. Pencere genellikle kayan (rolling) bir pencere olup 28 veya 30 gündür; böylece bütçe ayın ilk günü sıfırlanmak yerine kademeli olarak toparlanır. Hedef, bir sunum slaytında iyi görünen değere göre değil, geçmiş performansa ve kullanıcı beklentilerine göre seçilir.
Aşağıdaki tablo, her hedefin 30 günlük pencerede neye izin verdiğini gösterir. Hesap basit aritmetiktir: bütçe (1 - SLO) × 30 gün olarak bulunur.
| SLO hedefi | Hata bütçesi | 30 günde izin verilen toplam kesinti |
|---|---|---|
| %99 | %1 | 7 sa 12 dk |
| %99,5 | %0,5 | 3 sa 36 dk |
| %99,9 | %0,1 | 43 dk 12 sn |
| %99,95 | %0,05 | 21 dk 36 sn |
| %99,99 | %0,01 | 4 dk 19 sn |
İstek tabanlı SLO'larda bütçe dakika yerine istek sayısıyla ifade edilir: pencerede 12 milyon istek varsa ve hedef %99,9 ise 12.000 başarısız isteğe izin verilir. İstek tabanlı bütçeler, trafiği dengesiz olan servisler için daha adildir, çünkü gece 3'teki bir kesinti, yoğun saatteki aynı kesintiden daha az bütçe tüketir.
Yaygın bir mülakat görevi, kalan bütçeyi ve bütçenin ne kadar hızlı tüketildiğini hesaplamaktır. Aşağıdaki betik, soru kod istediğinde beklenen türden bir yanıttır.
# error_budget.py
from dataclasses import dataclass

@dataclass
class SloWindow:
    objective: float      # 0.999 for a 99.9% SLO
    window_days: int      # rolling window, usually 28 or 30
    total_requests: int   # valid events seen in the window so far
    failed_requests: int  # bad events seen in the window so far

    @property
    def budget_fraction(self) -> float:
        return 1 - self.objective  # 0.001 for 99.9%

    def budget_remaining(self) -> float:
        """1.0 means untouched, 0 means spent, negative means SLO breached."""
        allowed_failures = self.budget_fraction * self.total_requests
        return 1 - self.failed_requests / allowed_failures

    def burn_rate(self, recent_errors: int, recent_total: int) -> float:
        """1.0 means the budget lasts exactly the window; 10 means ten times too fast."""
        return (recent_errors / recent_total) / self.budget_fraction

    def hours_to_exhaustion(self, burn: float) -> float:
        # Remaining share of budget, consumed at `burn` times the sustainable pace
        return self.budget_remaining() * self.window_days * 24 / burn

slo = SloWindow(objective=0.999, window_days=30, total_requests=12_000_000, failed_requests=7_800)
burn = slo.burn_rate(recent_errors=240, recent_total=16_000)
print(f"budget left: {slo.budget_remaining():.0%}")             # 35%
print(f"burn rate: {burn:.1f}")                                 # 15.0
print(f"exhausted in: {slo.hours_to_exhaustion(burn):.1f} h")   # 16.8 h
15'lik bir burn rate, SLO %0,1'e izin verirken servisin isteklerin %1,5'inde başarısız olduğu anlamına gelir. Bu hızla kalan %35'lik bütçe 17 saatten kısa sürede biter; bu da birini uykusundan uyandırmayı haklı kılar.
DevOps mülakatlarında başarılı olmaya hazır mısın?
İnteraktif simülatörler, flashcards ve teknik testlerle pratik yap.
Çoklu pencereli burn rate alarmları
Doğrudan SLI üzerinden alarm kurmak ("hata oranı %0,1'in üzerinde") her kısa sıçramada çağrı üretir ve yavaş sızıntıları kaçırır. SRE workbook'un SLO tabanlı alarmlar bölümü bunun yerine çoklu pencereli ve çoklu burn rate'li alarmları önerir. Her alarm tek bir soruya yanıt verir: bütçe, biri ona bakmadan önce tükenecek kadar hızlı mı harcanıyor?
30 günlük pencere için referans eşikler şunlardır:
| Önem derecesi | Uzun pencere | Kısa pencere | Burn rate | Alarm tetiklendiğinde tüketilen bütçe |
|---|---|---|---|---|
| Page | 1 sa | 5 dk | 14,4 | %2 |
| Page | 6 sa | 30 dk | 6 | %5 |
| Ticket | 3 gün | 6 sa | 1 | %10 |
Uzun pencere anlamlılık sağlar: tek bir kötü dakika nöbetçiyi uyandırmaz. Uzun pencerenin on ikide biri olan kısa pencere ise olay sona erdiğinde alarmın hızla sıfırlanmasını sağlar; böylece düzeltmeden sonra bir saat boyunca çağrı gelmeye devam etmez. Her iki koşulun aynı anda doğru olması gerekir.
İlk blok, alarm ifadelerinin ucuz kalması için her penceredeki hata oranını recording rule olarak kaydeder. İkinci blok, bütçe oranının 0,001 olduğu %99,9'luk bir SLO için iki page alarmını tanımlar.
# checkout-slo-recording.rules.yml
groups:
  - name: checkout-slo-recording
    interval: 30s
    rules:
      - record: slo:sli_error:ratio_rate5m
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[5m]))
          / sum(rate(http_requests_total{job="checkout-api"}[5m]))
      - record: slo:sli_error:ratio_rate1h
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[1h]))
          / sum(rate(http_requests_total{job="checkout-api"}[1h]))
# Same pattern for 30m and 6h, omitted for brevity# checkout-slo-alerts.rules.yml
groups:
- name: checkout-slo-alerts
rules:
- alert: CheckoutErrorBudgetFastBurn
# 2% of the monthly budget spent in one hour
expr: |
slo:sli_error:ratio_rate1h > (14.4 * 0.001)
and slo:sli_error:ratio_rate5m > (14.4 * 0.001)
labels:
severity: page
annotations:
summary: "checkout-api burns its error budget 14x too fast"
- alert: CheckoutErrorBudgetSlowBurn
# 5% of the monthly budget spent in six hours
expr: |
slo:sli_error:ratio_rate6h > (6 * 0.001)
and slo:sli_error:ratio_rate30m > (6 * 0.001)
labels:
severity: pageBu kuralları her servis için elle yazmak kısa sürede tekrara dönüşür. Açık kaynaklı bir SLO üreticisi olan Sloth, kısa bir tanımı alır ve yukarıdaki recording rule'ları ve çoklu burn rate alarmlarını üretir. {{.window}} yer tutucusu, Sloth'un ihtiyaç duyduğu her pencereyle değiştirilir.
# checkout-slo.sloth.yml
version: "prometheus/v1"
service: "checkout-api"
labels:
  owner: "payments-team"
slos:
  - name: "requests-availability"
    objective: 99.9
    description: "Checkout requests that do not fail with a 5xx"
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="checkout-api",code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="checkout-api"}[{{.window}}]))
    alerting:
      name: CheckoutHighErrorRate
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
          severity: ticket
Sağlayıcıdan bağımsız bir format arayan ekipler, SLO'ları izleme altyapısından bağımsız olarak YAML ile tanımlayan OpenSLO spesifikasyonuna yönelir.
Hata bütçesi politikası ve sürüm kararları
Politikası olmayan bir hata bütçesi, kimsenin üzerine harekete geçmediği bir dashboard'dan ibarettir. SRE workbook'taki örnek hata bütçesi politikası, bütçe tükendiğinde ne olacağını ve bunu önceden kimin onayladığını açıkça yazar.
Tipik bir politika şunları içerir:
- Tetikleyici. Servis, kayan pencere boyunca hata bütçesini aşmıştır.
- Sonuç. Güvenlik düzeltmeleri ve güvenilirliği artıran değişiklikler dışında, servis SLO sınırlarına geri dönene kadar yeni özellik sürümleri durdurulur.
- İstisna yolu. Ekibin kontrolü dışındaki bir bağımlılıktan kaynaklanan tek bir olay, kararın belgelenmesi şartıyla hesaplamanın dışında tutulabilir.
- Eskalasyon. Anlaşmazlıklar en yüksek sesle tartışan kişiye değil, CTO gibi adı belirlenmiş bir role gider.
Politika, ilk ihlalden önce ürün ve mühendislik tarafından imzalanır ve asıl mesele de budur: sürüm dondurma, bir olay sırasında yaşanan bir kavga yerine önceden kararlaştırılmış bir kurala dönüşür. Mülakatçılar sıklıkla bütçe sürekli olarak hiç harcanmadığında ne olduğunu sorar. Beklenen yanıt, SLO'nun fazla gevşek olabileceği ya da ekibin aşırı temkinli sürüm çıkardığı, bu durumda bütçenin daha hızlı sürümlere veya daha riskli geçişlere harcanması gerektiğidir.
İç SLO'yu müşteriye verilen SLA ile eşit belirlemek hiçbir pay bırakmaz: SLO'nun ilk ihlali zaten sözleşmesel bir ceza anlamına gelir. SLO, SLA'dan daha katı olmalıdır; böylece sözleşme hâlâ karşılanırken alarmlar tetiklenir ve sürüm dondurma başlar.
Toil azaltma, nöbet ve suçlamasız postmortem'ler
SRE zamanı operasyon ve mühendislik arasında bölünür. Operasyon; nöbet (on-call), ticket'lar ve manuel müdahaleleri kapsar. Mühendislik ise otomasyon, kapasite planlaması ve güvenilirlik özelliklerini kapsar. Toil %50 yönergesini aştığında SRE ekibi işi geliştirme ekibine geri iter ya da otomasyona yatırım yapar; aksi halde ekip yeni bir unvan taşıyan bir operasyon ekibine dönüşür.
Nöbet sağlığı varsayılmaz, ölçülür. Faydalı sinyaller; vardiya başına çağrı sayısı, aksiyon gerektiren çağrıların oranı ve onaylama süresidir. Hiçbir aksiyon gerektirmeyen bir çağrı, alarm sistemindeki bir hatadır ve düzeltilir ya da silinir. Yukarıdaki kurallarda olduğu gibi SLO burn rate'ine dayanan belirti odaklı alarmlar, CPU, bellek veya tekil pod yeniden başlatmalarına dayanan alarmlara kıyasla çağrı hacmini belirgin şekilde azaltır.
Bir olay yaşandığında, SRE kitabının postmortem kültürü bölümü ardından gelen incelemeyi tarif eder. Bir postmortem; etkiyi SLO cinsinden (ne kadar bütçe harcandığı), zaman çizelgesini, katkıda bulunan faktörleri ve sahibi ile tarihi belli aksiyon maddelerini kaydeder. Bir kişiyi neden olarak göstermekten kaçınır. Mülakatlarda iki takip sorusu yaygındır: aksiyon maddelerinin gerçekten tamamlandığından nasıl emin olunur (özelliklerle aynı backlog'da takip etmek, düzenli bir toplantıda gözden geçirmek) ve postmortem ne zaman zorunludur (bütçenin önemli bir kısmını tüketen her olay, birini uyandıran her çağrı, her veri kaybı).
SRE kitabındaki dört altın sinyal, yani gecikme, trafik, hatalar ve doygunluk (saturation), izleme resmini tamamlar. Gecikme ve hatalar genellikle SLI'a dönüşür. Trafik ve doygunluk ise çağrılardan çok kapasite planlamasını ve dashboard'ları besler.
Beklenen yanıtlarıyla SRE mülakat soruları
Aşağıdaki sorular SRE ve kıdemli DevOps mülakat süreçlerinde düzenli olarak karşılaşılan sorulardır ve her birinin altında güçlü bir yanıtın özü yer alır. SRE ilkeleri mülakat modülü aynı konular üzerinde pratik yaptırır, alarm ve olay müdahalesi modülü ise nöbet tarafını kapsar.
S: SLI, SLO ve SLA arasındaki fark nedir?
SLI ölçülen orandır, SLO bu oran için bir pencere boyunca belirlenen iç hedeftir, SLA ise cezai yaptırımları olan dış sözleşmedir. SLO, ekibin para kaybedilmeden önce tepki verebilmesi için SLA'dan daha katıdır.
S: SLO neden %100 olarak belirlenmez?
Çünkü her değişiklik risk taşır ve %100'lük bir hedef sürüm çıkarmayı yasaklar. Kullanıcılar ayrıca kendi ağlarının sağladığından daha yüksek bir güvenilirliği algılayamaz. %100'ün altındaki boşluk, sürümleri finanse eden hata bütçesidir.
S: Bir ödeme (checkout) API'si için SLO tanımlayın.
Güçlü bir yanıt iki SLI seçer (4xx hariç erişilebilirlik ve load balancer'da ölçülen, bir eşiğin altındaki gecikme), 30 günlük kayan bir pencere belirler, hedefleri son çeyreğin verilerine dayandırır ve alarmların ile hata bütçesi politikasının bunlardan nasıl türediğini açıklar. Neyin ölçüldüğünü söylemeden yalnızca "%99,99 uptime" demek klasik zayıf yanıttır.
S: p99 gecikme yüzdeliğine dayanan alarmlar neden zayıf bir SLO alarmıdır?
Kısa bir penceredeki p99 gürültülüdür ve instance'lar arasında toplanamaz (aggregate edilemez). Gecikmeyi eşiğin altındaki isteklerin oranına dönüştürmek onu toplanabilir, erişilebilirlik SLI'ı ile karşılaştırılabilir ve burn rate alarmlarıyla uyumlu hale getirir.
S: Burn rate'i ve alarmların neden iki pencere kullandığını açıklayın.
Burn rate, gözlemlenen hata oranının bütçe oranına bölümüdür; 1 değeri bütçenin tam olarak pencere boyunca yeteceği anlamına gelir. Uzun pencere kısa sıçramaları filtreler, kısa pencere ise toparlanmadan sonra alarmın hızla temizlenmesini sağlar.
S: Toil nedir ve nasıl kontrol altında tutulur?
Servisle birlikte ölçeklenen, kalıcı bir değer üretmeyen, manuel, tekrarlayan ve otomatikleştirilebilir iştir. Ölçülür, sınırlandırılır (Google %50 eşiğini kullanır) ve otomasyonla ya da işi servisin sahibi olan ekibe geri devrederek azaltılır.
S: Bir postmortem'i suçlamasız (blameless) yapan nedir?
Arızaya izin veren sistem koşullarına odaklanır, insanların ellerindeki bilgilerle makul davrandığını varsayar ve takip edilen aksiyon maddeleri üretir. Ölçüt basittir: olaya dahil olan mühendis her ayrıntıyı korkmadan paylaşır mıydı?
İzleme soruları, aynı mülakatta genellikle SLO sorularının hemen ardından gelir. Prometheus mülakat soruları rehberi PromQL'i, metrik türlerini ve kardinaliteyi ele alır; DevOps teknoloji sayfası ise daha kapsamlı bir hazırlık için tüm modülleri listeler.
Pratikte SLO'lar ve hata bütçeleri: akılda tutulması gerekenler
- Her SLI, iyi olayların geçerli olaylara oranı olarak tanımlanmalı, verinin izin verdiği ölçüde kullanıcıya yakın ölçülmeli ve çoğu API için 4xx yanıtları arıza sayılmamalıdır
- SLO hedefi geçmiş verilere ve 28 ya da 30 günlük kayan bir pencereye göre seçilmeli, her türlü müşteri SLA'sından daha katı tutulmalıdır
- Hedef dakika veya istek cinsinden bir bütçeye çevrilmeli ve rakamlar ezbere bilinmelidir: 30 günde %99,9, 43 dakika demektir
- Alarmlar ham hata oranına veya CPU'ya değil, eşleştirilmiş pencerelerle burn rate'e dayanmalıdır (1 sa ve 5 dk için 14,4; 6 sa ve 30 dk için 6)
- Birkaç servisten fazlasında SLO olduğunda eşiklerin tutarlı kalması için kurallar Sloth veya benzeri bir araçla üretilmelidir
- Hata bütçesi politikası, dondurma kuralı ve eskalasyon yolu dahil olmak üzere ilk ihlalden önce yazılıp imzalanmalıdır
- Toil, çağrı hacmi ve postmortem aksiyon maddeleri, yeni özellikler kadar titizlikle takip edilmelidir
Pratik yapmaya başla!
Mülakat simülatörleri ve teknik testlerle bilgini test et.
DevOps kodundaki hatayı bulabilir misin?
Gerçek bir kod parçası, gizli bir hata, günde bir deneme. Denemek için hesap gerekmez.

Yazan:
Anthony Fillion-MailletSharpSkill kurucusu
10 yılı aşkın süredir fullstack geliştirici. SharpSkill’i yönetiyor ve burada yayımlanan her şeyden sorumlu.
7 Kasım 2026 tarihinde güncellendi
Etiketler
Paylaş
İlgili makaleler

Prometheus Mülakat Soruları 2026: Prometheus vs Grafana vs Datadog Karşılaştırması
DevOps ve SRE rolleri için PromQL, metrik türleri, cardinality ve HA yanıtlarıyla Prometheus mülakat soruları ile mimari, alerting ve fiyatlandırma açısından Prometheus vs Grafana vs Datadog karşılaştırması.
2026'da Freelance DevOps mühendisi işleri: sözleşmeleri nerede bulabilirsiniz, günlük ücretler ve nasıl hazırlanılır
2026 yılında freelance DevOps pazarı rehberi. Sözleşme ilanları platformları, günlük ücretler, gereken beceriler ve teknik mülakatlara hazırlık.
2026'da DevOps Mühendisi İş İlanları: Nerede Aranmalı, Maaş Aralıkları, Nasıl Hazırlanmalı
2026 DevOps iş piyasası için kapsamlı rehber. İlanlar nerede bulunur, maaşlar ne kadardır, gereksinimler nelerdir ve mülakatlara nasıl hazırlanılır.